
从存储引擎到执行算子:KWDB 查询性能调优的原理与实践
KWDB(KaiwuDB 社区版)在 AIoT 场景下用得很广,但它的调优思路和 PostgreSQL 那套差别不小。这篇文章从存储结构一直讲到执行算子,试着回答"一条查询到底慢在哪一层"。
一、KWDB 是什么,以及为什么老经验不管用
1.1 先认识一下 KWDB
KWDB 是浪潮 KaiwuDB 的社区版,2024 年 8 月开源,一个月后捐赠给开放原子开源基金会进入孵化,代码托管在 Gitee 上,定位是面向 AIoT 场景的分布式多模数据库。
所谓多模,就是同一个实例里既能建时序库(CREATE TS DATABASE),也能建关系库(CREATE DATABASE),两套数据用一条 SQL 就能关联查询。它想替掉的是"时序库 + 关系库"的混搭架构(比如 InfluxDB 配 MySQL),省掉中间那层数据同步。
官方给的数字是千万级设备连接、每秒百万级测点写入、每秒亿级测点读取。实际落地集中在能源电力、工业物联网、车联网、数字政务这些场景,共同点是设备多、采集频率高、查询以"按设备、按时间范围做聚合"为主。
支撑这些数字的是双引擎架构,也是理解 KWDB 调优的起点:
- 时序引擎(TS Engine / TS Store):C++ 实现的列式存储,数据按时间分区组织,整套设计为顺序写入服务;
- 关系引擎(KV Store):底层是 RocksDB,走 LSM-Tree + MVCC,擅长事务和点查。
1.2 走出一个优化误区
KWDB 的 SQL 层构建在 CockroachDB 之上(第三节讲执行器时还会碰到这层血统),而 CockroachDB 走的通信协议就是 PostgreSQL 的线协议(pgwire),但是跟 PostgreSQL完全不通
协议兼容只到 SQL 层,兼容不到存储层。KWDB 的查询路径上横着两套物理结构完全不同的存储引擎,一条 SQL 快不快,取决于优化器能不能把过滤和聚合尽量推到数据所在的引擎里执行完,而不是把几千万个原始测点搬到关系引擎再算。
假设要查"某小区最近 24 小时的平均用水量"。小区信息在 KV Store 的关系表里,水表读数在 TS Store 的时序表里。这条 SQL 的性能决定权在数据组织方式上:时序表不走 B+Tree,靠主标签和分区剪枝裁剪范围;shared_buffers 这类参数在双引擎架构里也不是原来那个角色。
所以调优的主线其实就一句话:让扫描范围尽量小,让计算尽量发生在数据旁边。
二、存储层:数据怎么放,决定了怎么查
KWDB 时序数据的目录层级是这样的:
EntityGroup → SubEntityGroup → Partition → Segment → Data Block
每一层都对应一种缩小扫描范围的能力,逐层看。
2.1 EntityGroup / SubEntityGroup
KWDB 会按主标签(Primary Tag)把数据拆进不同的 SubEntityGroup。主标签是能唯一标识一组设备的那一列,所以这个拆分本质上就是按设备做物理分桶。
它带来两个直接后果。一是点查能拿到设备级剪枝,WHERE 里带上主标签的精确匹配,引擎直接奔着对应的 SubEntityGroup 去,其他设备的数据根本不会碰。二是元数据规模可控。
第二点稍微展开一下。SubEntityGroup 这个概念的引入,本身就是为了解决一个矛盾:元数据块(MetaBlock)是预分配的,预留太多用不满就是浪费空间,而 Entity 数量一多,逐个查找又会拖慢性能。把每个 SubEntityGroup 能装的 Entity 数量做成可配置的,就是在"空间浪费"和"查找性能"之间找一个平衡点。设备量很大的时候,这个分桶能避免元数据块过度预留。
顺带说一句,如果你最常用的查询维度是"某个区域"或"某类设备",那它就该进主标签。主标签是建表时定下来的,后面想改成本很高,值得提前想清楚。
2.2 Partition:时间分区
数据按时间戳写进不同的 Partition 目录。时序库和时序表都能指定分区间隔,默认 10 天(对应 ts.partition.interval = 864000 秒)。建库时可以自己定:
-- 按周分区,贴合以周为周期的统计需求
CREATE TS DATABASE iot RETENTIONS 90d PARTITION INTERVAL 7d;
查询时能拿到的是分区剪枝。只要语句里带了时间范围条件,引擎在创建迭代器那一步就能定位到相交的少数几个分区,剩下的压根不打开。
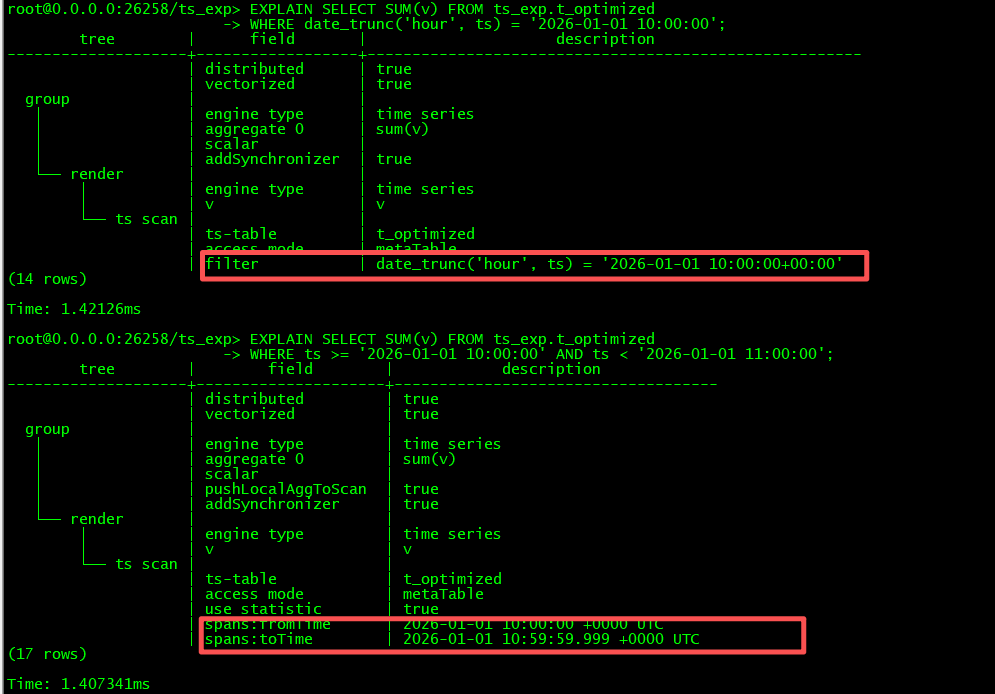
写法上有讲究。时间条件要写成引擎认得的范围形式,比如 ts > now() - INTERVAL '24 hours';如果写成 date_trunc('hour', ts) = '...' 这种在时间列上套了函数再比较的形式,优化器就用不上分区边界信息了。
2.3 Segment
SubEntityGroup 内部,数据按固定行数切成 Segment,默认 100 万行。
这一层的设计动机值得说一下。读写列存文件用的是 mmap,而 mmap 的文件扩容会触发 remap,remap 是要加锁的。按 Segment 把空间一次性预留好,Segment 内部的数据读写就不用加锁了,读写锁冲突随之减少。
每个 Segment 以压缩单元(sqfs)的形式组织,读取时按需 mount,靠惰性挂载加 LRU 卸载来管挂载点,Engine 默认允许 1000 个挂载点。
Segment 大小是个权衡。切大了,单次刷盘带的数据多,写入可见延迟就上去了;切小了,压缩率下降,小块数量还会膨胀。这跟后面要讲的 ts.rows_per_block.* 是同一类问题。
2.4 Data Block:聚合查询的红利所在
列文件里按固定行数组织 Data Block。这里有个容易被忽略的设计:每个 Block 除了存列值,还存了这些值的聚合结果:最大值、最小值、非 NULL 值总数、NULL BitMap。
有了这个,聚合查询的执行路径就短了很多:
MAX、MIN、COUNT这类聚合在 Block 层面就能拿到部分结果,不需要把原始值全部解压出来;- Block 会被 LRU Block Cache 缓存(
ts.block.lru_cache.max_limit,默认 1GB),重复扫同一批数据可以跳过解压。
再配合两个默认开启的开关,效果会更明显:
ts.count.use_statistics.enabled = true   -- COUNT 直接走预计算统计
ts.last_row_optimization.enabled = true  -- last() 走末行缓存
2.5 写入方式和去重,也在影响查询
时序引擎为了把写入做快,用的是"写入不排序、读取时排序、删除用标记"的路子。乱序写入会额外触发小范围排序读取,读取侧就要多花力气。后台会定期做数据排序重组来收拾局面。
去重规则由 ts.dedup.rule 控制,可选 override(默认,整行覆盖)、merge(部分列合并)、discard(保留旧值):
SET CLUSTER SETTING ts.dedup.rule = merge;
这里有个坑。去重逻辑本身需要查询才能判断,但官方对顺序写入做了优化,分区里记着数据的 min/max 时间戳,据此判断是不是顺序写入,顺序写入不进去重逻辑。换句话说,如果你在乱序刷历史数据,去重的开销会结结实实地落到查询路径上。
所以说查询慢,有时候根不在查询。写入乱序破坏了存储的有序性,后面的读取和聚合都会跟着遭殃。写侧影响读侧,这是很典型的例子。
三、执行层:一条 SQL 进来之后发生了什么
存储讲完了,看执行。KWDB 的查询执行层(关系引擎侧,有 CockroachDB 的血统)用的是火山模型迭代器加向量化执行。这里挑三件跟调优关系最大的事说。
3.1 迭代器要把分层的数据合起来
时序查询最后会落到 TsTableIterator,每个 SubEntityGroup 对应一个 TsIterator。读取时数据可能同时来自三个地方:
TsMemSegment:内存里的跳表,最近写入还没落盘的数据TsLastSegment:列存,最近的分段TsEntitySegment:压缩加缓存的持久化分段
Next 是逐 Block 走的,而结果必须保持时间有序,所以引擎要用归并堆把多个有序流合到一起,去重也在合并过程中顺手做了。
这里就有个代价:内存里有未落盘数据时,查询得同时读内存层和磁盘层再归并。ts.mem_segment_size.max_limit(默认 512MB)管的就是内存分段的上限。调大它,写吞吐上去了,但内存分段一大,归并读就更重,写入可见延迟也会拉长。
3.2 向量化执行
SET vectorize = off;
EXPLAIN SELECT * FROM ts_exp.t_optimized
WHERE ts >= '2026-01-01' AND ts < '2026-01-02';
-- 记录:计划形态

SET vectorize = on;
EXPLAIN(VEC) SELECT * FROM ts_exp.t_optimized
WHERE ts >= '2026-01-01' AND ts < '2026-01-02';
-- 记录:计划形态(应出现 colBatchScan 之类批量算子)
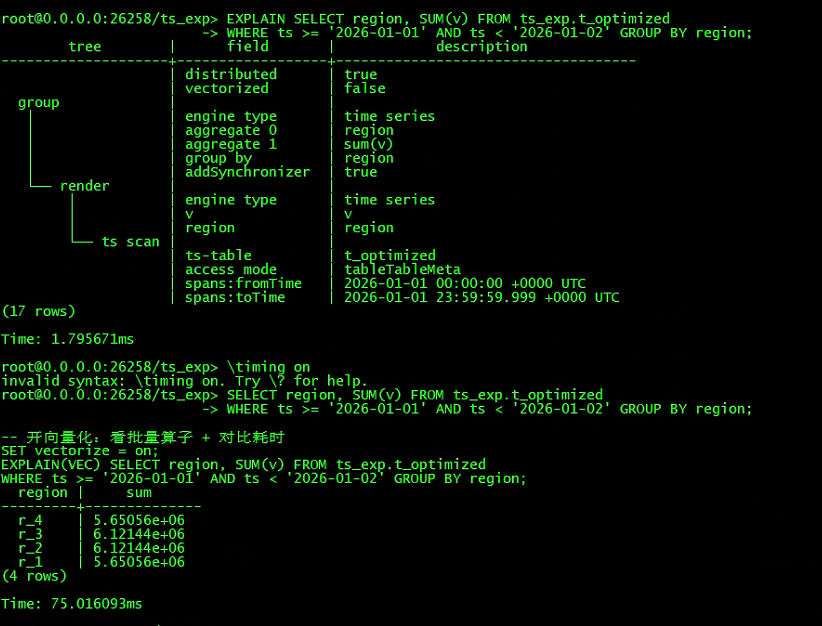
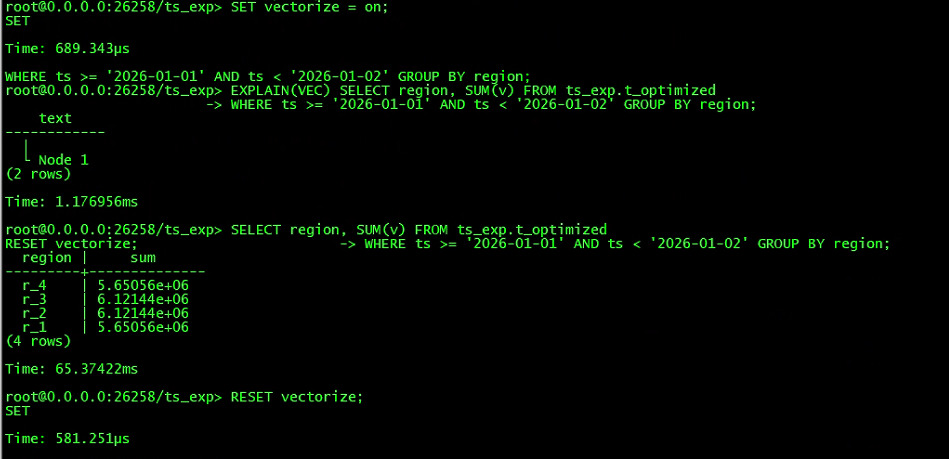
开了之后,处理单位从"一行"变成"一批",函数调用和虚函数分发的开销就被摊薄了。
到这里其实能看出一个组合:列存只读需要的列,向量化一次算一批,Block 统计连原始值都不用解压。三件事叠在一起,才是时序查询速度的完整来源。想验证向量化有没有生效,看 EXPLAIN(VEC) 的输出就行;如果查询涉及不支持的数据类型,会直接报未处理类型错误。
3.3 跨模查询的三项优化
这块是 KWDB 跟普通时序库拉开差距的地方,也是查询调优的大头。跨模查询的瓶颈通常不在算得慢,而是数据在引擎之间搬得太多,KWDB 从三个方向去解。
先说统计信息。传统优化器看不懂时序数据,它不知道某个型号的设备到底对应多少时序数据,很可能先全量扫时序表、再拿去和关系表连,中间结果一下就炸了。KWDB 引入了时序专属的统计项,标签条数、某设备的聚合统计、某设备的时序数据条数等,和关系数据的统计信息放在同一套元数据系统里。优化器能同时看到两侧的分布,连接顺序才有依据。
聚合算子要下推。聚合直接在数据所在的引擎里算完再汇总,比如统计"某区域所有设备的平均温度",就在时序引擎里按区域聚好,只把最终结果传上去,传输量从源头砍掉。
连接侧则有专门的高速跨模算子,思路是用数据裁剪换传输效率。它根据融合后的统计信息和代价估算,自动决定启用与否以及连接顺序;因为时序侧数据量往往大得多,所以先算体量小的关系数据,把结果送到时序引擎里再做连接和聚合;计算按设备维度拆开,多设备并行。
跨模查询快不快,主要看优化器有没有选对连接顺序、有没有把聚合推下去。而它能不能选对,前提是统计信息足够新鲜准确。这一点放到第五节具体说。
四、落到操作
原理讲完,下面是能直接用的手段,看每个手段能带来多少收益
4.1 环境及数据准备
CREATE TABLE accounts (id INT PRIMARY KEY, balance DECIMAL);
INSERT INTO accounts VALUES (1, 10000.00), (2, 250.50), (3, 999.99), (5, 750.25);

CREATE TABLE explain_test (v INT);
INSERT INTO explain_test VALUES (1),(2),(3),(4),(5),(6),(7),(8);

-- 时序表必须建在时序库里,关系表建在关系库里

CREATE TS DATABASE IF NOT EXISTS ts_exp;
CREATE DATABASE IF NOT EXISTS rel_exp;

查询维度 region 不在主标签里
CREATE TABLE ts_exp.t_baseline (
  ts TIMESTAMPTZ NOT NULL, v FLOAT
) TAGS (device_id VARCHAR(32) NOT NULL, region VARCHAR(32) NOT NULL)
PRIMARY TAGS (device_id);

region 设为主标签
CREATE TABLE ts_exp.t_optimized (
  ts TIMESTAMPTZ NOT NULL, v FLOAT
) TAGS (device_id VARCHAR(32) NOT NULL, region VARCHAR(32) NOT NULL)
PRIMARY TAGS (region, device_id);
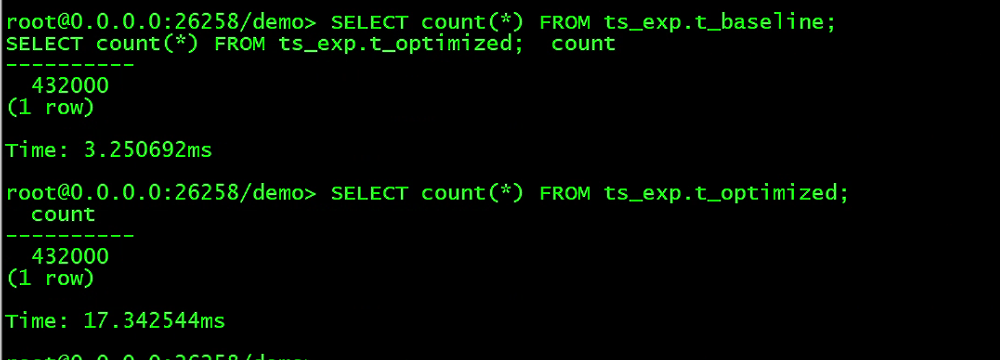
往两张表灌同一份数据。规模:50 台设备 × 4 个区域 × 1 天 × 10 秒间隔,约 43 万行。
INSERT INTO ts_exp.t_baseline (ts, v, device_id, region)
SELECT '2026-01-01'::timestamptz + (t * INTERVAL '10 seconds'),
       10 + (t % 90)::float,
       'dev_' || d::string,
       'r_' || (1 + d % 4)::string
FROM generate_series(1, 50) AS d, generate_series(0, 8639) AS t;

INSERT INTO ts_exp.t_optimized (ts, v, device_id, region)
SELECT '2026-01-01'::timestamptz + (t * INTERVAL '10 seconds'),
       10 + (t % 90)::float,
       'dev_' || d::string,
       'r_' || (1 + d % 4)::string
FROM generate_series(1, 50) AS d, generate_series(0, 8639) AS t;

SELECT count(*) FROM ts_exp.t_baseline;
SELECT count(*) FROM ts_exp.t_optimized;
4.2 先用 EXPLAIN 把计划看懂
调优从看计划开始。KWDB 有 EXPLAIN 和 EXPLAIN ANALYZE。
EXPLAIN SELECT * FROM accounts WHERE id > 2;
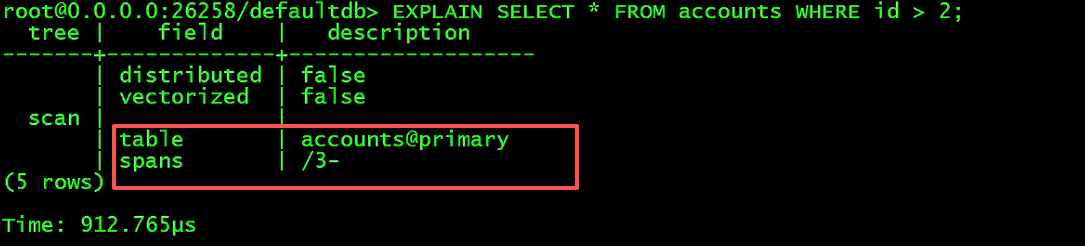
输出里重点盯两个 field:
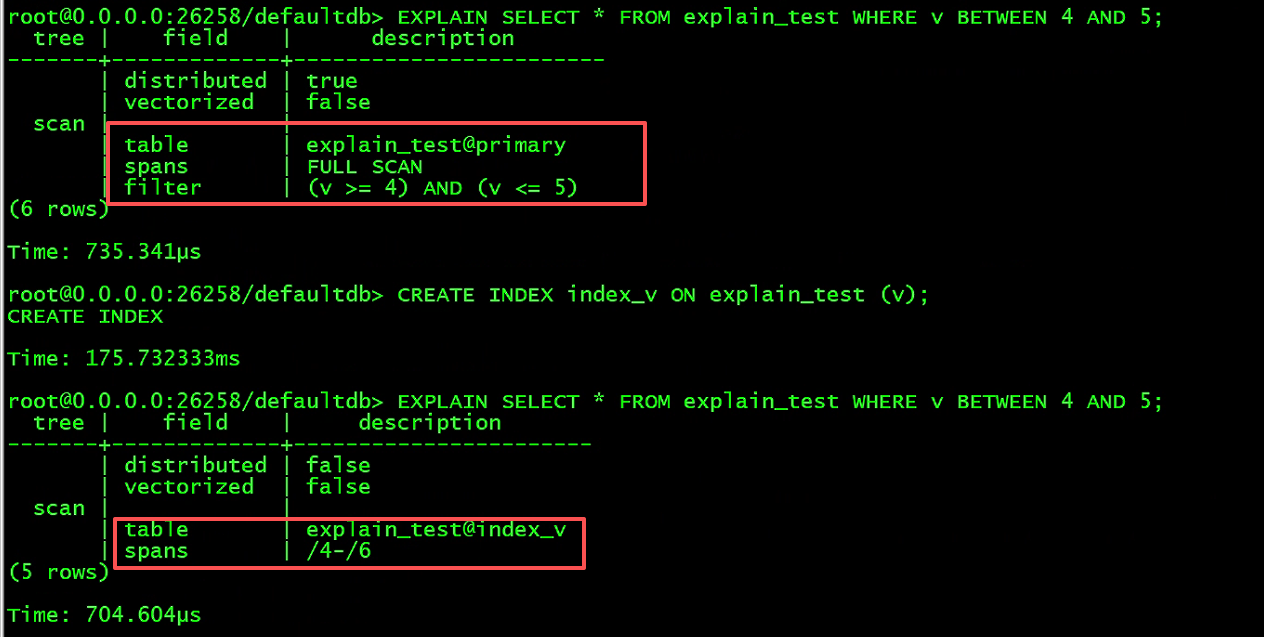
table:实际用了哪个索引,比如accounts@primary还是xxx@index_v;spans:扫描的 Key 范围。如果是FULL SCAN,说明索引没走上,这是最慢的访问方式。
看个官方例子就明白了:
-- v 列没索引,全表扫描
EXPLAIN SELECT * FROM explain_test WHERE v BETWEEN 4 AND 5;
-- spans | FULL SCAN

CREATE INDEX index_v ON explain_test (v);

-- 建完索引,走索引扫描
EXPLAIN SELECT * FROM explain_test WHERE v BETWEEN 4 AND 5;
-- table | explain_test@index_v
-- spans | /4-/6
还想看细一点的话,EXPLAIN(OPT) 能给代价优化器的计划树和代价,EXPLAIN(OPT, VERBOSE) 带每层的行数估算和成本,EXPLAIN(ANALYZE) 生成含各算子实际耗时的诊断包,EXPLAIN(VEC) 看向量化计划。
线上排查慢查询,建议直接上 EXPLAIN ANALYZE(DEBUG) 拿诊断包,它能定位到时间具体花在哪个算子上。日常验证索引效果,EXPLAIN 看 spans 有没有 FULL SCAN 就够了。
4.3 把高频过滤维度设成主标签
时序表的主标签会自动建 Hash 索引,精确匹配是 O(1)。这是时序表上最便宜的加速手段,没有之一。
-- 同一过滤条件跑两张表,对比执行计划
EXPLAIN SELECT SUM(v) FROM ts_exp.t_baseline
WHERE region = 'r_1' AND ts >= '2026-01-01' AND ts < '2026-01-02';

EXPLAIN SELECT SUM(v) FROM ts_exp.t_optimized
WHERE region = 'r_1' AND ts >= '2026-01-01' AND ts < '2026-01-02';
-- 重点看 spans:t_baseline 预期全扫,t_optimized 预期命中主标签裁剪
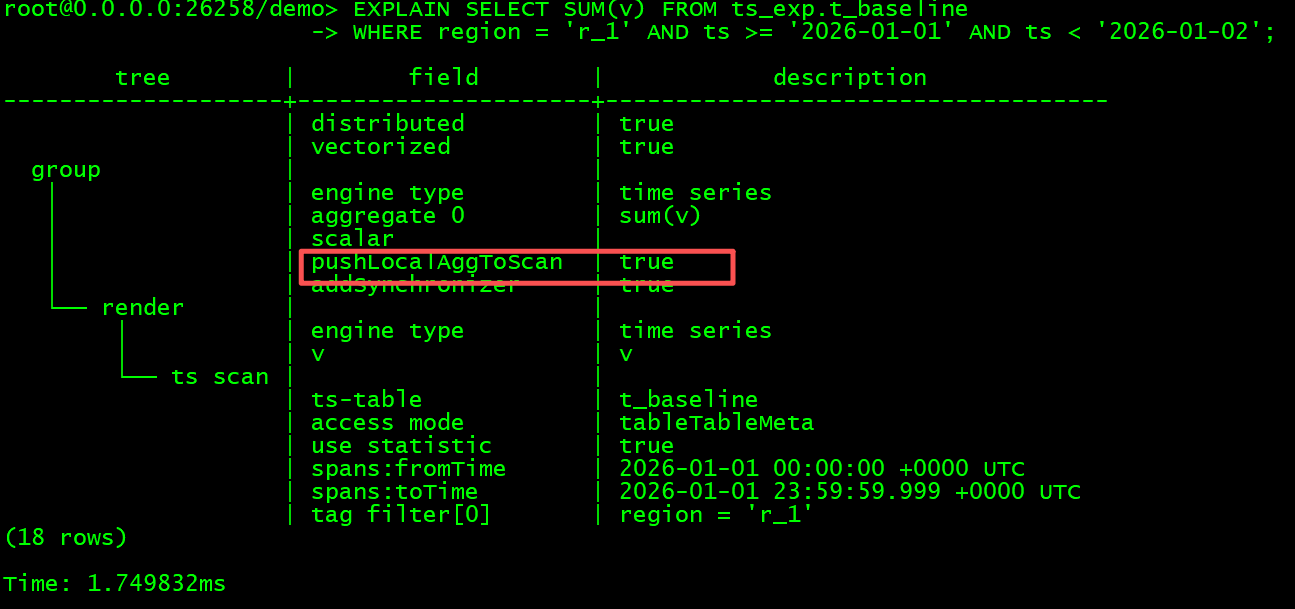
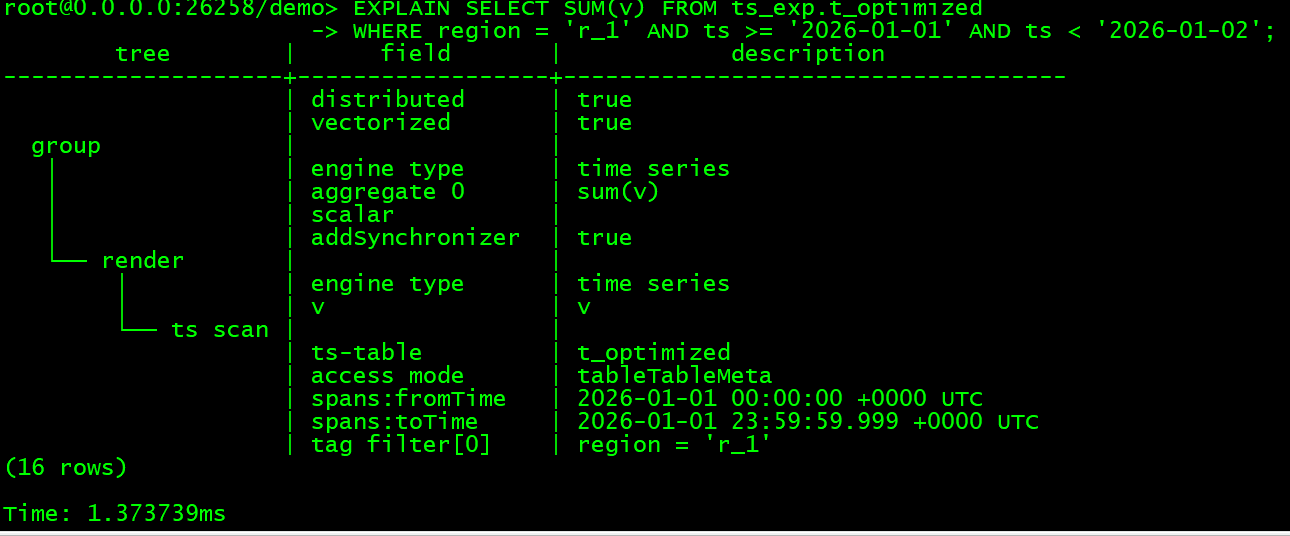
因为 region 不是它的主标签,r_1 的数据散在全部设备的实体里,扫描要碰所有实体逐个过滤,聚合要多路汇总,所以加同步器、把局部聚合压到扫描层;
这里想强调一个认知:本该下推成主标签精确匹配的条件,别写成 JOIN 之后再过滤。同样是 community_id 这个条件,作为主标签直接过滤是在存储层做了一次精准裁剪,而通过关系表 JOIN 进来再过滤,很可能触发时序表全扫。两种写法,执行路径差着量级。
4.4 让时间条件真正参与剪枝
- 时间范围条件写成引擎认得的边界形式;
- 别在时间列上做函数变换再比较;
- 建库建表时按业务周期挑
PARTITION INTERVAL。分区太细,分区元数据会膨胀;太粗,剪枝能省的就少了。按天统计的场景,考虑按天或按周分区。
-- 对照组:时间列套函数,破坏剪枝
EXPLAIN SELECT SUM(v) FROM ts_exp.t_optimized
WHERE date_trunc('hour', ts) = '2026-01-01 10:00:00';

-- 实验组:范围条件,可剪枝
EXPLAIN SELECT SUM(v) FROM ts_exp.t_optimized
WHERE ts >= '2026-01-01 10:00:00' AND ts < '2026-01-01 11:00:00';
4.5 让聚合走预聚合通道
- 优先用
MAX、MIN、COUNT这类能从 Block 统计直接取到部分结果的聚合,而不是需要拉全量原始值再算的算子; - 确认
ts.count.use_statistics.enabled、ts.last_row_optimization.enabled是开着的,让COUNT和last()走快路径; - 复杂聚合留意
work_mem。内存给不够,排序和哈希操作会溢出到磁盘(spill to disk),耗时可能从秒级掉到分钟级。
4.6 通过参数来调优
Block Cache 调整
基线数据构造
# 1) 生成数据
./tsbs_generate_data --use-case="cpu-only" --scale=100 \
  --timestamp-start="2026-01-01T00:00:00Z" \
  --timestamp-end="2026-01-05T00:00:00Z" \
  --log-interval="10s" --format="kwdb" > data.dat

# 2) 导入数据
./tsbs_load_kwdb \
  --file=data.dat \
  --user=banjin \
  --pass=Oracle123 \
  --host=192.168.150.132 \
  --port=26258 \
  --insert-type=prepare \
  --preparesize=1000 \
  --db-name=benchmark \
  --case=cpu-only \
  --workers=12 \
  --partition=false

# 3)
./bin/tsbs_generate_queries --format=kwdb --use-case="cpu-only" \
  --seed=123 --scale=100 --query-type="single-groupby-1-8-1" \
  --queries=1000 --timestamp-start="2026-01-01T00:00:00Z" \
  --timestamp-end="2026-01-05T00:00:01Z" --db-name=benchmark > query.dat

# 4) 执行查询
./tsbs_run_queries_kwdb --file=query.dat --user=banjin --pass=Oracle123 \
  --host=192.168.150.132 --port=26258 --db-name=benchmark --workers=8 > query.log
SHOW CLUSTER SETTING ts.block.lru_cache.max_limit;
SET CLUSTER SETTING ts.block.lru_cache.max_limit = 2147483648;

SET CLUSTER SETTING ts.block.lru_cache.max_limit = 1073741824;
使用tsbs进行测试
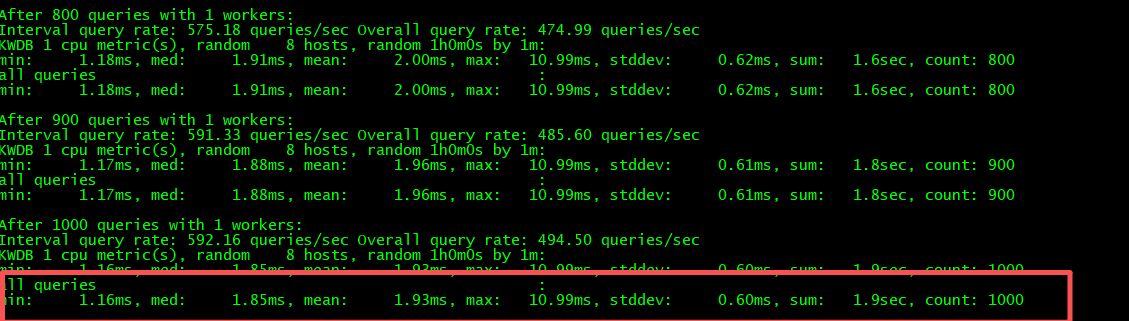
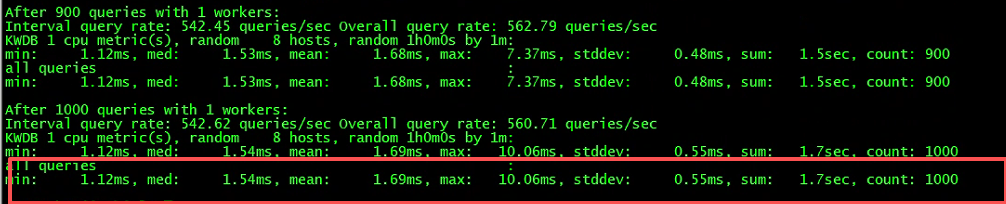
这里放一些调优参数,下面这些都能用 SET CLUSTER SETTING 在线改,改完立即生效。
| 参数 | 默认值 | 作用 | 怎么调 |
|---|---|---|---|
ts.partition.interval |
864000(10 天) | 时间分区间隔(秒) | 按业务查询周期定,平衡剪枝收益和分区元数据量 |
ts.block.lru_cache.max_limit |
1073741824(1GB) | Block 解压缓存上限 | 查询密集且内存够就调大,内存紧就收紧 |
ts.last_cache_size.max_limit |
— | last 类查询缓存 | last() 查询多就调大 |
ts.rows_per_block.max_limit |
4096 | 单 Block 最大行数 | 顺序扫描和高吞吐场景调大到 8192–16384,点查场景调小 |
ts.rows_per_block.min_limit |
512 | 单 Block 最小行数 | 低延迟小批量写入场景调大 |
ts.count.use_statistics.enabled |
true | COUNT 走预计算统计 | 保持开启 |
ts.last_row_optimization.enabled |
true | 末行缓存优化 | 保持开启 |
ts.dedup.rule |
override | 去重规则 | 按业务语义选 merge / override / discard |
work_mem(会话级) |
64MB | 排序 / 哈希内存 | 大聚合查询临时提到 256MB–1GB |
vectorize(会话级) |
off | 向量化执行 | 列式友好的查询打开 |
带 ts. 前缀的参数大多直接作用于时序引擎,改错了会牵连写入性能和内存占用。动手之前先把副作用想清楚。
五、慢查询怎么定位
调优先定位问题,别一上来就试参数。建议按这个顺序走:
第一步,先分清慢在 SQL 还是环境。用 EXPLAIN ANALYZE(DEBUG) 出诊断包,看耗时集中在哪个算子。扫描慢就是扫描范围的问题,join 或 aggregate 慢就是算子选择的问题。
第二步,确认扫描有没有"全表"。EXPLAIN 看 spans。出现 FULL SCAN 的时候依次问自己:过滤列有索引吗?时序列是不是主标签?时间条件触发剪枝了吗?
第三步,看跨模查询的数据怎么流动。关系侧是不是先算完了?时序侧聚合下推了吗?优化器选的连接顺序和数据量级对得上吗?统计信息要是过期了,连接顺序十有八九是错的。
第四步,查资源有没有溢出。work_mem 不够导致 spill、Block Cache 命中率低,这类问题的表现往往是"偶发慢"或者"数据涨上来之后突然变慢",得结合内存监控一起看。
第五步,回头看看写侧。前面都正常但读还是慢,就检查写入是不是乱序、去重规则有没有在查询路径上摊成本、内存分段是不是太大导致归并读变重。
六、小结
KWDB 的查询调优,说到底是在跟无用功作斗争。存储层让引擎少碰数据,主标签做设备级裁剪,时间分区做范围裁剪;执行层让数据少搬家,统计信息新鲜了连接顺序才选得对,聚合能下推就下推,向量化再摊一层 CPU 开销;剩下的是资源层面,work_mem 给够避免落盘,Block Cache 配好提高命中,内存分段管住,归并读的成本才不会悄悄涨上来。
有个习惯值得养成:碰到慢查询,先看 spans 是不是 FULL SCAN,再看跨模查询的算子下推了没有,最后才去动参数。这个顺序反了,很容易在参数上兜圈子,真凶却一直没找到。
评论(0)