一、为什么高可用不能替代备份
在之前的文章中,我们先后讨论了多副本集群、DRBD 双机高可用和集群扩缩容,这些方案有一个共同的盲区——它们保护的都是硬件和系统的可靠性,而不是数据的逻辑正确性。多副本集群把数据复制到 3 个节点,DRBD 把数据镜像到备机,但这些副本是实时同步的:你在主库上执行了一条 DROP TABLE,这条操作会以同样的速度传播到所有副本。副本越多,误删得越快、越彻底。高可用解决的是"机器坏了,服务不能停";备份解决的是"数据错了(不管是误删、脏数据还是程序 bug),还能回到过去"。
这两件事的衡量指标也不同。高可用看 RPO/RTO(丢多少数据、停多久服务);备份看的是另一个问题:你能恢复到过去哪一个时间点,以及为达到这个目标需要付出多少存储和带宽成本。理解备份,需要建立三个基础概念:
1、全量备份与增量备份。 全量备份把目标对象的完整数据复制一份,恢复最简单,但每次备份都消耗完整的时间和空间。增量备份只备份自上次备份以来新增或修改的数据,日常开销小,但恢复时必须按顺序应用整个备份链(全量 + 历次增量),链条越长,恢复越复杂、失败点越多。工程上的常见做法是定期全量 + 高频增量的混合策略。
2、备份粒度。 备份可以按不同范围执行:整个实例(引擎级)、某个数据库(库级)、某张表(表级)。粒度越细,灵活性越高(可以只恢复一张表),但管理成本也越高。生产环境通常库级或引擎级为主,表级作为补充。
3、时间点恢复(PITR)。 最理想的恢复不是"回到昨晚的备份时刻",而是"回到误操作发生的前一秒"。实现这一点需要备份文件中保存数据的历史版本,恢复时指定目标时间点,系统只还原该时间点之前的数据状态。PITR 是衡量备份系统能力的关键指标,但它有成本:历史版本数据会显著增加备份体积。
此外还有一个在行业内比较受认可的经验原则——3-2-1 备份原则:至少保留 3 份数据副本,存储在 2 种不同的介质上,其中 1 份存放在异地。副本冗余(集群内)只是第 1 份,独立介质的异地备份才是抵御机房级灾难(火灾、断电、误配置)的最后防线。
二、KaiwuDB 的两层数据保护体系
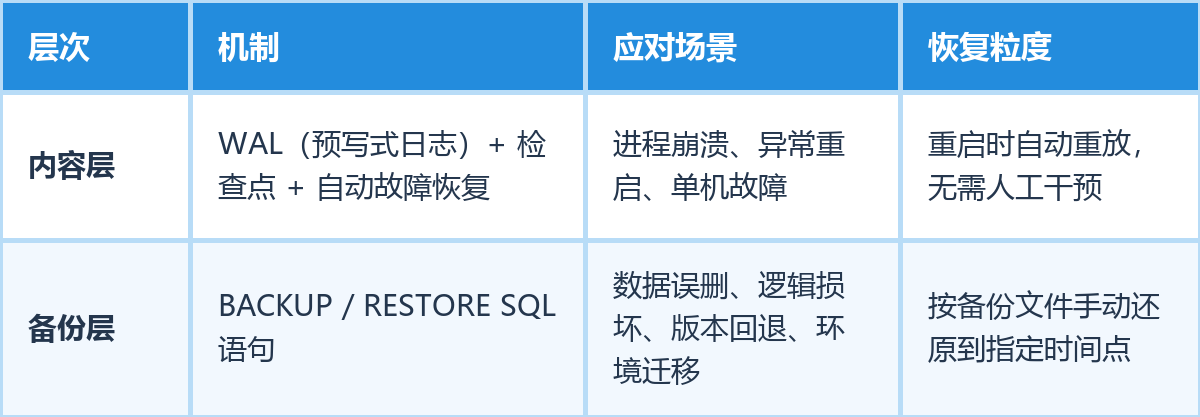
KaiwuDB 的数据保护分为两层,职责不同,互为补充:
三、容灾层:基于 WAL 的时序数据灾难恢复
WAL(Write-Ahead Logging,预写式日志)是数据库领域最经典的数据安全机制,核心思想是一句话:任何数据修改,先把日志写到磁盘,再修改数据本身。 这样即使系统在写数据的途中崩溃,重启后也可以通过重放日志把未完成的操作重新执行,或回滚异常事务,保证数据的一致性与原子性。
KaiwuDB 就是通过 WAL(Write-Ahead Logging,预写式日志)技术,在 VGroup(虚拟组)级别记录时序表的模式变更和数据变更,实现时序数据灾难恢复,确保时序数据的一致性与原子性。包括以下三个核心步骤实现时序数据灾难恢复:
-
预写日志:所有时序数据修改操作在执行前必须先写入 WAL 日志,即使系统异常退出也能完整恢复数据;
-
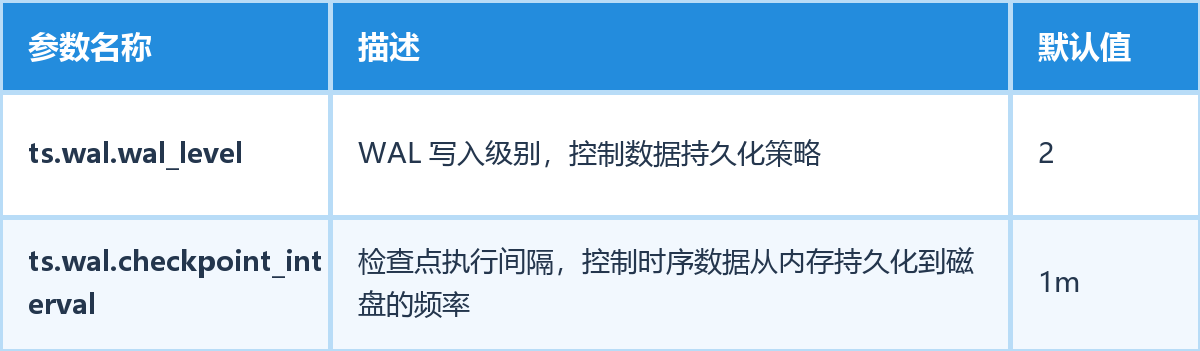
定期检查点(Checkpoint):系统后台定期将内存中的数据写入磁盘以确保数据安全,默认间隔为 1 分钟,可通过参数调整;
-
故障恢复:系统重启时自动检查上次关闭状态,重放未完成的 WAL 操作并回滚异常事务。
3.1 WAL 文件的双文件轮转策略
KaiwuDB 采用双文件轮转策略管理 WAL 文件:
-
current_file:当前活跃的 WAL 写入文件,文件大小根据系统负载和配置参数动态调整;
-
checkpoint_file:执行检查点时由 current_file 转换的临时文件,数据同步完成后自动删除。
轮转流程:正常运行时所有 WAL 操作记录在 current_file 中;触发检查点时,current_file 转换为 checkpoint_file,同时系统立即创建新的 current_file 继续接收写入;数据同步完成后 checkpoint_file 被安全删除。这个设计的巧妙之处在于,检查点期间写入不需要停顿,新旧文件无缝衔接。
3.2 WAL 配置参数
用户可通过以下参数调整 WAL 行为:
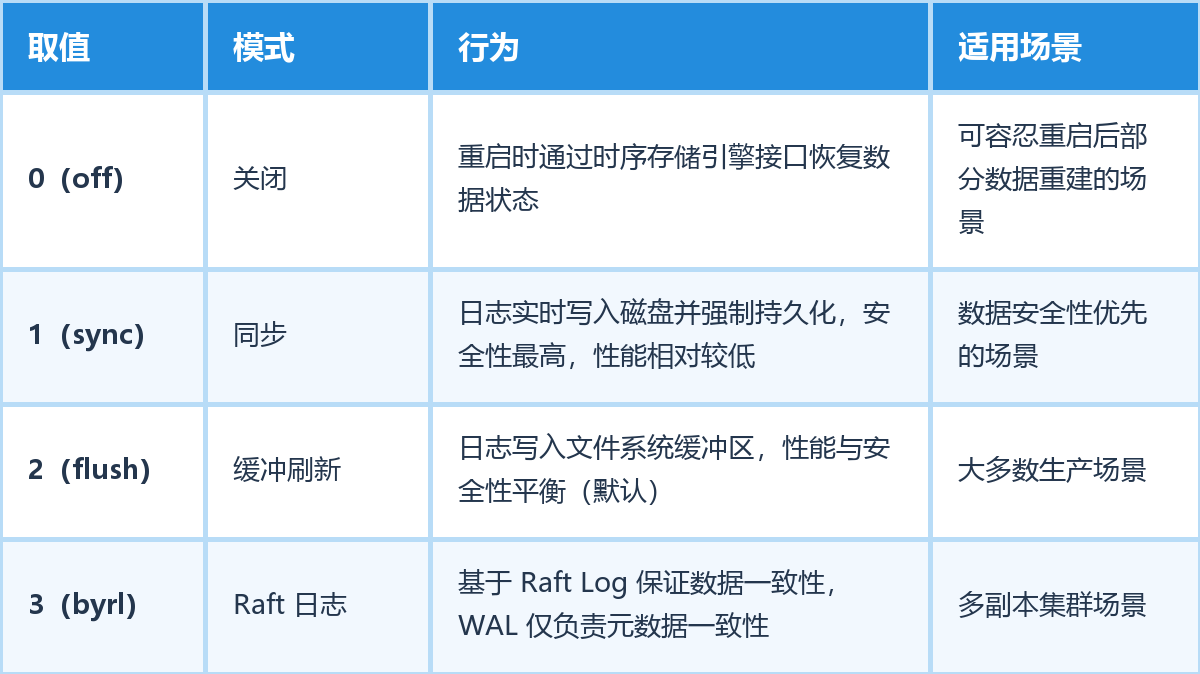
ts.wal.wal_level 有四个可选值:
注意事项:
-
支持从
2(flush)或1(sync)动态切换到0(off)3(byrl),切换过程会产生短暂阻塞,阻塞时长取决于当前检查点的执行时间; -
实例级别的 DDL 操作不受
ts.wal.wal_level影响,始终启用 WAL 并实时持久化。
-- 设置 WAL 为同步模式,确保最高数据安全性
SET cluster setting ts.wal.wal_level = 1;

-- 调整检查点间隔为 5 分钟
SET cluster setting ts.wal.checkpoint_interval = '5m';
需要明确的是,WAL 容灾层保护的是系统级故障:进程崩溃、机器重启、断电。WAL 文件本身就在数据目录内,如果磁盘损坏或数据目录被误删,WAL 也随之丢失——这正是备份层存在的意义。
四、备份层:备份功能详解
4.1 功能概述与适用场景
备份是指将数据库中的用户数据和元数据复制到指定位置的过程,用于在数据丢失、损坏或系统故障时恢复数据。KaiwuDB 的备份功能主要应对四类场景:
-
灾难恢复:硬件故障、软件崩溃、自然灾害等意外情况时,根据备份文件快速恢复系统可用性;
-
版本回退:数据库升级、应用升级出错时,根据备份文件回退至稳定版本;
-
数据保护:防止人为误操作导致的数据丢失;
-
系统迁移:将数据从一个环境迁移到另一个环境。
此外,KaiwuDB 关系数据备份支持基于时间点的备份:通过 AS OF SYSTEM TIME 语法指定时间点,仅备份该时间点之前的数据。如需在还原时也能指定任意时间点恢复,备份时应同时指定 WITH revision_history 参数,将历史版本数据一并纳入备份;若不添加该参数,备份文件不含历史版本数据,还原时将无法使用 AS OF SYSTEM TIME。注意:时序数据暂不支持基于时间点的备份。
4.2 备份类型与粒度
KaiwuDB 支持对时序数据和关系数据进行不同粒度的备份:
-
引擎级备份:备份整个时序引擎或关系引擎下的所有数据库;
-
数据库级备份:备份指定数据库下的所有表;
-
表级备份:备份指定的单个表。
KaiwuDB 支持全量备份和增量备份两种备份策略:
-
全量备份:备份指定对象的完整数据,适用于首次备份或需要完整数据副本的场景;
-
增量备份:仅备份自上次备份后新增或修改的数据,有效减少备份时间和存储空间占用。
4.3 备份文件结构
时序数据采用"引擎 → 数据库 → 表"三级层级结构,引擎层级包含 BACKUP_TS_PATH 标识文件和 metadata 元数据文件,表目录下存储标签与指标数据文件。增量备份形成备份链,每个增量目录内部结构与全量相同。
关系数据采用扁平结构,包含 BACKUP 元数据文件、路径标识文件(BACKUP_RELATIONAL_PATH)、粒度标识文件(RELATIONAL_ENGINE / RELATIONAL_DATABASE / RELATIONAL_TABLE)和 .sst 数据文件。增量备份同样形成备份链。
4.4 备份操作
备份操作通过 BACKUP SQL 语句执行,支持通过作业管理查看、暂停、恢复和取消备份任务。有关 BACKUP SQL 语句的详细信息,参见备份管理。有关作业管理的详细信息,参见作业管理。
4.5 功能限制(重要)
时序数据备份限制:
-
历史数据处理:首次备份后写入的历史数据(时间戳早于备份时间)不会被后续增量备份捕获,历史数据的删除操作也无法被增量备份记录;
-
备份时间窗口:备份任务开始后,时间戳晚于备份开始时间的新写入数据不会包含在本次备份中。
通用限制:
-
任务中断处理:暂停全量备份任务后,如需恢复执行,必须先手动清理目标文件夹中已生成的临时文件,否则恢复操作将失败;
-
版本兼容性:备份文件不支持跨大版本还原(如 3.0.x ↔ 3.1.x),同一大版本内的小版本支持互相还原;
-
备份范围:目前暂不支持权限、系统表、序列等对象。
增量备份基准路径的差异:
-
时序数据:只需指定上一次备份的路径作为基准,系统自动以该路径的备份作为增量起点;
-
关系数据:需按时间顺序列出所有相关的备份路径(包括全量和之前所有增量),以确保备份链完整。
-- 时序表:每次只需指定上一次备份路径
BACKUP TABLE t1 TO "nodelocal://1/t1_inc/t1";
BACKUP TABLE t1 TO "nodelocal://1/t1_inc/t1_inc1" INCREMENTAL FROM "nodelocal://1/t1_inc/t1";
BACKUP TABLE t1 TO "nodelocal://1/t1_inc/t1_inc2" INCREMENTAL FROM "nodelocal://1/t1_inc/t1_inc1";

-- 关系表:第二次增量需按顺序列出全量 + 第一次增量
BACKUP TABLE t1 TO "nodelocal://1/t1_inc/t1_inc2" INCREMENTAL FROM "nodelocal://1/t1_inc/t1",
                                                    "nodelocal://1/t1_inc/t1_inc1";
五、备份层:还原功能详解
5.1 功能概述与适用场景
还原是指将备份文件中的数据和元数据恢复到数据库系统中的过程,使目标对象恢复到备份时的状态。主要场景包括:
-
灾难恢复:系统故障、数据损坏或丢失时,通过还原备份数据快速恢复业务连续性;
-
数据迁移:将数据从一个环境迁移到另一个环境,如从测试环境迁移到生产环境;
-
版本回退:系统升级或变更出现问题时,回退到之前的稳定状态;
-
测试环境搭建:使用生产数据备份快速搭建测试环境;
-
数据分析:为数据分析和报表生成创建独立的数据副本。
关系数据还原支持基于时间点的还原,通过 AS OF SYSTEM TIME 指定时间点,仅还原备份文件中该时间点之前的数据,实现精细化恢复。同样,此功能依赖备份时使用了 WITH revision_history 参数。时序数据暂不支持基于时间点的还原。
5.2 还原类型
粒度与备份对应(引擎级、数据库级、表级),策略分两种:
-
全量还原:从单个全量备份文件夹完全恢复目标对象到该备份时间点的状态;
-
增量还原:按时间顺序依次应用多个备份文件夹(全量 + 增量),恢复到最后一个增量备份的时间点状态。
还原通过 RESTORE SQL 语句执行,支持作业管理。
5.3 功能限制(重要)
通用限制:
-
任务中断处理:暂停全量还原任务后,如需恢复执行,必须先手动清理目标文件夹中已生成的临时文件;
-
版本兼容性:同备份的限制,不支持跨大版本还原;
-
备份链完整性要求:
-
时序数据:执行增量还原时,可仅指定部分连续的备份路径,系统会根据集群当前状态自动判断从哪个备份文件开始还原,所配置的文件必须保持连续性;
-
关系数据:需按备份时间顺序列出所有备份路径(全量 + 所有增量),缺少任何一个都会导致还原失败;
-
-
还原范围:不支持权限、系统表、序列等对象。
关系引擎还原限制:
- 增量还原前置操作:执行增量还原前,需要先删除目标对象,再按备份顺序列举所有备份文件路径:
-- 错误示例:直接对已存在的表进行增量还原会失败
RESTORE TABLE t1 FROM "nodelocal://1/tb1", "nodelocal://1/tb1_inc";

-- 正确示例:先删除表,再按备份顺序还原
DROP TABLE t1;
RESTORE TABLE t1 FROM "nodelocal://1/tb1", "nodelocal://1/tb1_inc";

-- 多个增量备份时,按顺序列出全部路径
DROP TABLE t1;
RESTORE TABLE t1 FROM "nodelocal://1/tb1", "nodelocal://1/tb1_inc1", "nodelocal://1/tb1_inc2";
- 基于时间点的还原:要求对应备份文件在创建时已使用
WITH revision_history参数,否则只能还原至备份时的完整状态。
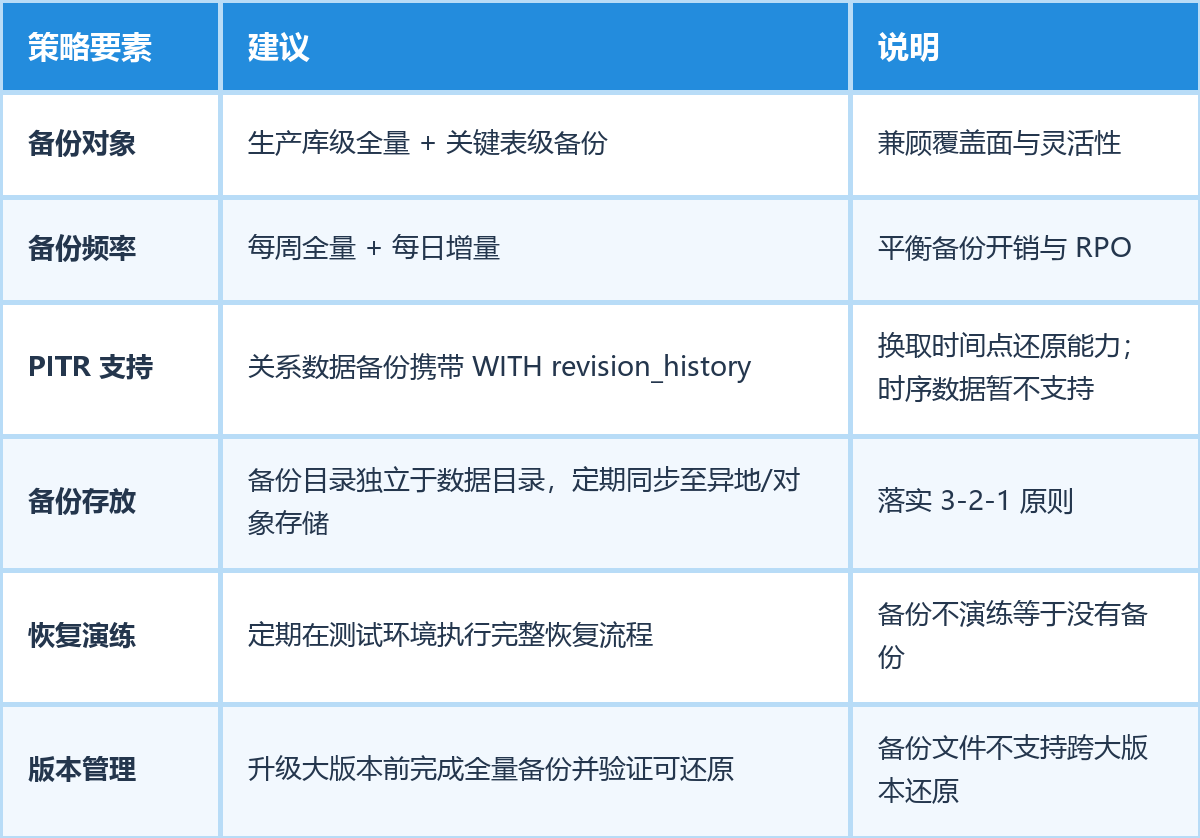
六、备份策略设计参考
结合 KaiwuDB 的功能边界,这里为大家提供一个可行性较高的备份策略设计思路:
写在最后
数据保护是一个分层体系:WAL 和检查点挡住进程崩溃级别的故障,副本和集群挡住机器级别的故障,备份挡住逻辑错误和灾难级别的故障。三层缺一不可,也互相不可替代——任何只依赖其中一层的方案,都在某个方向上存在盲区。
KaiwuDB 把这个体系做成了直接可用的产品能力:WAL 容灾自动运行、无需干预;备份还原通过标准 SQL 语句操作,粒度覆盖引擎、库、表三级,关系数据还支持基于时间点的备份还原。使用时的关键,在于理解功能边界:时序与关系数据在增量备份链的写法上不同,关系数据增量还原需要先删除目标对象,备份文件不能跨大版本还原,PITR 依赖备份时的 WITH revision_history 参数。
备份策略最终要回答的问题只有一个:当最坏的情况发生时,你能恢复到什么时间、什么状态?建议现在就回答这个问题,而不是等事故发生后再想。
-
企业版和开源版均支持备份还原能力,欢迎获取安装包体验:https://www.kaiwudb.com/download?tab=1
-
详细文档:https://www.kaiwudb.com/docs/#/db-operation/backup-and-restore.html
评论(0)