
把时序数据用起来:WorkBuddy × KWDB,搭一个能问数的智能电表分析助手
一、数据库接上 AI,价值不止于“自动写 SQL”
如果园区里有一批智能电表,业务同事通常不会先问 SQL 怎么写,而是直接问:“昨天各区域有哪些电压异常?”“哪些电表需要关注?”“有档案却没上报的设备能不能一起找出来?”
这些问题看似简单,背后却包含不同类型的数据:持续上报的时间、电压、电流与功率属于时序采样,设备归属、安装信息和区域名称属于关系档案。只看采样,难以知道设备属于哪个区域;只看档案,又无法回答指定时间窗口里发生了什么。
这正是我选择 KWDB 做这次 AI 实践的原因:不是孤立展示一个 Text-to-SQL 功能,而是把时序采样、关系档案和自然语言入口连接起来,让数据库已有的数据能力更容易被业务使用。
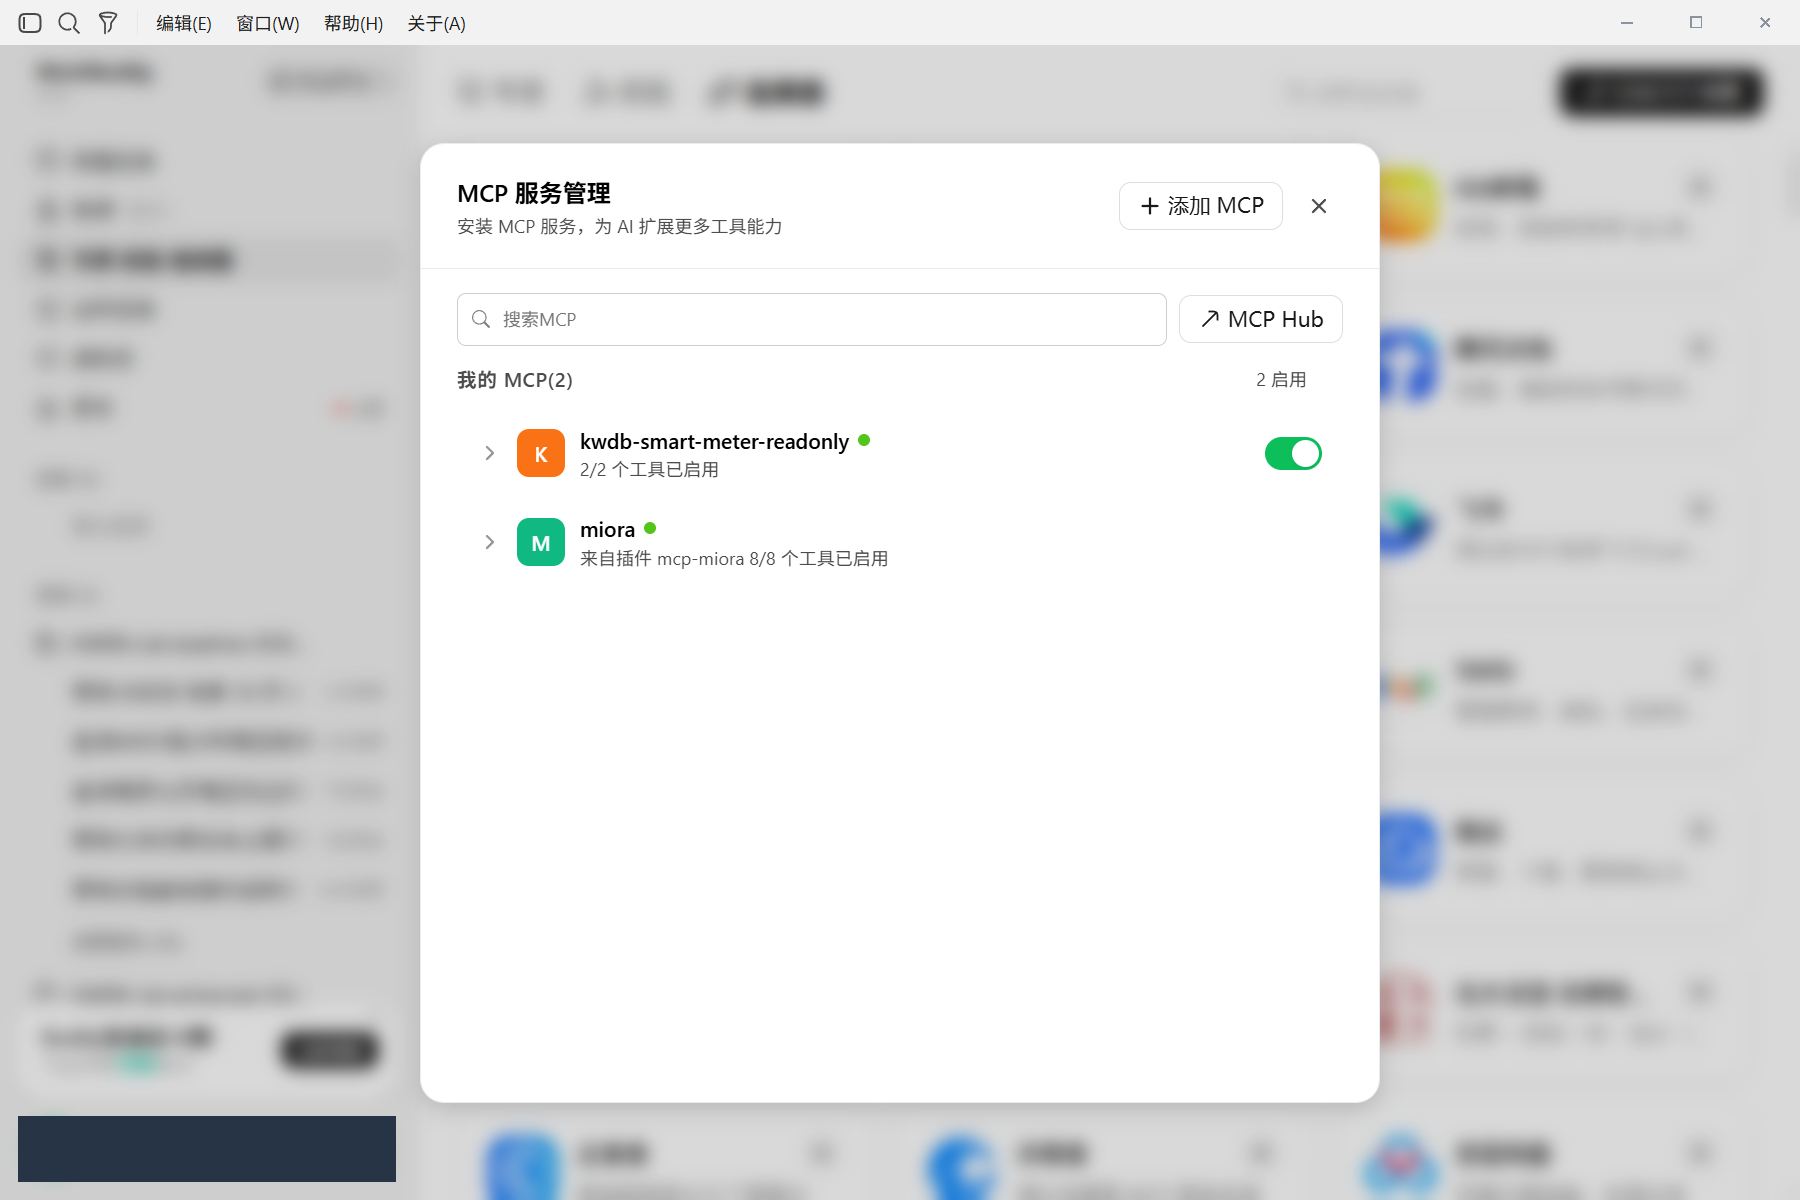
本文用 Windows WorkBuddy 接入 WSL 中的 KWDB,通过官方 MCP Server 调用真实查询,并为分析工作空间加入官方 Agent Skill 和场景规则。最终搭出的是一条可以复现的分析链路:用自然语言提出问题,在 KWDB 中完成时序与关系数据关联,再把结果变成可解释、可核对的信息。
对开发者而言,这也是一条值得尝试的路径:不必先做完整的聊天前端,也不必为每一种分析问题单独写接口,可以先借助现成 AI 客户端验证业务问题和数据口径,再决定如何接入自己的应用。
二、三层配合,把 KWDB 能力带进 AI 工作空间
本次链路可以概括为:
Windows WorkBuddy → wsl.exe → stdio MCP → TLS 连接 KWDB。
数据库层负责存储和查询。电表采样放在 tsdb.meter_data,设备档案放在 rdb.meter_info,区域信息放在 rdb.area_info。分析时以电表编号连接采样与设备,再以区域编号连接区域。
工具层采用官方 KWDB MCP Server。WorkBuddy 通过标准工具调用向数据库发送查询,返回的不是模型凭空生成的数字,而是数据库执行后的实际结果。客户端可以先核对结构,再组织查询;我们也能从 MCP 日志保留实际 SQL 与响应。
知识层采用官方 kwdb-text2sql-aiot Skill,并单独补充智能电表的业务规则。MCP 提供“可以调用什么”,Skill 和场景规则补充“应该怎样使用这些能力”。两者结合,才能把连接成功推进到具体的业务分析。
截至 2026 年 10 月 10 日,本次按官方渠道核对并冻结的主组件如下。
| 组件 | 实际使用版本或提交 |
|---|---|
| KWDB | V3.2.2,WSL2 / Ubuntu 24.04 x86_64 |
| KWDB MCP Server | v3.0.0,stdio |
| Windows WorkBuddy | 5.7.7.40774747,界面短版本 5.7.7 |
| KaiwuDB Agent Skills | 49e6e97bedf0c8a645a6731a6edb1c86fdeb4991 |
| SampleDB | 6b6887b96637880178e585ab5c742f58609b5c9d |
| 可见模型模式 | “快速”,完成界面显示 Deepseek-V4.1-Flash |
“使用最新版”与“可复现”并不矛盾:先核对发布渠道,再固定实验版本,而不是在分析过程中持续升级。Windows 客户端使用独立 profile,数据库和 MCP 使用专属运行目录,不修改原有应用配置。
三、用一份有业务结构的数据,让演示真正跑起来
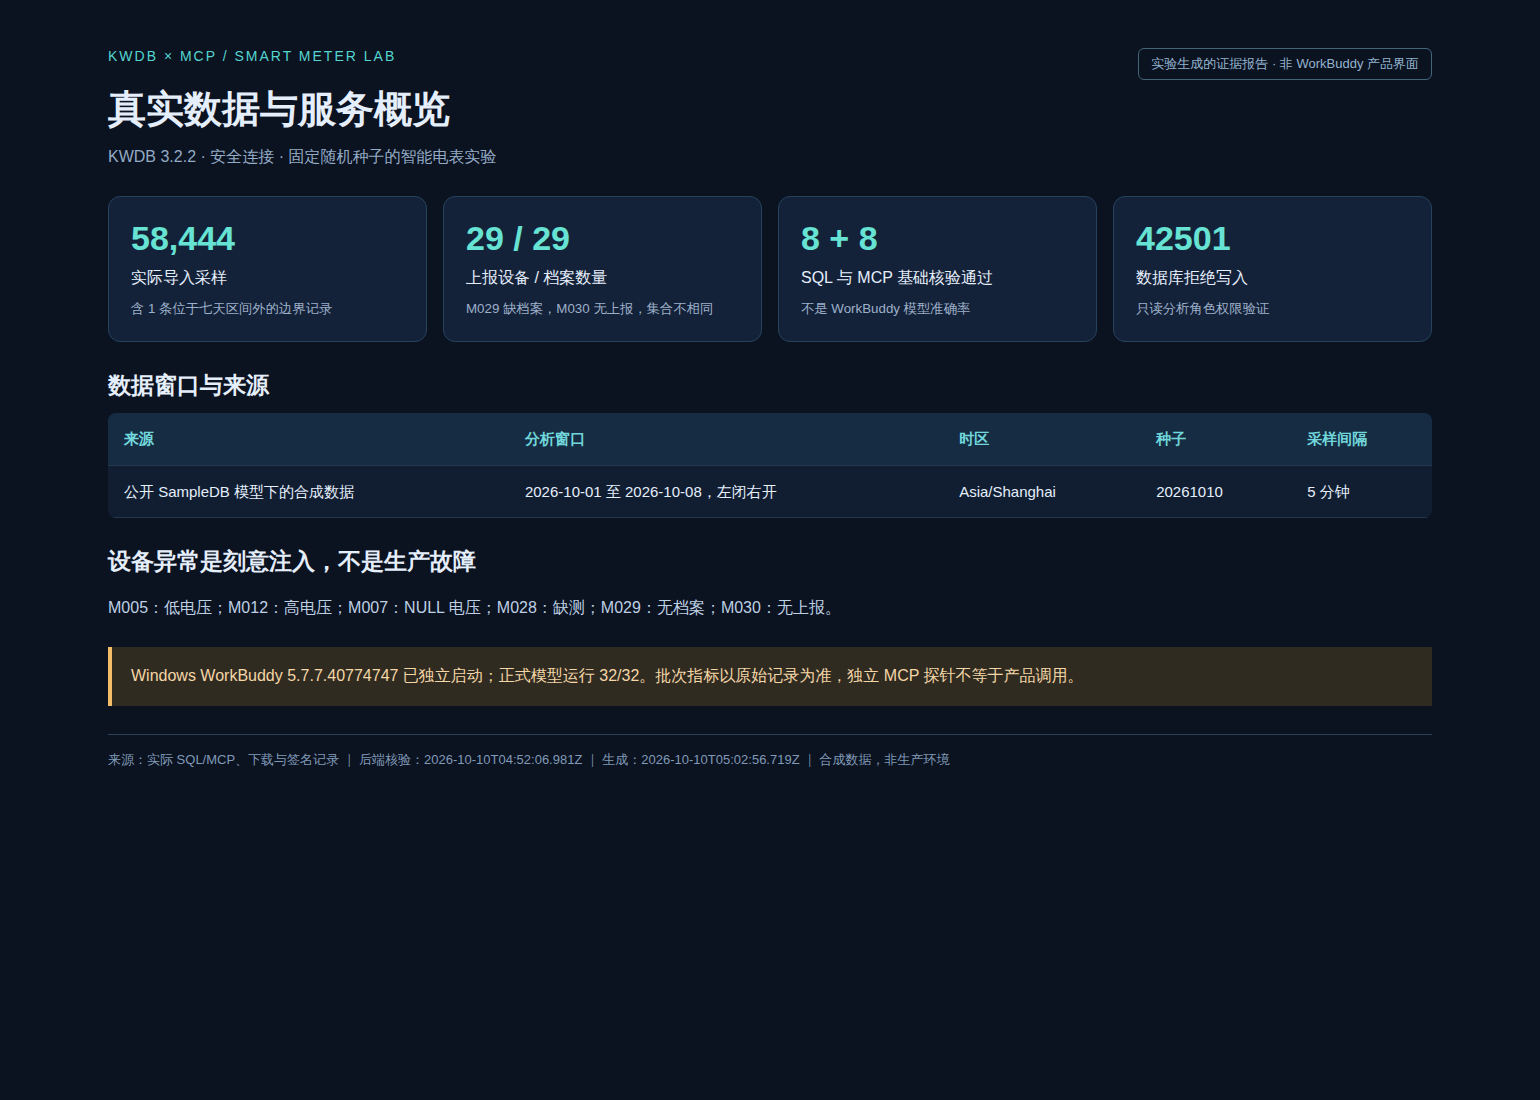
数据模型来自固定提交的 SampleDB 智能电表示例。基于该模型生成三个区域、约三十块电表、五分钟采样的七天样本,随机种子为 20261010,实际导入 58,444 行。
统一分析窗口为北京时间 [2026-10-01 00:00:00, 2026-10-08 00:00:00)。窗口内有 58,443 行,另外一条采样恰好位于右边界,用来核对日期口径。
我没有把全部记录都做成“每台设备、每个字段、每个时间点都完美”的数据。样本中同时包含电压越界、NULL 电压、少采样、有采样无档案、有档案无上报等情形。这样更容易看到:数据库分析的价值不只是算一个平均值,还包括把不同的数据状态区分清楚。
低于 210V 或高于 235V 是本实验约定,不是行业标准,也不能据此诊断真实设备故障。所有采样均为合成记录,不把示例改写成客户生产案例。
在接入客户端之前,先由原始生成记录独立计算参考结果,再分别通过直接 SQL 和 MCP 核对区域统计、缺失电压、设备档案对账和时间边界。参考结果与数据库输出一致,为后续自然语言问数提供了可核对的基线。
四、亮点一:一条跨模查询,把“采样”变成“区域视角”
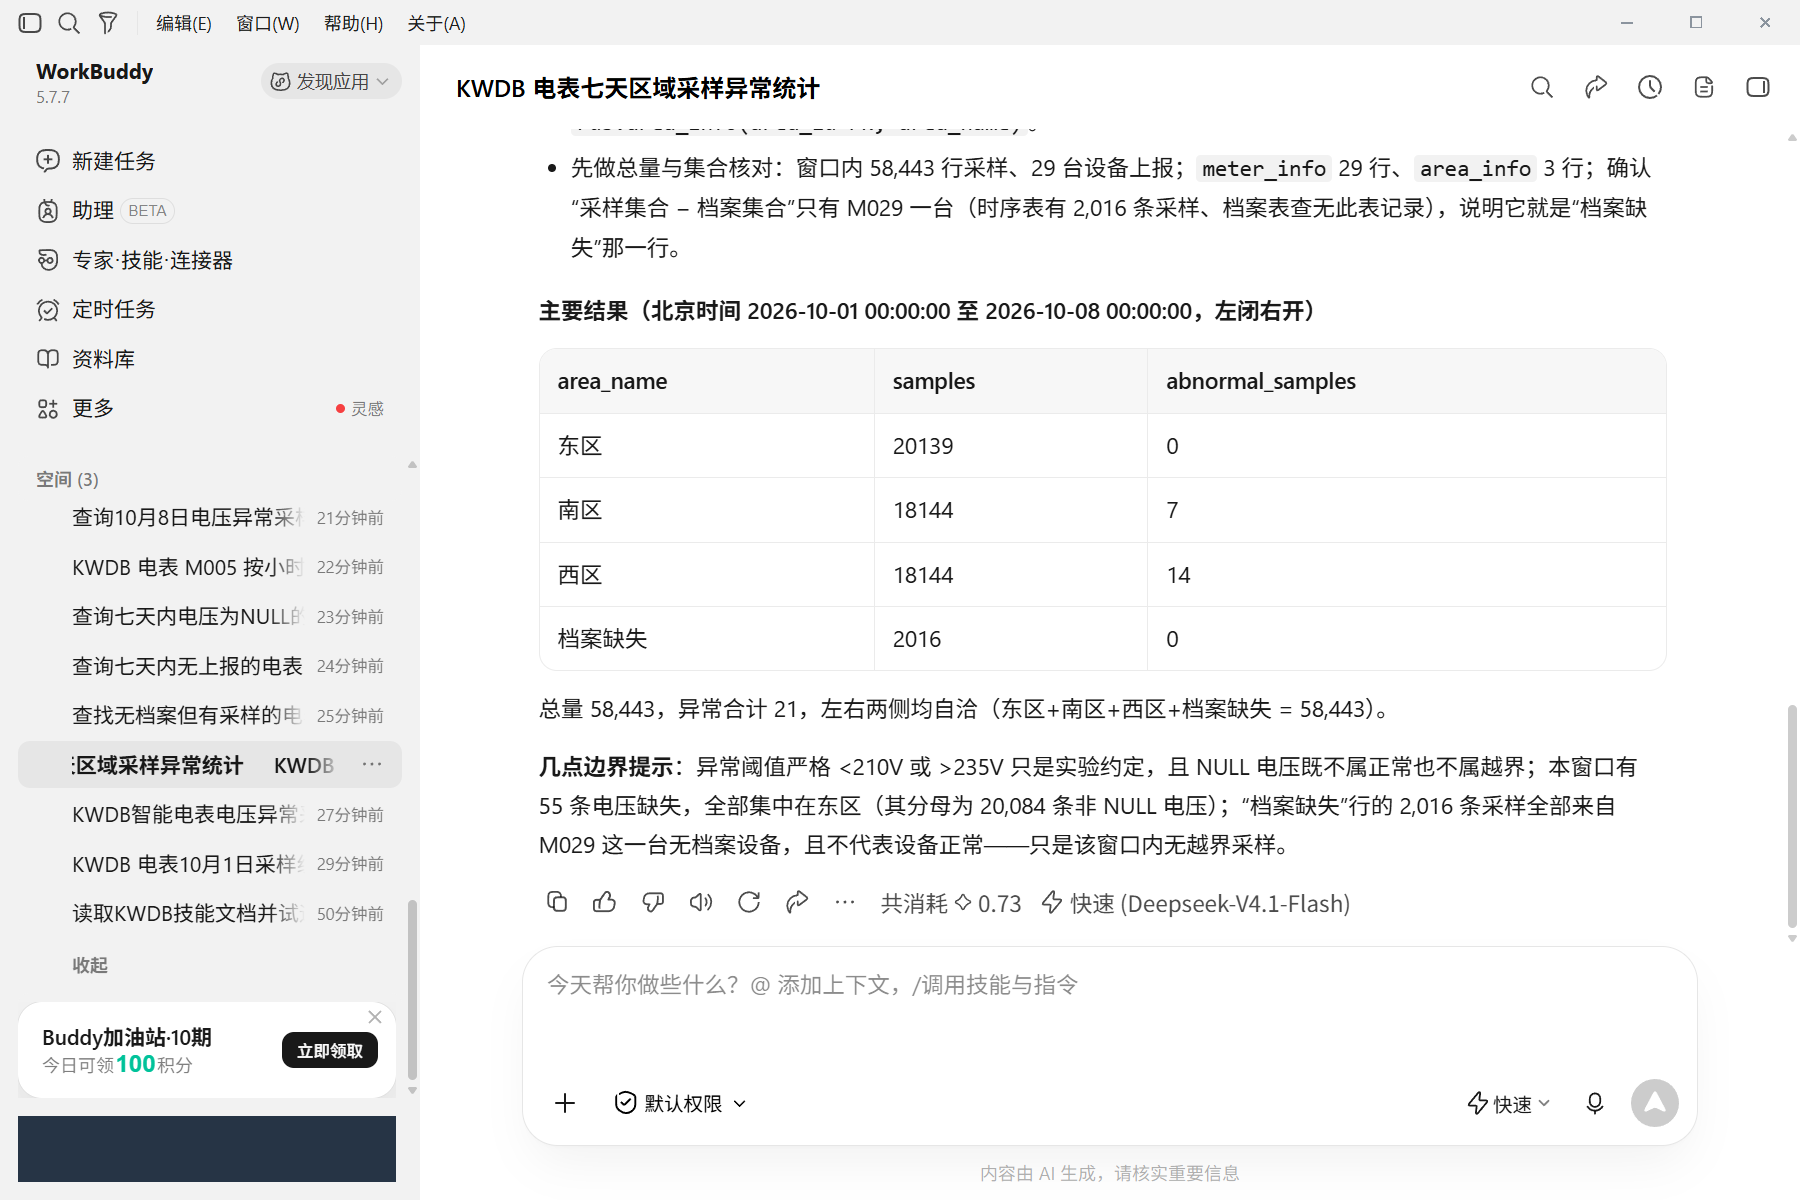
最能体现这次接入价值的问题是:“统计七天内各区域的采样与电压越界情况,没有设备档案的采样也要保留。”
这里不能只按时序表中的设备编号汇总。业务希望看到区域名称,就需要同时使用设备和区域档案;没有档案的采样也不能悄悄消失。
本次在 KWDB 中使用同一条 SQL,将时序采样与关系档案关联起来。无需在应用层先取采样、再取档案、最后手工拼成区域结果。核心查询如下。
SELECT COALESCE(areas.area_name, '档案缺失') AS area_name,
       COUNT(*) AS samples,
       SUM(CASE WHEN measurements.voltage < 210
                 OR measurements.voltage > 235 THEN 1 ELSE 0 END)
         AS abnormal_samples
FROM tsdb.meter_data AS measurements
LEFT JOIN rdb.meter_info AS meters
  ON measurements.meter_id = meters.meter_id
LEFT JOIN rdb.area_info AS areas
  ON meters.area_id = areas.area_id
WHERE measurements.ts >= TIMESTAMPTZ '2026-10-01 00:00:00+08:00'
  AND measurements.ts < TIMESTAMPTZ '2026-10-08 00:00:00+08:00'
GROUP BY COALESCE(areas.area_name, '档案缺失')
ORDER BY area_name LIMIT 100;
实际核对结果如下。
| 区域 | 七天采样数 | 电压越界采样数 |
|---|---|---|
| 东区 | 20,139 | 0 |
| 南区 | 18,144 | 7 |
| 西区 | 18,144 | 14 |
| 档案缺失 | 2,016 | 0 |
| 合计 | 58,443 | 21 |
这张表的意义不只是“算出来了”。它同时给出了业务分组与数据治理入口:有区域归属的记录进入区域统计,没有档案的记录独立保留。业务人员得到的是可以继续追问的区域视角,开发者则能追溯到明确的关联关系和 SQL。
这也是 KWDB 跨模能力在本场景里的直观价值:时间窗口、设备身份与区域归属可以在同一条查询链路中表达。AI 入口不是替代数据库,而是让这条已有能力更容易被调用。
五、亮点二:不仅看异常,也能看数据是否完整
智能电表分析中,最值得关注的往往不是一个单独的数值,而是“这个数值代表什么”。例如,设备没有越界记录,可能是电压正常,也可能是根本没有上报;采样条数完整,也不代表每条记录都有有效电压。
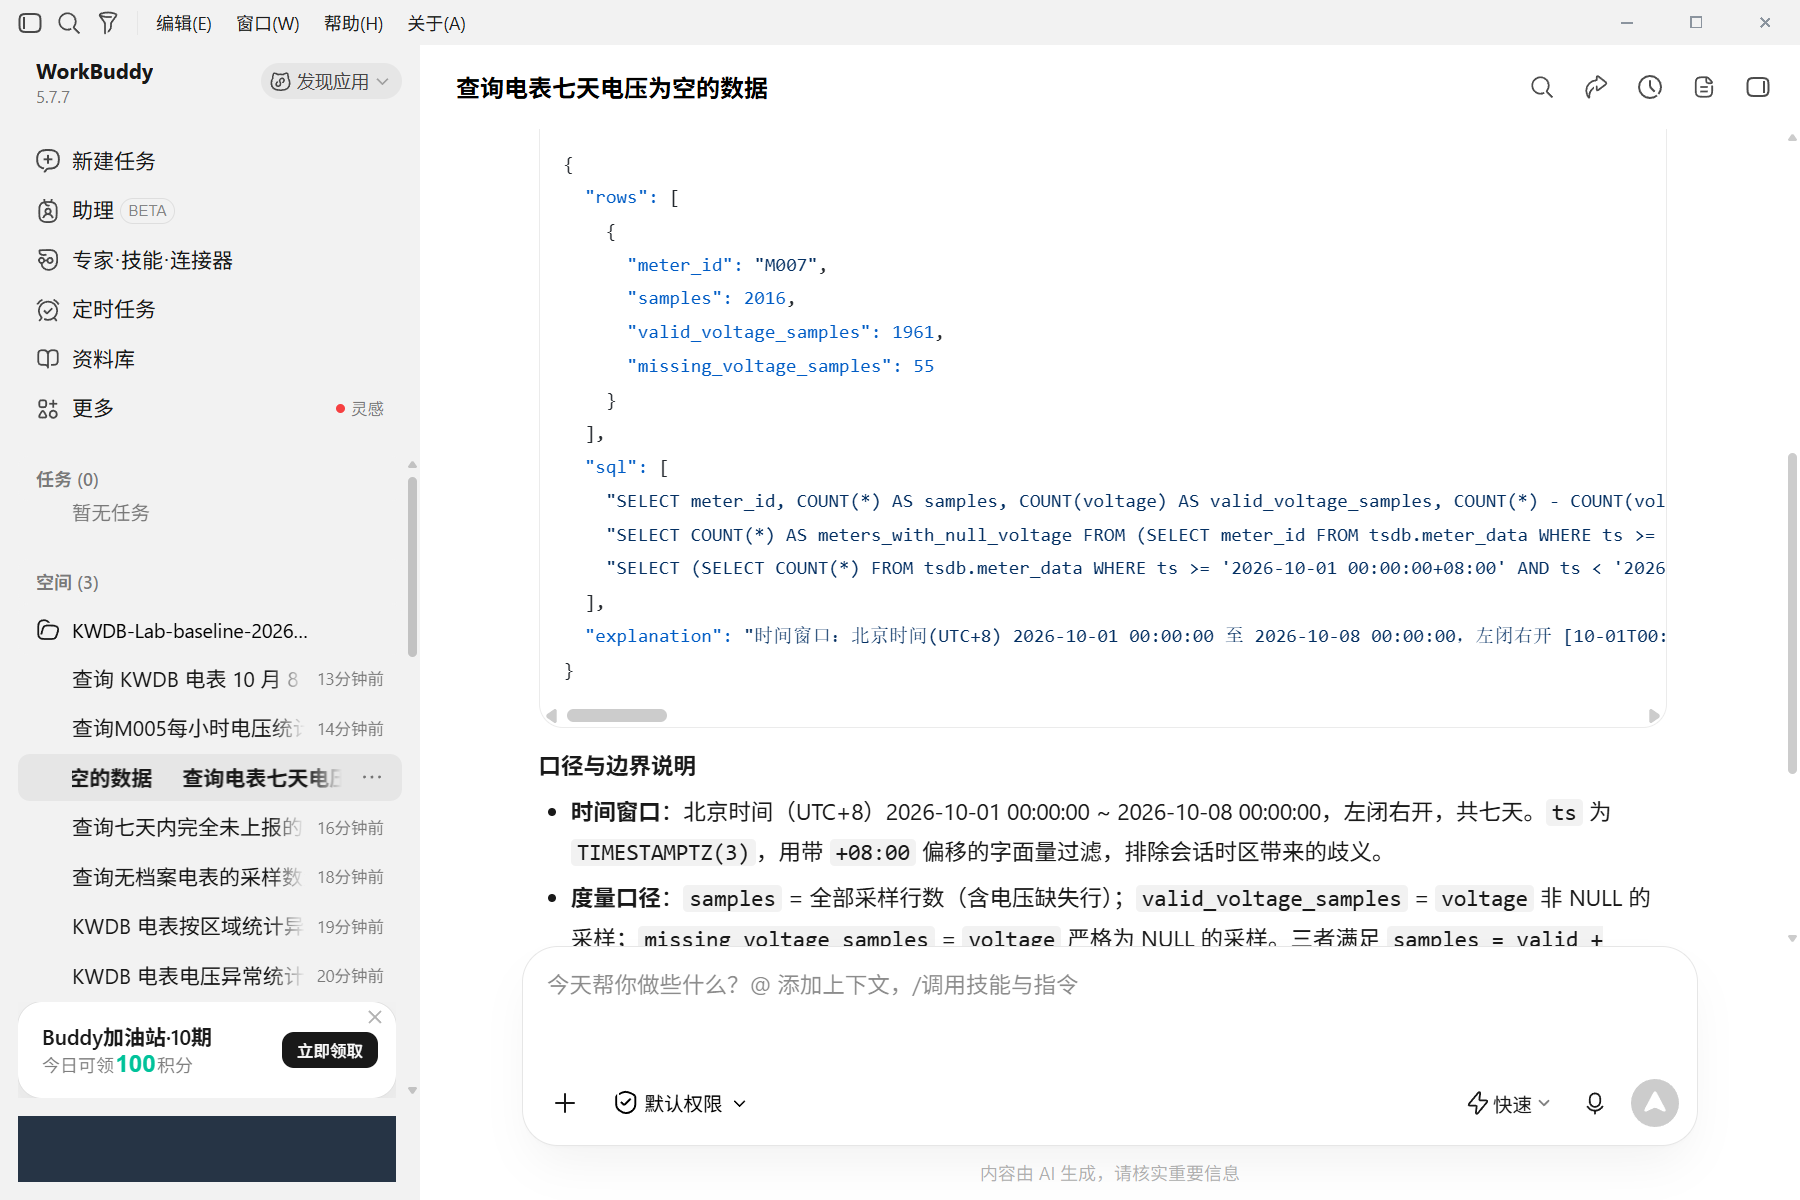
本次样本中的 M007 就是一个很清晰的例子:七天共有 2,016 个采样点,其中 1,961 个非 NULL 电压,因此有 55 个电压字段缺失。这不是少上报 55 次,而是记录存在、字段缺失。
对应的统计口径也很直观:COUNT(*) 统计采样行数,COUNT(voltage) 统计非 NULL 电压,二者之差表示缺失电压数。这样的结果比笼统给出“设备正常率”更容易被业务理解和复核。
另一类有价值的分析是设备集合对账。样本中,上报设备与档案设备各有 29 个编号,但并不是同一批设备:M029 有 2,016 条采样,却没有档案;M030 有档案,却完全没有上报。两个集合交集为 28、并集为 30。
因此,“哪些设备有采样却没档案”和“哪些设备有档案却没上报”应该分别查询。前者可以定位档案补录或关联问题,后者可以作为采集链路排查的候选入口;二者都不能直接等同于真实设备故障。
把这两类问题放进同一套数据分析流程,是时序与关系数据联动的另一项实用价值。它让 AI 问数不止停留在曲线或均值,还能帮助梳理数据是否完整、设备身份是否一致。
六、亮点三:时间窗口明确,分析结果才能被复用
时序分析的一个基础要求,是业务日期要有明确含义。本文统一采用北京时间,SQL 过滤写出 TIMESTAMPTZ 与时区偏移,窗口采用左闭右开形式。
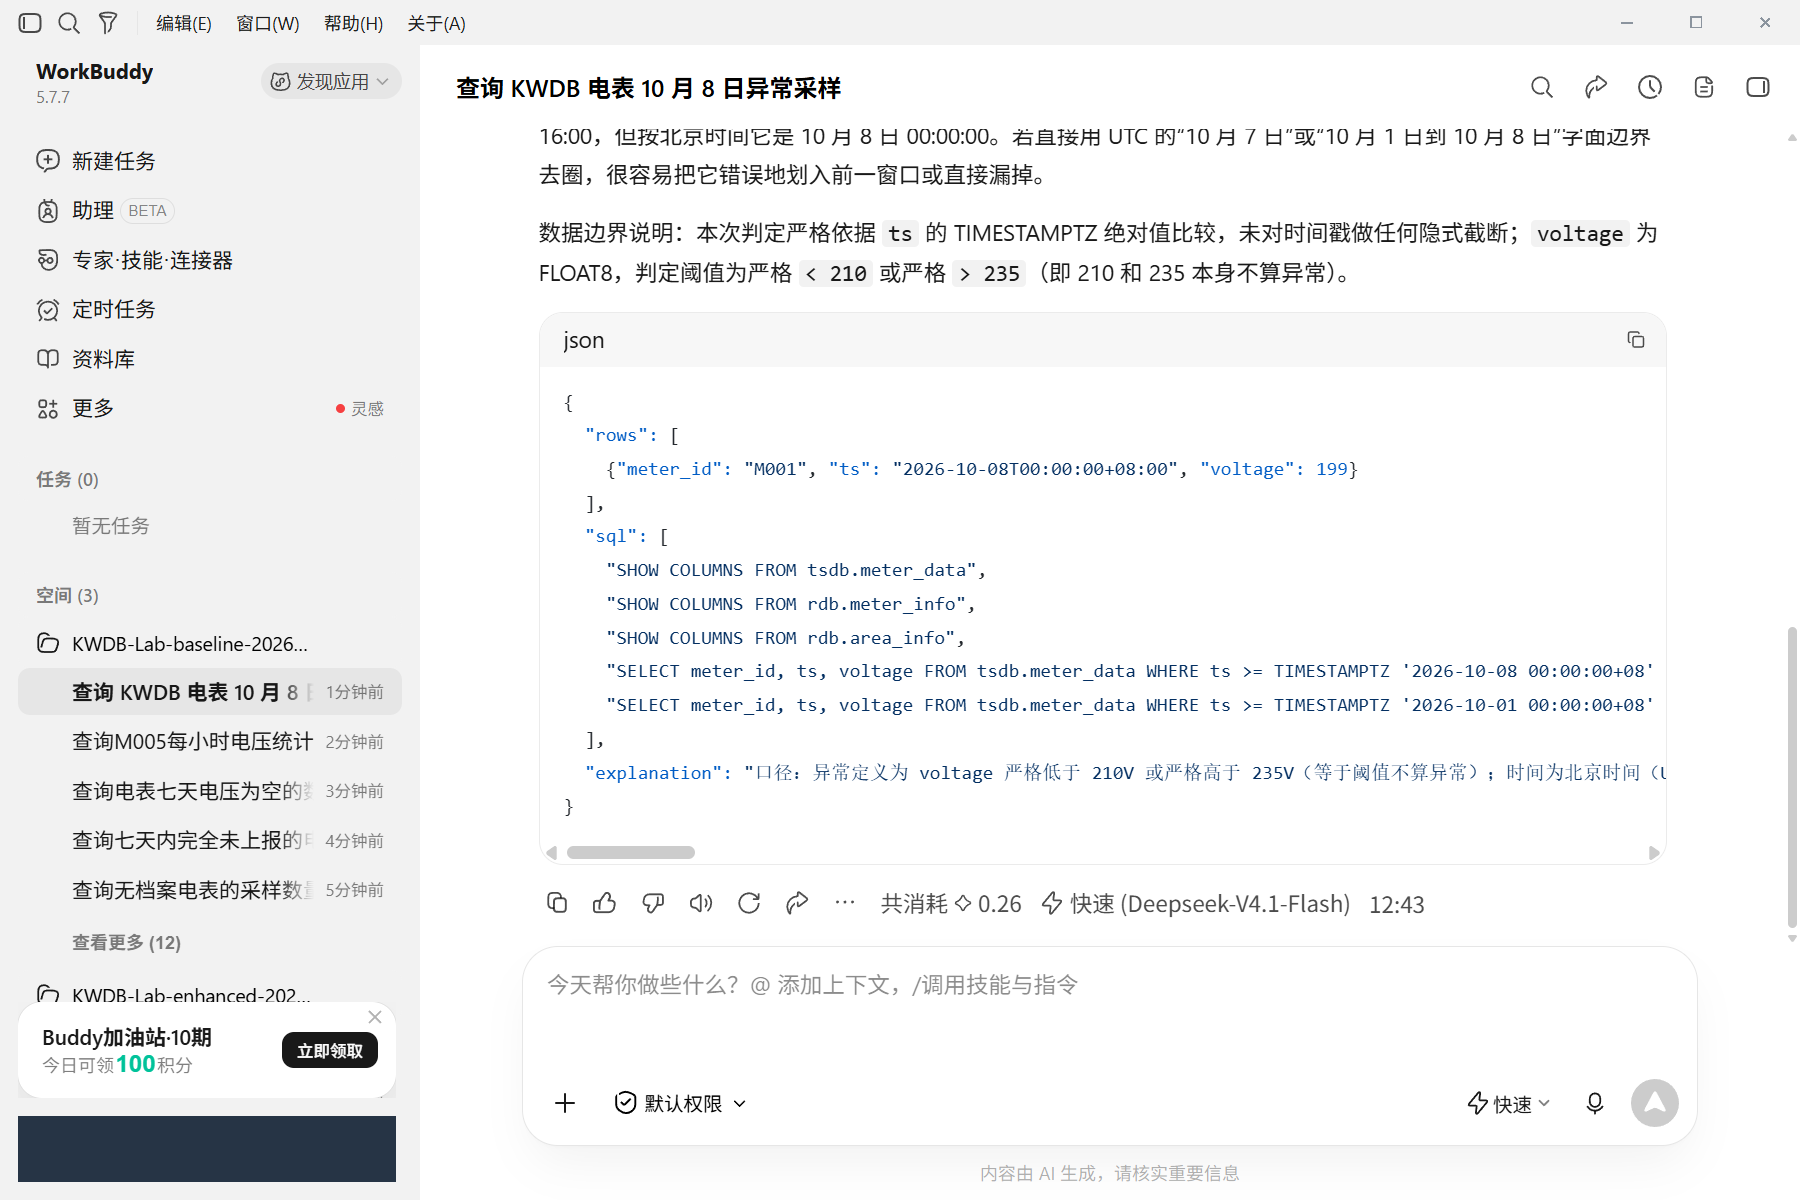
样本中有一条 M001 的 199V 采样,工具返回时间为 2026-10-07T16:00:00.000Z,换算为北京时间就是 10 月 8 日零点。它属于 10 月 8 日,不属于此前七天窗口。
这一条边界记录让读者能直接验证:七天窗口的越界采样数为 21,不能因为 UTC 字符串中出现“10-07”就将它算进去。按小时分析也要同样处理,明确小时桶表示的是哪一个绝对时刻。
对日报、巡检或周期分析而言,这种口径很重要。不同的人、不同的工具重复查询同一窗口,应该能得到相同定义下的结果。固定时间边界,再保留实际 SQL,是让 AI 分析可复核、可复用的基本做法。
七、MCP 与 Skill 配合,让生态能力更容易落地
这次实践里,我对 KWDB 生态最直接的感受,是组件之间可以围绕同一个业务场景协作:SampleDB 提供数据模型入口,MCP Server 提供客户端调用接口,Agent Skill 提供产品知识,KWDB 承接实际查询。
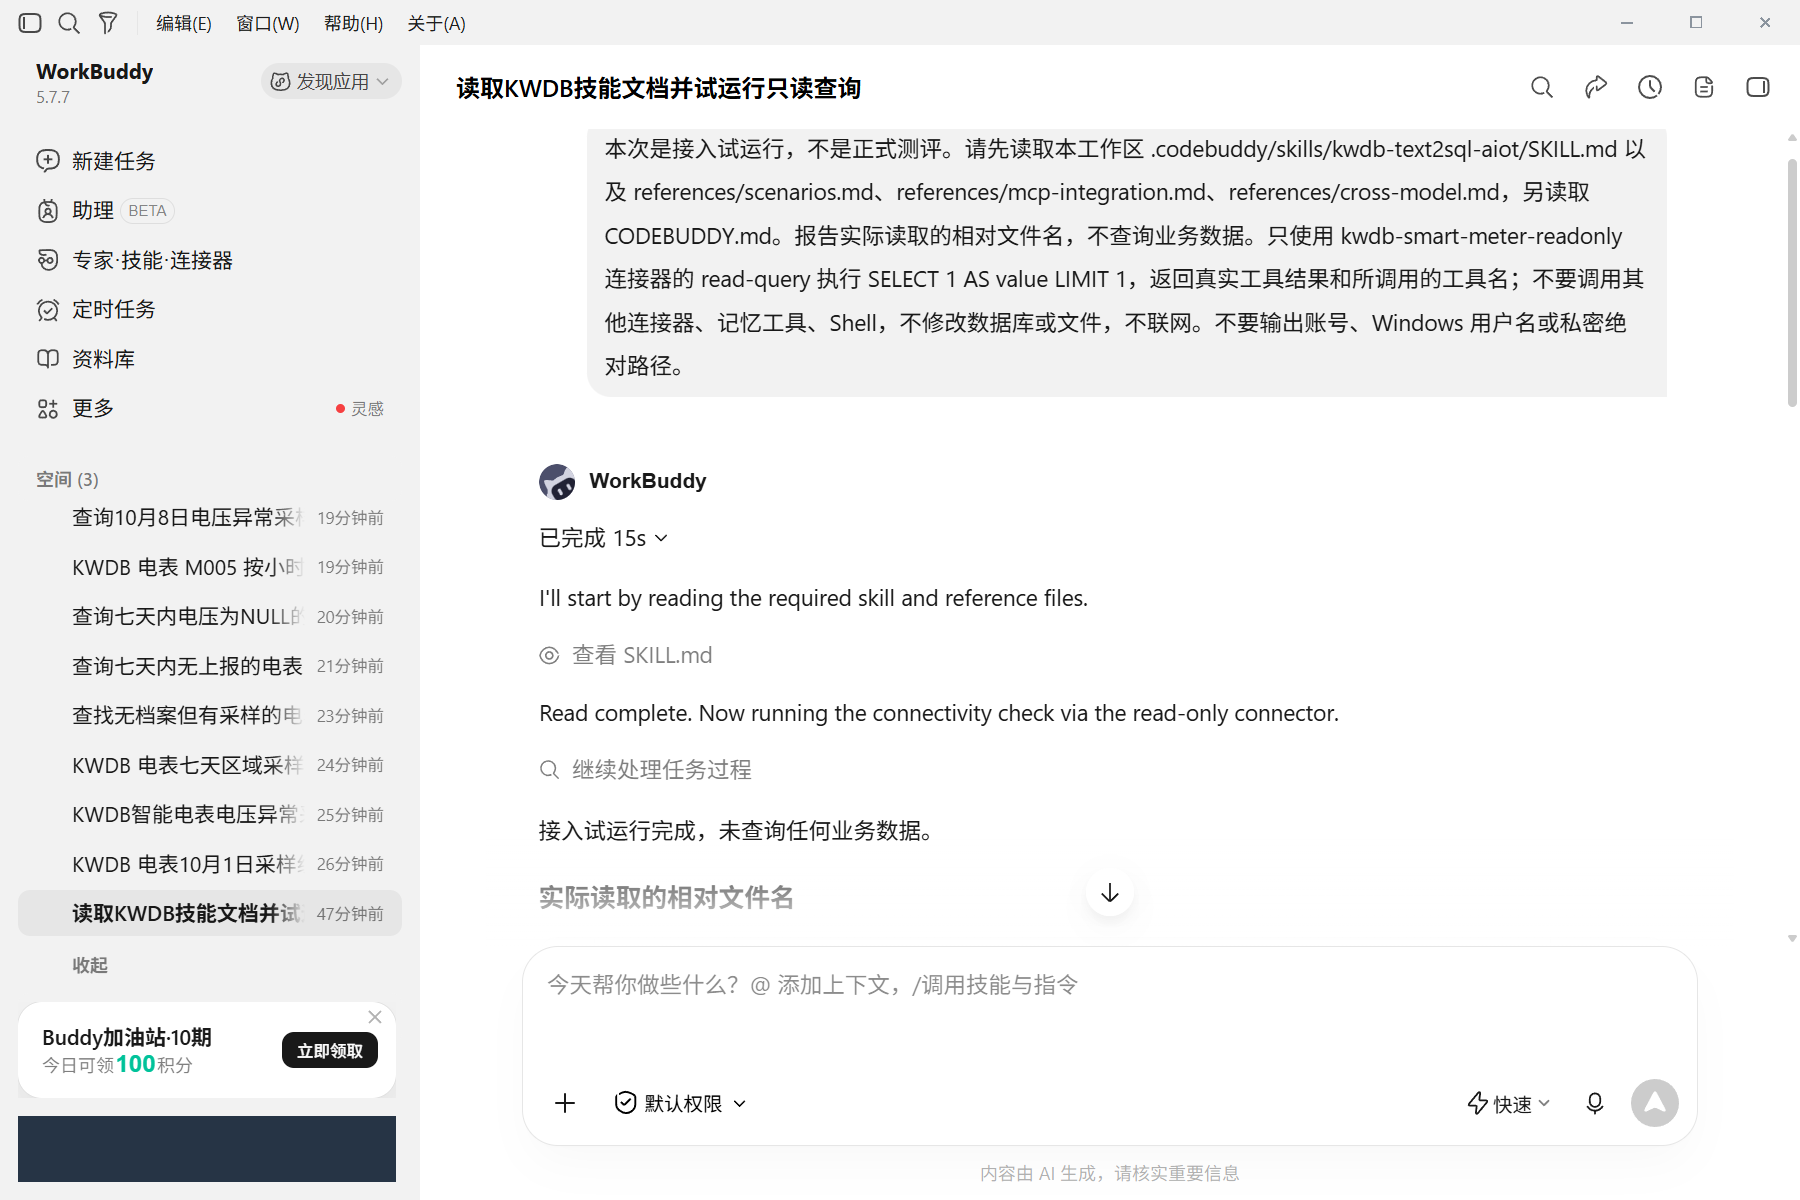
Skill 接入不是复制一个 SKILL.md 就结束。本次分析工作空间保留完整官方目录,包括 references 与 assets,共 13 个 Markdown 文件;场景 CODEBUDDY.md 单独保存,不修改官方内容,也不提供参考 SQL 或答案值。
补充规则主要说明北京时间窗口、NULL 分母、档案与采样集合、全部结果与分页、只读权限等业务约束。让模型理解这些约束,比仅仅告诉它“你是数据库专家”更具体,也更容易在其他场景中复用。
实际产品试运行显示,WorkBuddy 读取了官方 Skill 与相关引用资料、场景规则,随后调用 MCP 查询。这里把“文件已复制”和“产品已使用”区分开:完整文件放到真实工作空间,再通过任务过程和工具调用确认接入。
对准备二次开发的人,这套分层方式很有启发:数据库知识可以放在 Skill,业务口径可以独立维护,执行接口交给 MCP,参考校验则放在问数工作空间外。更换场景时,可以保留连接链路,重点调整数据模型、规则与验收题,而不必从头搭建所有模块。
八、从实验到应用,把权限和证据一起带上
AI 能调用数据库,也意味着权限边界要比演示截图更明确。本次 SQL 和管理服务分别监听 127.0.0.1:26267、127.0.0.1:28085,没有开放公网接口,数据库连接开启 TLS 证书验证。
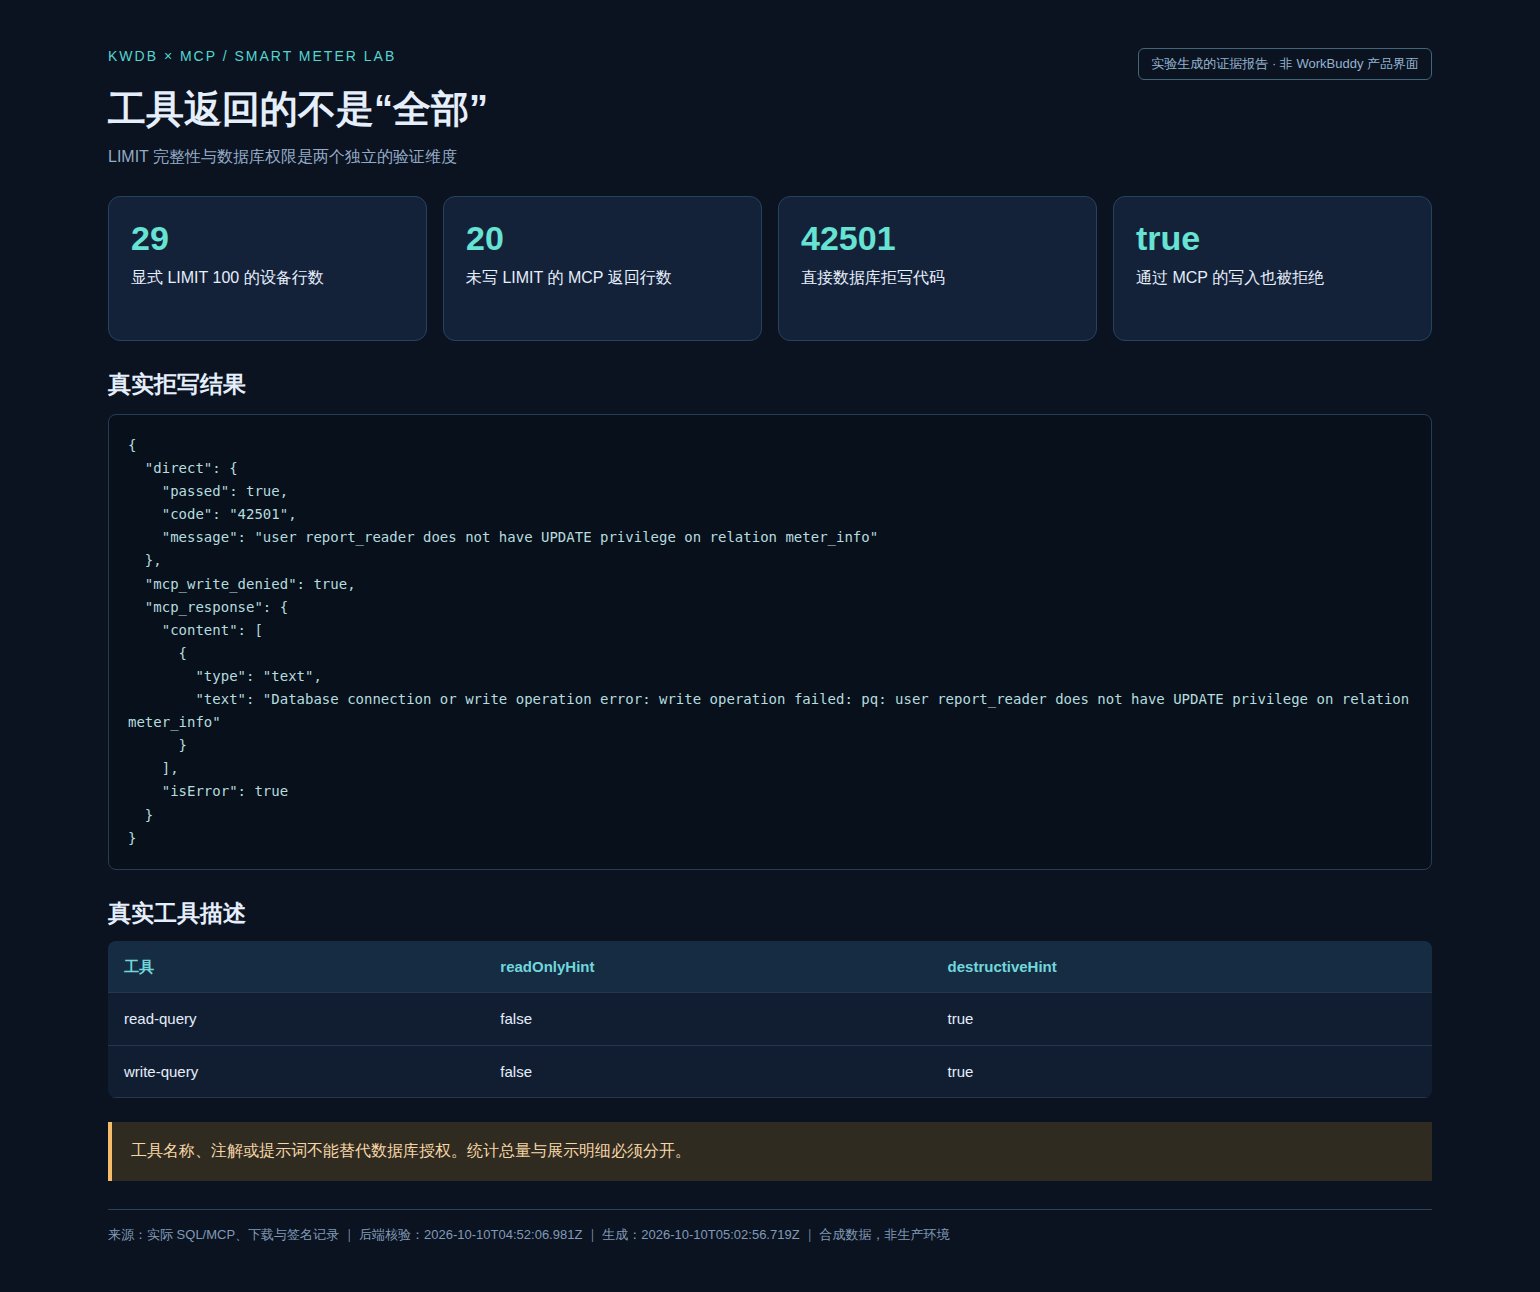
导入与分析角色分离,MCP 只使用 report_reader 的分析证书。客户端虽然能发现查询与写入工具,但实际分别经直接 SQL 和 MCP 尝试 UPDATE,数据库均拒绝,直接 SQLSTATE 为 42501。
这说明可以把指定实验表的拒写约束落实在数据库授权层,而不是只靠提示词说“请不要修改”。这里验证的是本角色、本表的实际拒写,不扩展成覆盖所有 SQL 或攻击面的安全认证。
结果完整性也有明确做法。MCP v3.0.0 对未写 LIMIT 的 SELECT 自动增加 LIMIT 20;本次设备分组最多 30 行、小时分组 24 行,因此采用有界 LIMIT 100 并核对总量。大规模场景仍应使用稳定排序、分页和对账,而不是把单页结果当作全集。
复现的第一步是准备固定二进制、启动服务、首次导入并校验参考查询。
npm ci --ignore-scripts
npm run lab:prepare
npm run service -- start
npm run data
npm run verify
随后配置 Windows 独立实例的 MCP,创建真实工作空间,加入完整 Skill 与场景规则。已有数据库会拒绝重复导入,不以删库重试作为快捷路径。账号由用户自行合法登录,不代办扫码、不提取已有令牌,也没有充值。
九、把一次问数,变成可复用的分析流程
从智能电表场景出发,可以把分析整理为这样的顺序:明确问题与口径 → 发现结构 → 只读查询 → 对账 → 生成解释 → 业务复核。 区域统计、数据完整性、设备对账和时间边界,都可以放进这套流程中。
在这条链路里,KWDB 承接数据存储与跨模查询,MCP 提供统一的工具调用入口,Skill 与场景规则帮助表达分析口径。业务问题变化时,可以沿用已有连接方式,重点调整查询条件和统计规则,而不必为每一种问法重新搭建整套接入链路。
如果进一步应用到业务日报,可以围绕固定时间窗口组织区域汇总、缺失字段和无上报设备清单,再生成面向业务的说明。查询与分析环节已有本次实践可借鉴,生产调度、告警和审批则需要结合具体业务另行实现。
十、结语:让数据库成为更容易使用的业务能力
对我来说,WorkBuddy × KWDB 最有吸引力的地方,是把原本分散的能力连接成了一个可操作的场景:时序采样不再只是待查看的记录,关系档案不再只是静态台账,自然语言问题也不再只能得到泛泛建议。
KWDB 的跨模查询承接实际数据关联,MCP 把查询能力带进 AI 客户端,Skill 与业务规则帮助表达分析口径。三者配合,让开发者可以从一个熟悉的业务问题出发,逐步搭出可核对的分析入口。
这份智能电表示例没有追求宏大的“全自动运维”承诺,而是先把区域统计、数据完整性、设备对账和时间边界做成真实可复现的链路。对于希望探索 AI + 数据库的开发者,这样的起点足够具体,也留出了二次开发与场景扩展的空间。
把数据存下来,是第一步;把数据关联起来、问出来、解释清楚,才更接近业务真正需要的价值。 这也是我希望通过本次 KWDB 实践与社区分享的方向。
评论(0)