
前言
文档目的
TSBS(Time Series Benchmark Suite)是目前使用最广的时序数据库基准工具。它的设计目标是横向比较不同时序数据库的实现效率,因此把全部用例收敛到「单表 + 标签过滤 + 时间聚合」这一共同交集上。这个取舍保证了结论的可比性,同时也决定了它无法考察「关系表与时序表联合访问」这一类能力。
KWDB 是多模数据库,同一实例内同时提供时序引擎与关系引擎,跨引擎关联是其基础能力之一。这项能力不在 TSBS 的量程之内。
本文档以一次真实的二次开发为例,为 kwdb-tsbs 补充跨模(multi-mode)用例,并对该用例执行受控对照实验与代价分解。全部过程与数字均来自真机执行,配套 13 个阶段的复现脚本。
读者对象
本文档面向以下读者:
- 需要在 KWDB 上评估跨模查询代价的数据库工程师;
- 需要为基准工具补充自定义用例的测试开发人员;
- 关注多模数据库能力边界的架构设计人员。
阅读本文档需要的基础:熟悉 SQL,能够使用 Linux 命令行。不要求具备 KWDB 或 TSBS 的先前使用经验。
复现方式
本文档按阶段组织,全部脚本收录于配套脚本包。复现的最小操作如下:
tar -xzf kwdb_tsbs_multimode_v3.tar.gz
cd kwdb_tsbs_multimode/reproduce
vi mm_env.sh          # 确认主机、端口、证书目录与工作路径
bash run_all.sh       # 依次执行 13 个阶段
脚本为纯 Shell 实现,除 Go 工具链外不依赖其他第三方组件。每个阶段可独立执行、可重复执行,并在结束时打印成功判据。
若未取得脚本包,可直接使用本文档正文中的脚本全文。第 4 章起,每个阶段的脚本都完整列出,与包内文件为同一份内容。
文档约定
| 约定 | 含义 |
|---|---|
代码字体 |
文件名、命令、参数、SQL 关键字 |
| 加粗 | 首次定义的术语 |
[ OK ] [WARN] [FAIL] |
脚本输出的状态标记,[FAIL] 会中止当前阶段 |
| 标注为「实测输出」的代码块 | 真机执行回显,未做摘改 |
| 阶段 00 – 12 | 复现流程的 13 个步骤,编号与脚本文件名前缀一致 |
正文中的「注意」「提示」「警告」三种提示块含义如下:
- 注意:可能引起误解或结果偏差的事项;
- 提示:可以简化操作或提高效率的做法;
- 警告:会导致阶段失败或结论失效的操作。
术语
| 术语 | 说明 |
|---|---|
| 多模(multi-mode) | KWDB 在同一实例内同时提供时序引擎与关系引擎 |
| 跨模查询 | 一条 SQL 同时访问时序表与关系表 |
| 时序库 / 关系库 | engine_type 分别为 TIME SERIES / RELATIONAL 的数据库 |
| 跨模臂 | 用一条跨模 SQL 完成查询的实现方式 |
| 拆分臂 | 用时序、关系两条单模 SQL 加应用层拼接完成同一查询的实现方式 |
| 量程 | 基准工具能够覆盖的查询形态范围 |
| 分辨率 | 在已覆盖的形态范围内,基准区分快慢的能力 |
相关文档
| 内容 | 位置 |
|---|---|
| kwdb-tsbs 源码 | https://github.com/KWDB/kwdb-tsbs |
| TSBS 原始仓库 | https://github.com/timescale/tsbs |
| KWDB 安装部署 | 同系列《KaiwuDB CCL 3.2.2 部署与验证》 |
1 概述
本章给出主要结论、问题界定、文档组织方式以及数据口径。
1.1 主要结论
本文档全部结论来自真机实测,环境见 3.1 节,每条结论均可在对应阶段的实测输出中逐条核对。
结论一:TSBS 的缺口在量程,不在分辨率。
在已覆盖的形态内,TSBS 的刻度是够用的。本文复现的官方 29 个模板,中位延迟从 0.55 ms 到 317.04 ms,跨度 576 倍,快慢两端区分明显。缺口在于没有度量「多维关联」的手段:KWDB 方言的 3 个 Go 源文件中,SQL 文本里的 JOIN 出现 0 次;作为对照,timescaledb/iot.go 出现 13 次。
结论二:跨模查询的代价结构内部分化显著,不宜笼统描述为「慢」。
代价分解(第 10 章)的结果如下:
| 查询形态 | 耗时(含客户端固定开销) | 相对纯时序基线 |
|---|---|---|
| 纯时序按 tag 分组(基线) | 53 ms | 1× |
| 跨模等值 JOIN(一跳 / 两跳) | 54 ms | +1 ms |
| 跨模非等值时间 JOIN(窗口右界逐行不同) | 2337 ms | 约 44× |
等值联结引入关系维度的代价可以忽略;代价集中出现在非等值时间联结上,原因是逐行不同的时间窗口无法做等值下推。两类形态需要分别描述,否则会把优化方向引向「跨模」这一整体标签。
结论三:补充该维度的首要价值是可观测,而非性能提升。
受控对照实验(第 10 章)中,5 个跨模模板的跨模臂只有 1 个胜出(mm-driver-window,12.19 ms 对 19.49 ms),其余 4 个更慢。因此本文档并不主张跨模查询更快,而是指出:基准若不提出某类问题,就无法给出该类问题的答案,其中既包括「代价很低」的答案,也包括「代价很高」的答案。
1.2 问题界定
基准工具的职责是在给定的测量范围内提供有区分度的刻度。TSBS 面向多实现横向比较,因此把用例约束在「单表 + 标签过滤 + 时间聚合」这一共同交集内,这是合理的工程取舍。
由此产生的边界是:凡必须跨表或跨引擎才能表达的查询形态,均不在量程之内。KWDB 的多模能力恰好完整落在该边界之外。
本文档的工作可以理解为为该基准增加一段量程,而不是对其准确性提出异议。
1.3 文档组织与复现路径
第 5 章至第 11 章按阶段推进,每个阶段对应一个可独立执行的脚本。环境满足 3.2 节的前置条件后,按顺序执行即可。
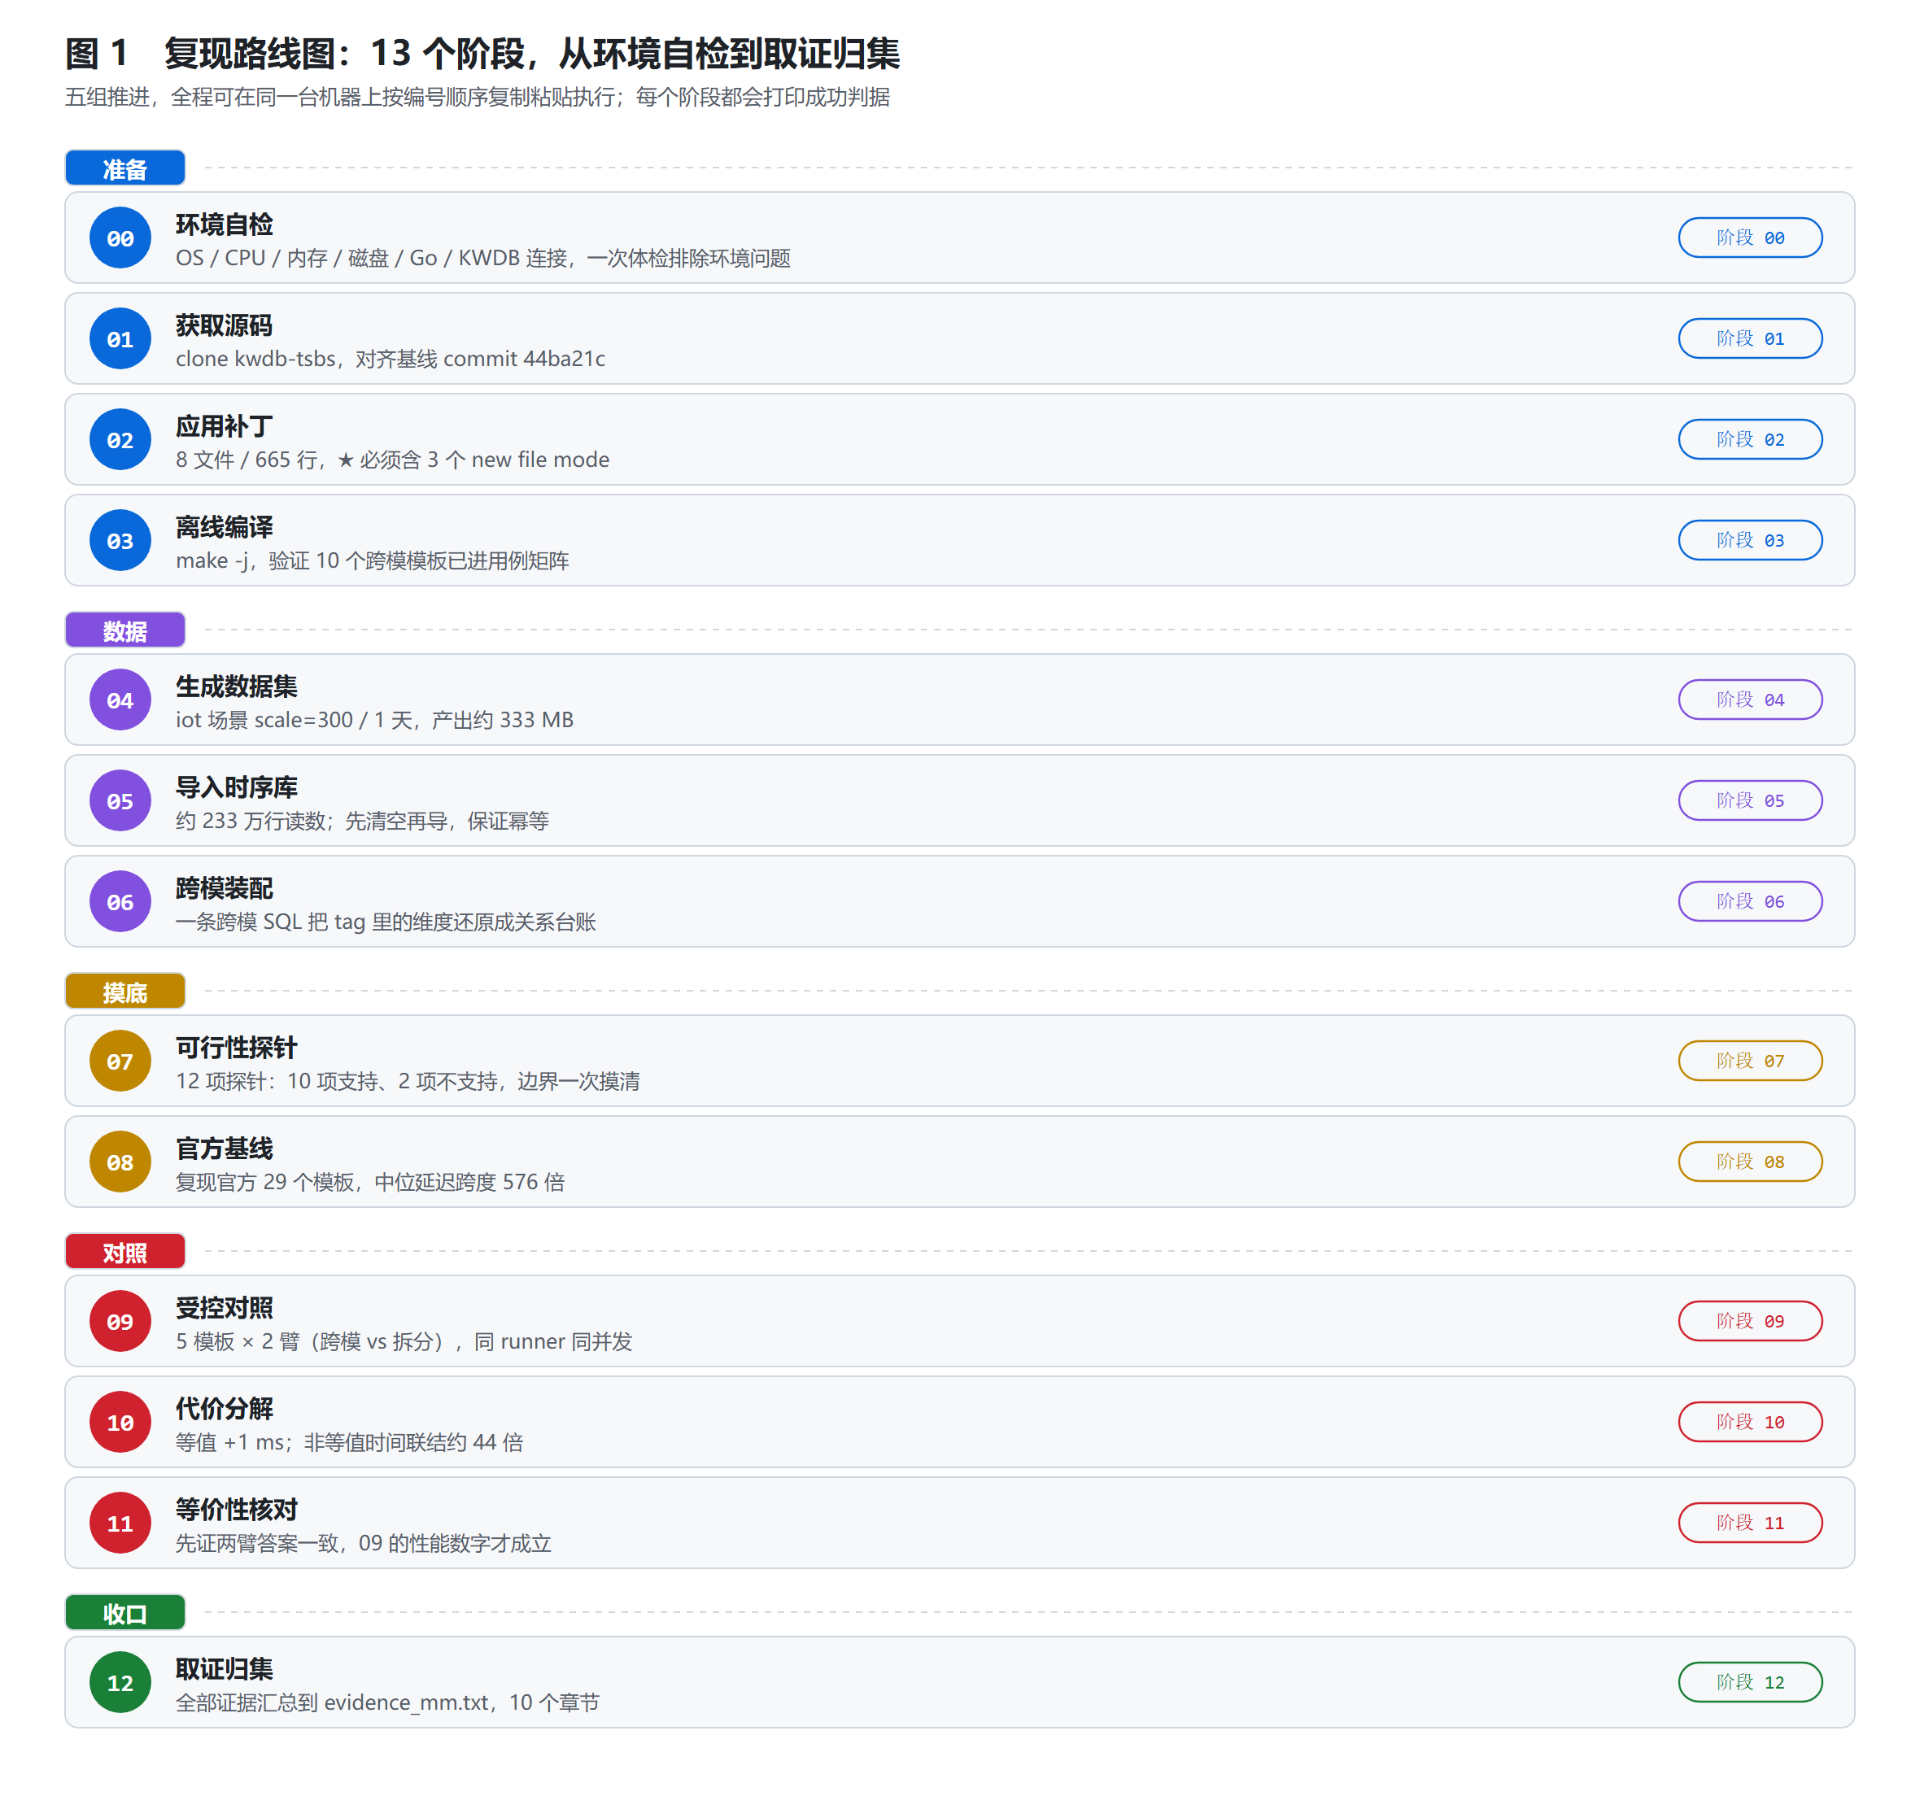
| 阶段 | 名称 | 说明 | 章节 |
|---|---|---|---|
| 00 | 环境自检 | 核对操作系统、磁盘、Go 工具链、KWDB 连接 | 5 |
| 01 | 获取源码 | clone kwdb-tsbs 并对齐基线 commit | 6.1 |
| 02 | 应用补丁 | 应用本次二次开发的 8 个文件改动 | 6.2 |
| 03 | 编译 | 离线编译,验证 10 个跨模模板已注册 | 6.3 |
| 04 | 生成数据 | 生成 iot 数据集 | 7.1 |
| 05 | 导入 | 导入时序库,先清空再导入 | 7.2 |
| 06 | 跨模装配 | 用一条跨模 SQL 从 tag 还原关系台账 | 7.3 |
| 07 | 可行性探针 | 12 项探针,确定可用与不可用的写法 | 8 |
| 08 | 官方基线 | 复现官方 29 个模板 | 9 |
| 09 | 受控对照 | 跨模臂与拆分臂配对测量,5 组 | 10.2 |
| 10 | 代价分解 | 将总耗时拆分为 6 条最小查询 | 10.4 |
| 11 | 等价性核对 | 先确认两臂答案一致,再做性能比较 | 10.6 |
| 12 | 取证归集 | 汇总全部证据至单个文件 | 11 |
每个阶段结束时打印下一步应执行的脚本,按提示顺序执行即可。
1.4 数据口径
为避免误读,先行说明以下事项。
环境口径:本文环境为单机单副本加 TLS 的 KWDB 3.2.2 CCL,不是官方推荐的生产配置。文中所有绝对延迟数字与硬件相关,可迁移的结论是比值。
数据口径:数据集为 TSBS 自带的合成数据(scale=300,1 天,采样间隔 10 s),不含真实业务数据。
脱敏口径:文中出现的主机地址属于 RFC 1918 私网地址段,不涉及公网资产;文中不含账号与口令。
评价口径:本文档对 TSBS 的全部评价限定在量程边界这一范畴,不涉及其代码质量。
2 技术背景
本章介绍 TSBS 的体系结构、KWDB 的多模模型,以及两项支撑「量程缺口」判断的证据。
2.1 TSBS 体系结构
TSBS 本身不是测试程序,而是一组工具,将基准过程拆为四步:
tsbs_generate_data        →  生成伪 CSV 格式的数据文件(.dat)
tsbs_load_<db>            →  将 .dat 导入目标数据库
tsbs_generate_queries     →  生成查询文件(gob 编码,按 query type 分文件)
tsbs_run_queries_<db>     →  读取查询文件,按并发执行并统计延迟
其中两项设计直接关系到本次二次开发:
- 查询模板可插拔:每个数据库方言(
databases/<db>/)自行提供一套生成器,把模板渲染为对应数据库的 SQL。本次开发新增的即为一个方言文件。 - 用例矩阵注册全部可用 query type:不带参数执行
tsbs_generate_queries时,程序会列出其识别的全部 query type。这构成第 6.3 节验证「10 个跨模模板是否注册成功」的依据。
2.2 KWDB 多模模型与跨模查询
KWDB 在同一实例内可同时存在时序引擎与关系引擎。执行以下 SQL 可以确认:
SELECT database_name, engine_type FROM [SHOW DATABASES] ORDER BY engine_type, database_name;
返回结果中同时出现 TIME SERIES 与 RELATIONAL 两种 engine_type,这是跨模查询的物理基础。
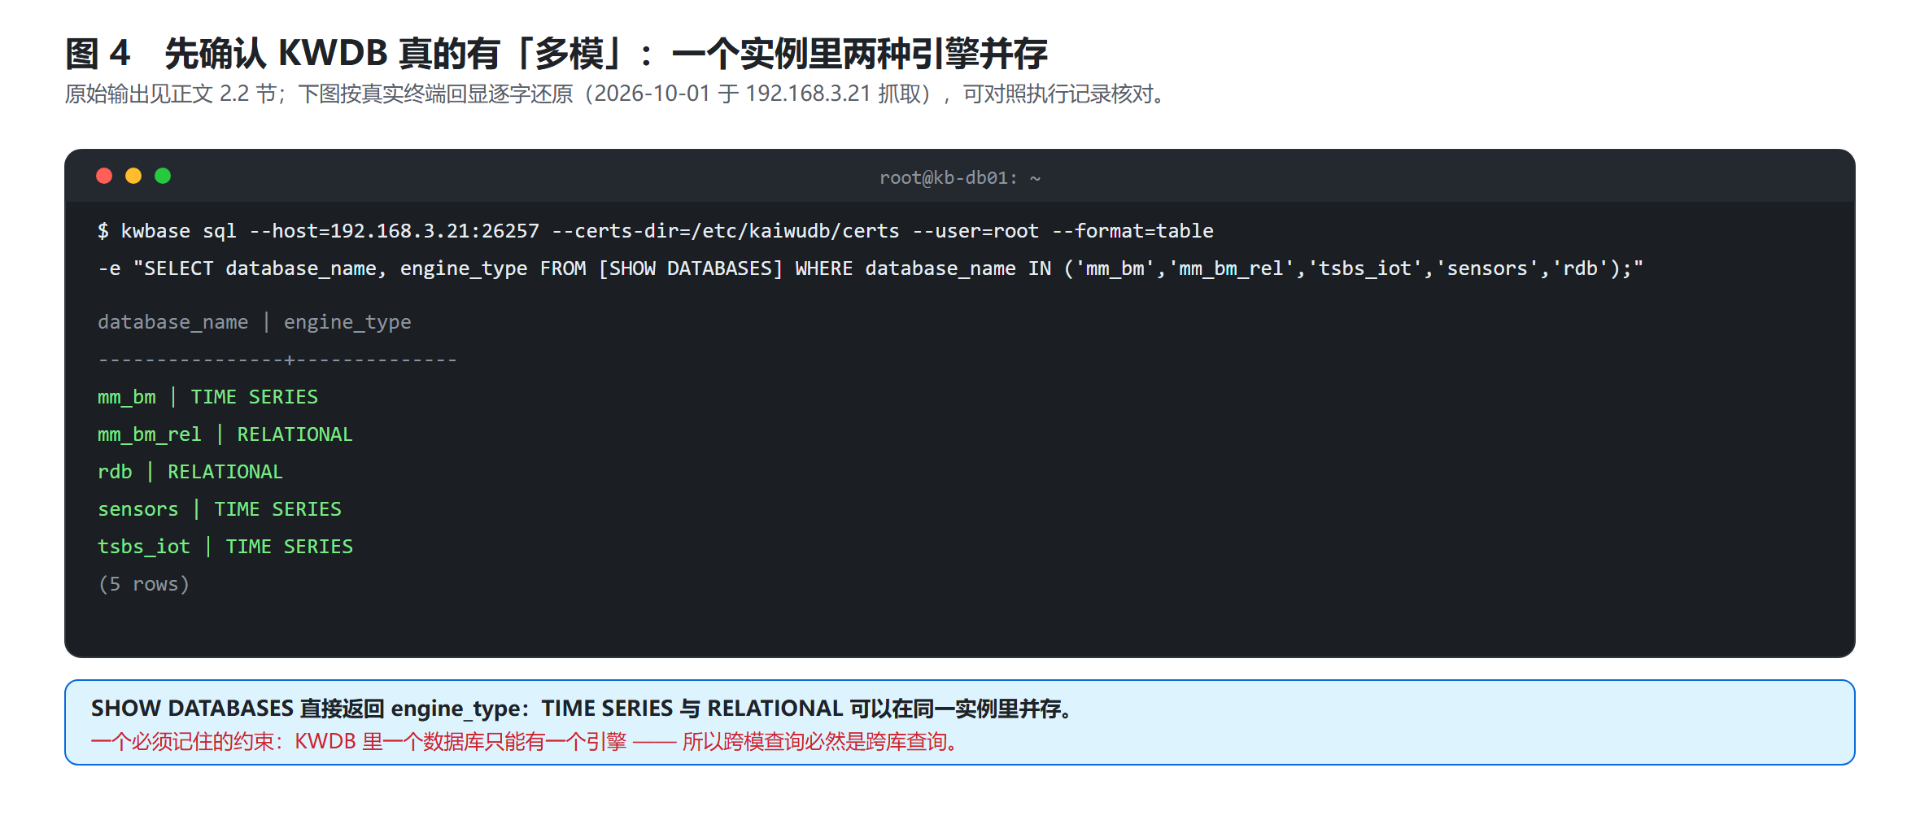
(上图按真实终端回显逐字还原,命令与本节的 SQL 一致。阶段 12 会重新执行一次并纳入取证。)
在 KWDB 中,跨模查询的具体含义是一条 SQL 同时访问时序表与关系表。典型场景是将设备台账、组织架构、合同、工单等主数据置于关系表,将测量值置于时序表,然后用一条 SQL 完成如下查询:
- 每个区域的日均油耗是多少(区域在关系表,油耗在时序表);
- 哪些车辆的峰值载重超过其额定载重(额定载重在关系表,峰值载重在时序表);
- 某车辆在其投运之后的行驶时长是多少(投运日期在关系表,行驶记录在时序表)。
这三类查询形态均不在 TSBS 官方模板的覆盖范围内。
2.3 物理约束:一个数据库只能有一个引擎
以下约束决定了本文档全部脚本的库命名约定,也是初次使用最容易忽略的一点。
注意:KWDB 中一个数据库只能有一个引擎。因此关系表与时序表不能置于同一个数据库内,跨模查询必然是跨库查询。
据此,本文档采用的命名约定如下:
| 角色 | 库名 | 引擎 | 内容 |
|---|---|---|---|
| 时序库 | mm_bm |
TIME SERIES | readings / diagnostics(事实表) |
| 关系库 | mm_bm_rel |
RELATIONAL | trucks / fleets(维度台账) |
SQL 中引用时须写全 库.public.表 三段式。该写法在 7.3 节的装配 SQL 中会多次出现。
2.4 证据一:官方模板中不存在跨模关联
判断某一能力是否在基准覆盖范围内,需要计数而非印象。方法为统计各方言目录下 Go 源文件中 SQL 文本里的 JOIN 出现次数。
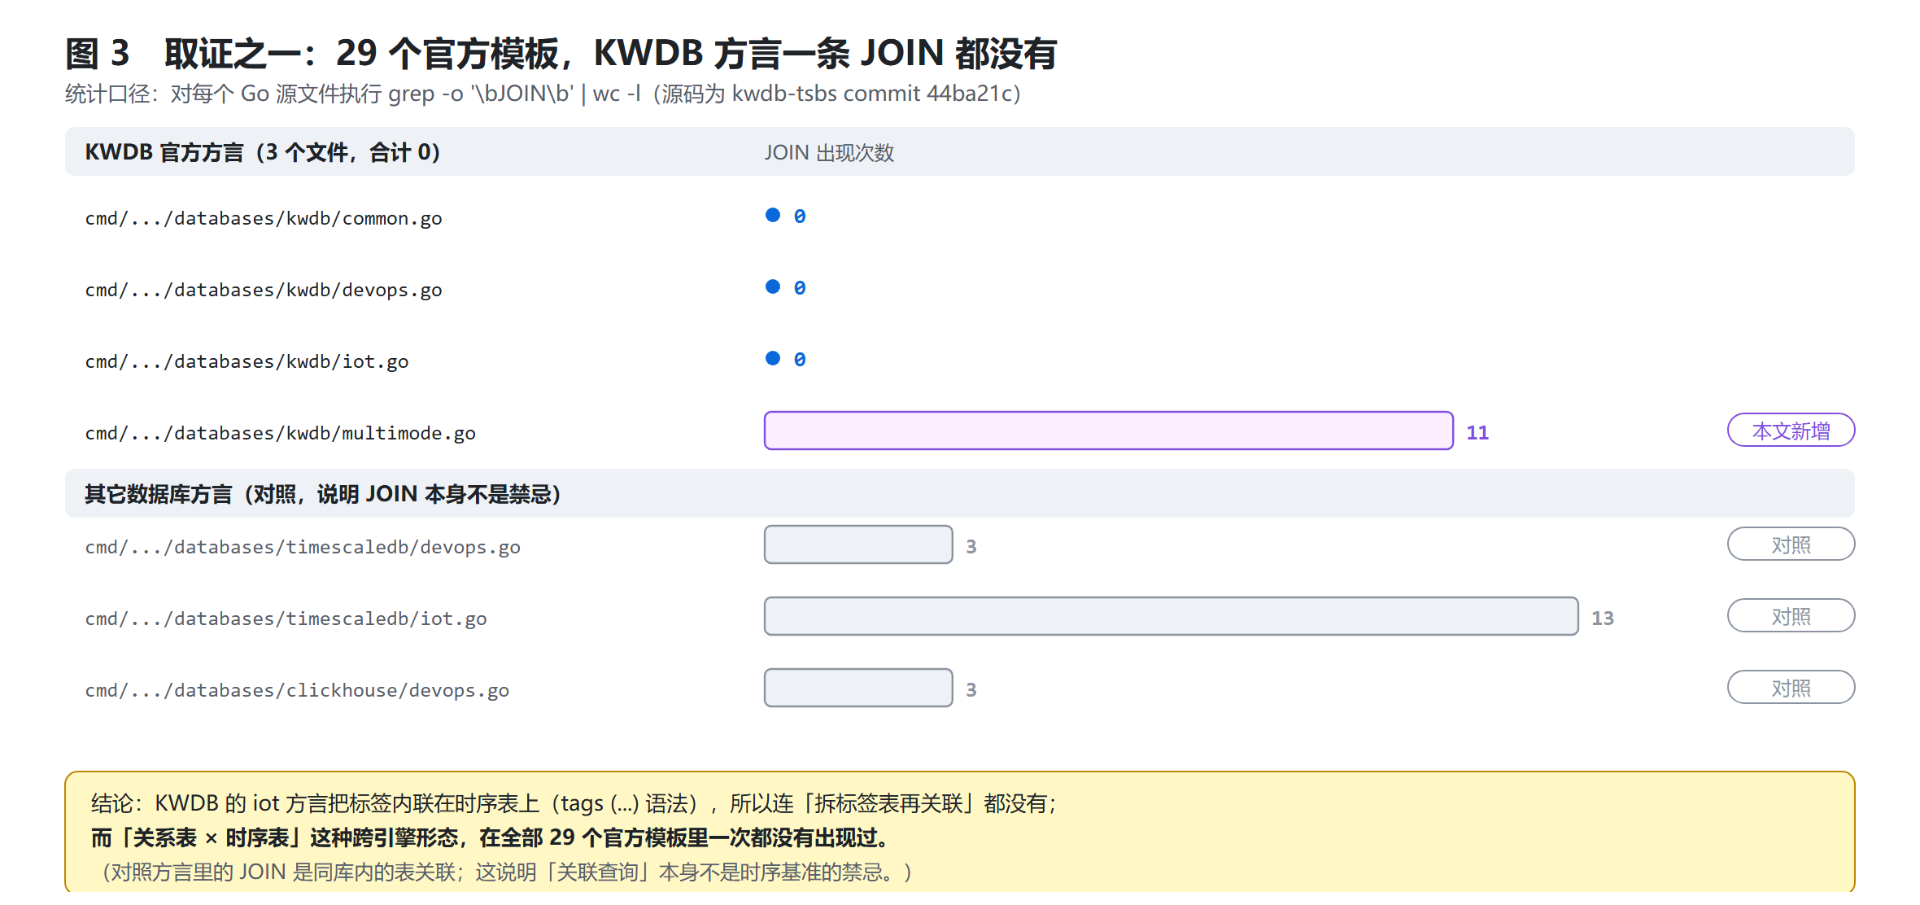
结果如下:
- KWDB 官方方言 3 个文件,
JOIN合计 0 次; - 对照方言:
timescaledb/iot.go为 13 次,timescaledb/devops.go为 3 次,clickhouse/devops.go为 3 次。
该对照说明 JOIN 本身并非时序基准的禁忌,其他方言在使用。KWDB 方言中不出现 JOIN,原因是 TSBS 的 iot 用例把维度内联进了时序表(使用 KWDB 的 tags (...) 语法),因而省去了「拆出标签表再关联」这一层。
本文新增的 multimode.go 中 JOIN 出现 11 次,即 1.2 节所述新增量程的实现。
2.5 证据二:维度的内联机制
iot 用例之所以不需要 JOIN,是因为其业务维度并未存放在关系表中。
TSBS 生成 iot 设备时,一台车辆的 8 个标签定义于 pkg/data/usecases/iot/truck.go:110:
tags: []common.Tag{
    {Key: []byte("name"), Value: fmt.Sprintf(truckNameFmt, i)},
    {Key: []byte("fleet"), Value: common.RandomStringSliceChoice(FleetChoices)},
    {Key: []byte("driver"), Value: common.RandomStringSliceChoice(driverChoices)},
    {Key: []byte("model"), Value: m.Name},
    {Key: []byte("device_version"), Value: common.RandomStringSliceChoice(deviceVersionChoices)},
    {Key: []byte("load_capacity"), Value: m.LoadCapacity},
    {Key: []byte("fuel_capacity"), Value: m.FuelCapacity},
    {Key: []byte("nominal_fuel_consumption"), Value: m.FuelConsumption},
},
其中 fleet、driver、model、load_capacity 在真实业务模型中属于主数据,通常应当具备主键、外键与历史版本。在该用例中,四者全部被降级为时序表的标签。
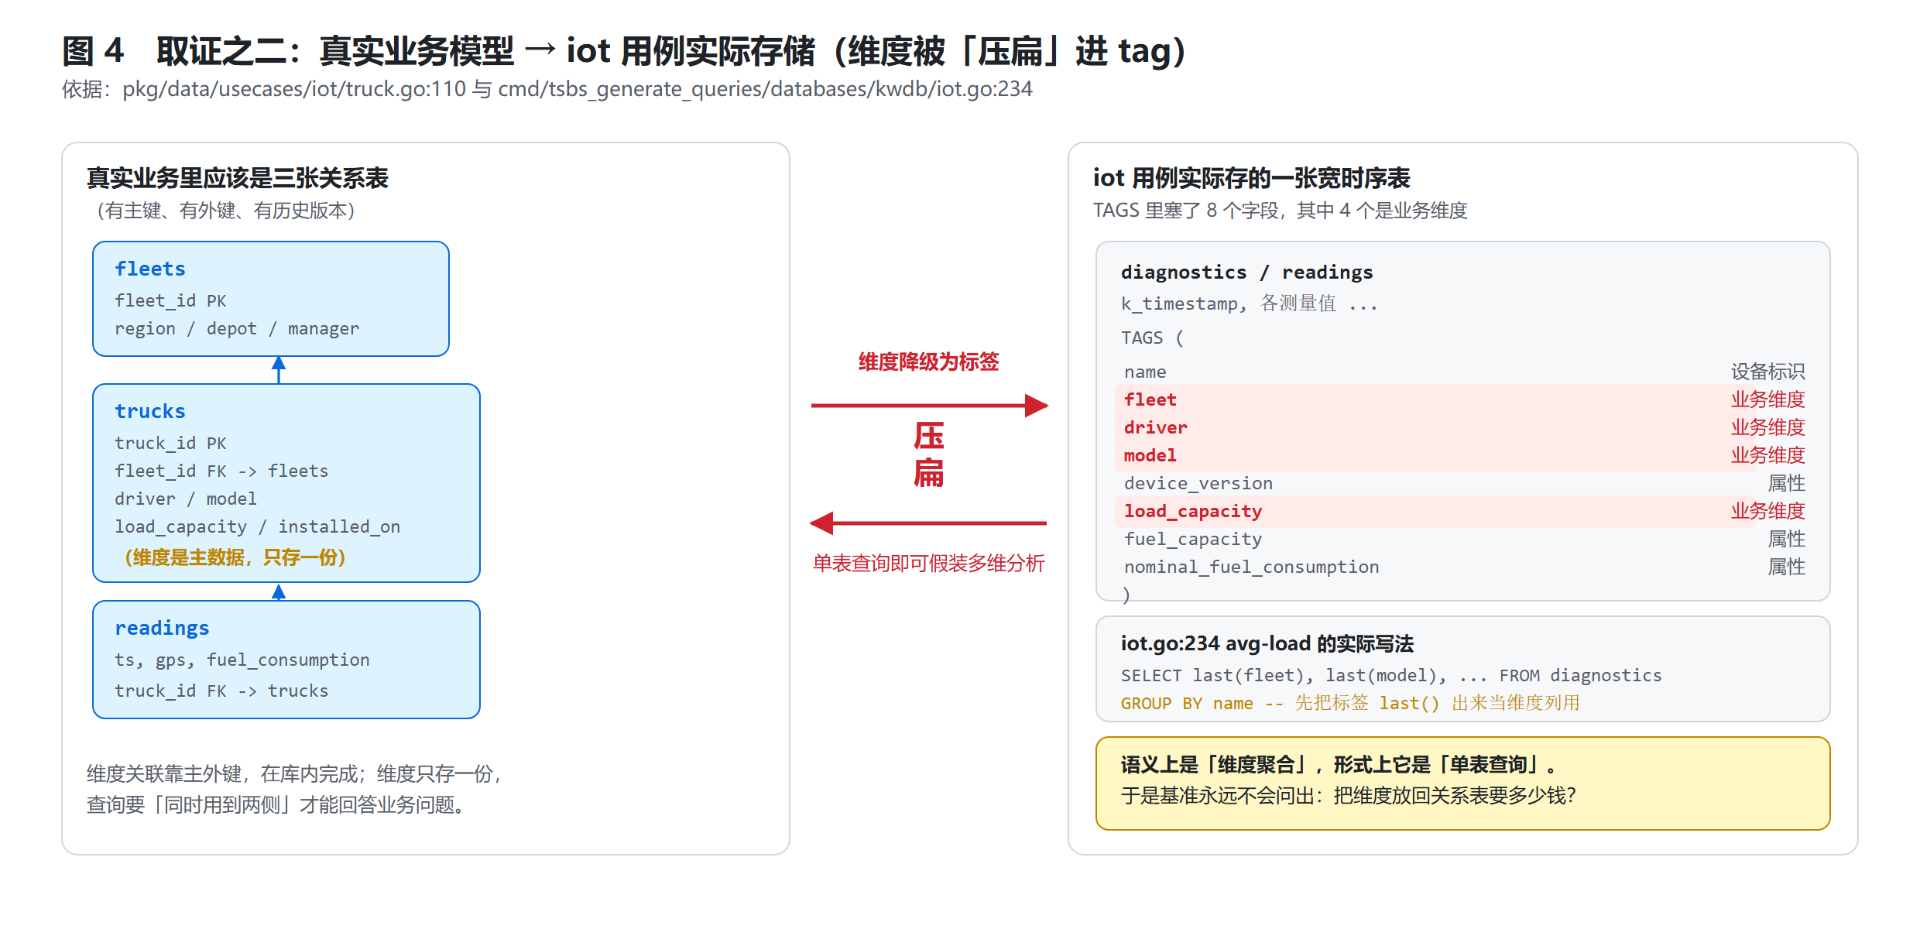
这一处理方式带来一个连带结果。cmd/tsbs_generate_queries/databases/kwdb/iot.go:234 中 avg-load 模板的写法为:
SELECT last(fleet), last(model), ...
FROM diagnostics
GROUP BY name   -- 先把标签 last() 出来当维度列用
该查询在语义上是维度聚合(按车队汇总),在语法形式上是单表查询。last(fleet) 的作用等价于从标签中取出被内联的那个字段。
由此可以确定缺口的完整机制:把维度内联进 tag 之后,用单表查询即可完成多维分析的形式表达。基准因此不会提出「把维度放回关系表、再用一条 SQL 关联回来,代价是多少」这一问题。
第 8 章的 12 项探针与第 10 章的代价分解,回答的正是该问题的后半部分。
3 环境准备
3.1 环境基线
以下为本文件全部数字的来源环境,与阶段 00 的自检输出一致。
| 项目 | 实测值 |
|---|---|
| 操作系统 | CentOS Linux release 7.9.2009 (Core) |
| 内核 | 3.10.0-1160.el7.x86_64 |
| CPU | AMD Ryzen 7 5700X 8-Core(8 核) |
| 内存 | 31 GB |
| 数据盘 | 独立 LVM 卷挂载至 /tsbs,可用 145 GB |
| Go | go1.24.0 linux/amd64 |
| KWDB | KaiwuDB Version 3.2.2,Build Time 2026/08/04 03:57:59,Distribution CCL |
| 部署形态 | 单机单副本加 TLS(--certs-dir=/etc/kaiwudb/certs),SQL 端口 26257 |
| 基准源码 | kwdb-tsbs commit 44ba21c(2026-08-27,增加参数 --mean-mode=standard|trimmed) |
注意:单机单副本不是官方推荐的生产配置。本文档中的绝对毫秒数仅在本环境下可比,跨环境请使用比值。
3.2 前置条件
复现前逐项确认以下条件。阶段 00 会自动核对,此处供人工检查。
| 序号 | 项目 | 要求 | 检查方式 |
|---|---|---|---|
| 1 | KWDB | 3.2.2 已安装且服务运行中 | systemctl is-active kaiwudb |
| 2 | 客户端 | kwbase 可执行 |
/usr/local/kaiwudb/bin/kwbase version |
| 3 | 证书 | TLS 证书目录存在 | ls /etc/kaiwudb/certs |
| 4 | Go | 1.21 以上,本文为 1.24.0 | go version |
| 5 | 数据盘 | 至少 20 GB 可用,本文为 145 GB | df -h /tsbs |
| 6 | 网络 | 仅获取源码一步需要,其余离线 | — |
| 7 | 第三方包 | 不需要任何第三方 Python 或 Go 包 | — |
提示:KWDB 本身的安装不在本文档范围内。若尚无可用实例,请先完成同系列《KaiwuDB CCL 3.2.2 部署与验证》,再回到第 5 章。
3.3 目录规划
编译缓存与数据集各会占用数 GB 空间,因此将代码与数据分开存放,避免写满根分区。
/opt/src/kwdb-tsbs/          源码树(编译产物在 bin/ 下)
/tsbs/                       独立数据盘挂载点
├── load_data/               生成的数据集(约 333 MB)
├── query_data/              生成的查询文件(gob 编码)
├── reports/                 报告与原始日志
│   ├── raw/                 逐模板原始日志与结果 JSON
│   ├── equiv/               两臂等价性核对素材
│   └── evidence_mm.txt      全部取证汇总
├── gocache/                 Go 构建缓存
└── gomodcache/              Go 依赖缓存
4 复现套件
4.1 设计说明
本文档早期版本采用「讲解加关键代码片段」的组织方式。该写法可读性尚可,但按其实施会遇到三处中断:
| 序号 | 中断点 | 后果 |
|---|---|---|
| 1 | 只给出新增 Go 文件的关键若干行 | 读者需自行定位并拼接文件。缺少任一新增文件会导致编译失败,报错为 undefined: multimode.NewCore,不指向真实原因 |
| 2 | 从导入数据开始叙述,未说明数据来源 | 首次执行即报 cannot open file .../iot_scale300_1d.dat |
| 3 | 脚本中固化了 IP、路径、库名 | 更换机器需全文检索替换,遗漏一处即失败 |
因此本版本将全部流程改写为脚本套件,遵循以下规则:
- 全部可变参数(IP、端口、路径、库名、规模)集中于
mm_env.sh一个文件,其余脚本不固化取值; - 每个阶段可独立执行、可重复执行,结束时打印下一步应执行的脚本;
- 每个阶段打印成功判据(
[ OK ]/[FAIL]/[WARN]),出现[FAIL]时立即终止并保留现场; - 13 个阶段支持一键连跑,也可从任意阶段续跑。
4.2 文件清单
reproduce/
├── mm_env.sh            公共配置与工具函数(唯一需要按环境修改的文件)
├── run_all.sh           一键总控(支持起止阶段)
├── 00_env_check.sh      环境自检
├── 01_get_source.sh     获取源码并对齐基线 commit
├── 02_apply_patch.sh    应用 multi-mode 补丁(幂等)
├── 03_build.sh          离线编译 + 验证 10 个模板注册
├── 04_gen_data.sh       生成 iot 数据集(scale=300,1 天)
├── 05_import.sh         导入时序库(幂等:先清空再导入)
├── 06_assemble.sh       跨模装配关系台账
├── 07_probe.sh          12 项跨模可行性探针
├── 08_baseline.sh       复现官方 29 个模板基线
├── 09_bench.sh          受控对照:跨模臂与拆分臂
├── 10_decompose.sh      代价分解
├── 11_equiv.sh          两臂答案等价性核对
├── 12_evidence.sh       一次性归集全部取证
├── patch/
│   └── mm_multimode.patch   完整补丁(8 文件 / 665 行,含 3 个新增文件)
└── sql/
    └── mm_dataset.sql       跨模装配 SQL
4.3 配置文件 mm_env.sh
以下文件是套件中唯一需要按环境修改的部分。通常只需确认数据库连接与源码路径两项,其余保持默认值即可。该文件只定义变量与函数,不产生副作用。
脚本 mm_env.sh(完整内容)
#!/bin/bash
<span id="heading-27" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-28" class="markdown-toc-anchor"></span>

# mm_env.sh —— 整套复现脚本的公共配置(唯一需要按你的环境修改的文件)
<span id="heading-29" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-30" class="markdown-toc-anchor"></span>

# 设计原则
<span id="heading-31" class="markdown-toc-anchor"></span>

#   1. 所有可变参数(IP / 端口 / 路径 / 库名 / 规模)都集中在这里,
<span id="heading-32" class="markdown-toc-anchor"></span>

#      其余脚本一律不写死值,改环境只改这一个文件。
<span id="heading-33" class="markdown-toc-anchor"></span>

#   2. 每一项都支持用环境变量覆盖,例如:
<span id="heading-34" class="markdown-toc-anchor"></span>

#        KWM_HOST=192.0.2.10 bash 09_bench.sh
<span id="heading-35" class="markdown-toc-anchor"></span>

#      (192.0.2.10 是 RFC 5737 保留给文档使用的地址,不可路由;
<span id="heading-36" class="markdown-toc-anchor"></span>

#        替换为你自己的主机地址。同理 198.51.100.0/24、203.0.113.0/24。)
<span id="heading-37" class="markdown-toc-anchor"></span>

#   3. 本文件只定义变量与函数,不执行任何有副作用的动作,可安全 source。
<span id="heading-38" class="markdown-toc-anchor"></span>

#
# 用法:在其它脚本开头写
<span id="heading-39" class="markdown-toc-anchor"></span>

#        . "$(dirname "$0")/mm_env.sh"
<span id="heading-40" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-41" class="markdown-toc-anchor"></span>


# ---- ① KWDB 数据库连接 ------------------------------------------------------
export KWM_PORT="${KWM_PORT:-26257}"            # SQL 端口
<span id="heading-42" class="markdown-toc-anchor"></span>


# 主机地址不写死,按实际监听套接字反查。
<span id="heading-43" class="markdown-toc-anchor"></span>

# 原因有两点:其一,kwbase 通常把 --listen-addr 绑到具体网卡而不监听回环,
<span id="heading-44" class="markdown-toc-anchor"></span>

# 写死 127.0.0.1 会得到 connection refused,且报错会误导为"服务未启动";
<span id="heading-45" class="markdown-toc-anchor"></span>

# 其二,把某个内网地址写成默认值,会使脚本换环境即失败。
_kwm_detect_host() {
  local raw h
  raw=$(ss -lntH 2>/dev/null | awk '{print $4}' | grep -E ":${KWM_PORT}\$" \
        | grep -vE '^(127\.|\[::1\])' | head -1)
  [ -z "$raw" ] && raw=$(ss -lntH 2>/dev/null | awk '{print $4}' | grep -E ":${KWM_PORT}\$" | head -1)
  [ -z "$raw" ] && raw=$(netstat -lnt 2>/dev/null | awk '{print $4}' | grep -E ":${KWM_PORT}\$" | head -1)
  h="${raw%:${KWM_PORT}}"
  h="${h#[}"; h="${h%]}"
  case "$h" in
    ""|"*"|"0.0.0.0"|"::") h=$(hostname -I 2>/dev/null | awk '{print $1}') ;;
  esac
  [ -z "$h" ] && h=127.0.0.1
  echo "$h"
}
export KWM_HOST="${KWM_HOST:-$(_kwm_detect_host)}"   # 数据库主机(自动探测)
export KWM_USER="${KWM_USER:-root}"             # 数据库用户
export KWM_CERTS="${KWM_CERTS:-/etc/kaiwudb/certs}"          # TLS 证书目录
<span id="heading-46" class="markdown-toc-anchor"></span>

                                                # 若为不带 TLS 的单机(--insecure),
<span id="heading-47" class="markdown-toc-anchor"></span>

                                                # 置为空串:KWM_CERTS= bash xx.sh
export KWM_BIN="${KWM_BIN:-/usr/local/kaiwudb/bin/kwbase}"   # 客户端二进制
<span id="heading-48" class="markdown-toc-anchor"></span>


# ---- ② kwdb-tsbs 源码与基线 ------------------------------------------------
export KWM_SRC="${KWM_SRC:-/opt/src/kwdb-tsbs}"  # 源码树(编译产物落在 $KWM_SRC/bin)
export KWM_TSBS_REPO="${KWM_TSBS_REPO:-https://gitee.com/kwdb/kwdb-tsbs.git}"
export KWM_TSBS_BASE="${KWM_TSBS_BASE:-44ba21c}" # 本文实测基线 commit
<span id="heading-49" class="markdown-toc-anchor"></span>


# ---- ③ 工作目录(建议放在独立数据盘上)------------------------------------
export KWM_ROOT="${KWM_ROOT:-/tsbs}"            # 数据盘挂载点
export KWM_LOAD="${KWM_LOAD:-${KWM_ROOT}/load_data}"    # 生成的数据集
export KWM_QD="${KWM_QD:-${KWM_ROOT}/query_data}"       # 生成的查询文件
export KWM_RPT="${KWM_RPT:-${KWM_ROOT}/reports}"        # 报告与原始日志
export KWM_RAW="${KWM_RAW:-${KWM_RPT}/raw}"             # 逐模板原始日志
<span id="heading-50" class="markdown-toc-anchor"></span>


# ---- ④ 数据集与库名 --------------------------------------------------------
export KWM_SCALE="${KWM_SCALE:-300}"            # TSBS scale(300 ≈ 300 辆车)
export KWM_TSDB="${KWM_TSDB:-mm_bm}"            # 时序库名(iot 数据)
export KWM_RELDB="${KWM_RELDB:-${KWM_TSDB}_rel}"   # 关系库名(一个库只能有一个引擎)
export KWM_CPUDB="${KWM_CPUDB:-tsbs_bench}"     # cpu-only 基线库(表结构不同,须独立)
export KWM_TS_START="${KWM_TS_START:-2026-01-01T00:00:00Z}"
export KWM_TS_END="${KWM_TS_END:-2026-01-02T00:00:01Z}"
export KWM_QNUM="${KWM_QNUM:-20}"               # 每个 query type 生成多少条查询
export KWM_WORKERS="${KWM_WORKERS:-1}"          # 查询并发;受控对照固定为 1
<span id="heading-51" class="markdown-toc-anchor"></span>


# ---- ⑤ 实验用的固定时间窗(两臂必须完全一致,否则不可比)------------------
export KWM_W1="${KWM_W1:-2026-01-01 06:00:00}"
export KWM_W2="${KWM_W2:-2026-01-01 07:00:00}"
<span id="heading-52" class="markdown-toc-anchor"></span>


# ---- ⑥ Go 工具链 -----------------------------------------------------------
export GOROOT="${GOROOT:-/usr/local/go}"
export GOTOOLCHAIN=local          # 禁止自动下载工具链(离线可编译的关键)
export GOFLAGS=-mod=vendor        # 用仓库自带 vendor 目录,全程不联网
export PATH="${PATH}:${GOROOT}/bin"
export GOCACHE="${GOCACHE:-${KWM_ROOT}/gocache}"
export GOMODCACHE="${GOMODCACHE:-${KWM_ROOT}/gomodcache}"
<span id="heading-53" class="markdown-toc-anchor"></span>


# ---- ⑦ 输出工具函数 --------------------------------------------------------
step() { printf '\n========== %s ==========\n' "$*"; }
ok()   { printf '[ OK ] %s\n' "$*"; }
warn() { printf '[WARN] %s\n' "$*"; }
fail() { printf '[FAIL] %s\n' "$*"; }
die()  { printf '[FAIL] %s\n' "$*"; exit 1; }
<span id="heading-54" class="markdown-toc-anchor"></span>


# 统一的 SQL 执行入口:table 形态,便于人眼核对
kwsql() {
  "$KWM_BIN" sql --host="${KWM_HOST}:${KWM_PORT}" --certs-dir="${KWM_CERTS}" \
    --user="${KWM_USER}" --format=table -e "$1"
}
<span id="heading-55" class="markdown-toc-anchor"></span>

# 统一的 SQL 执行入口:csv 形态,便于落盘做等价性核对
kwsql_csv() {
  "$KWM_BIN" sql --host="${KWM_HOST}:${KWM_PORT}" --certs-dir="${KWM_CERTS}" \
    --user="${KWM_USER}" --format=csv -e "$1"
}
<span id="heading-56" class="markdown-toc-anchor"></span>

# ★ 取单个标量值。
<span id="heading-57" class="markdown-toc-anchor"></span>

#   注意 kwbase 两种输出格式的行布局完全不同(实测):
<span id="heading-58" class="markdown-toc-anchor"></span>

#     --format=table : 第1行表头 / 第2行是横线分隔行 / 第3行才是数据
<span id="heading-59" class="markdown-toc-anchor"></span>

#     --format=csv   : 第1行表头 / 第2行起就是数据,且字段不带引号
<span id="heading-60" class="markdown-toc-anchor"></span>

#   写脚本时若按 table 去 sed -n '2p',拿到的会是 "----+----" 这种分隔线,
<span id="heading-61" class="markdown-toc-anchor"></span>

#   而且不报错——是个很隐蔽的坑。这里统一走 csv + 第 2 行。
kwsql_scalar() {
  kwsql_csv "$1" 2>/dev/null | sed -n '2p' | tr -d '", \r'
}
<span id="heading-62" class="markdown-toc-anchor"></span>

# 计时执行一条 SQL,打印耗时与结果行数
kw_time() {  # kw_time <名称> <SQL>
  local name="$1" sql="$2" t0 t1 out rc
  t0=$(date +%s%N)
  out=$(kwsql "$sql" 2>&1); rc=$?
  t1=$(date +%s%N)
  printf '%-30s rc=%s  %6d ms  %s\n' "$name" "$rc" "$(( (t1-t0)/1000000 ))" "$(echo "$out" | head -1)"
  [ "$rc" != "0" ] && echo "$out" | grep -iE 'error|panic' | head -2 | sed 's/^/       !! /'
  echo "$out" | sed -n '3,6p' | sed 's/^/       /'
  echo
}
其中两个函数需要说明,它们是实测过程中发现问题的直接产物。
kwsql_scalar()用于从查询结果中取单个标量值。kwbase两种输出格式的行布局不同:--format=table为第 1 行表头、第 2 行横线分隔、第 3 行起始数据;--format=csv为第 1 行表头、第 2 行起始数据。若按 table 的习惯执行sed -n '2p',取到的是----+----形式的分隔线,且不会报错。该函数统一使用 csv 格式并取第 2 行,规避此问题。kw_time()用于计时执行单条 SQL 并输出耗时,供第 10 章的代价分解使用。
4.4 总控脚本 run_all.sh
脚本 run_all.sh(完整内容)
#!/bin/bash
<span id="heading-64" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-65" class="markdown-toc-anchor"></span>

# run_all.sh —— 一键复现(可指定起止阶段,失败即停)
<span id="heading-66" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-67" class="markdown-toc-anchor"></span>

# 用法:
<span id="heading-68" class="markdown-toc-anchor"></span>

#   bash run_all.sh              跑全部 13 个阶段
<span id="heading-69" class="markdown-toc-anchor"></span>

#   bash run_all.sh 04           从阶段 04 跑到最后(前面已完成的可跳过)
<span id="heading-70" class="markdown-toc-anchor"></span>

#   bash run_all.sh 04 09        只跑阶段 04 到 09
<span id="heading-71" class="markdown-toc-anchor"></span>

#   bash run_all.sh --list       打印阶段清单
<span id="heading-72" class="markdown-toc-anchor"></span>

#
# 设计:
<span id="heading-73" class="markdown-toc-anchor"></span>

#   · 每个阶段都是独立脚本,失败立即停止并保留现场(不吞错)
<span id="heading-74" class="markdown-toc-anchor"></span>

#   · 续跑只需给出起始编号,例如上次卡在 09 就  bash run_all.sh 09
<span id="heading-75" class="markdown-toc-anchor"></span>

#   · 全过程日志同时落一份到 $KWM_RPT/run_all.log
<span id="heading-76" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
HERE="$(cd "$(dirname "$0")" && pwd)"
. "${HERE}/mm_env.sh"
<span id="heading-77" class="markdown-toc-anchor"></span>


# 阶段清单:脚本文件名 | 说明
STEPS=(
  "00_env_check.sh|环境自检:OS/CPU/内存/磁盘/Go/KWDB 连接"
  "01_get_source.sh|获取 kwdb-tsbs 源码并对齐基线 commit"
  "02_apply_patch.sh|应用 multi-mode 补丁(3 新增 + 5 修改)"
  "03_build.sh|离线编译,验证 10 个跨模模板已注册"
  "04_gen_data.sh|生成 iot 数据集(scale=300,1 天)"
  "05_import.sh|导入时序库"
  "06_assemble.sh|跨模装配关系台账"
  "07_probe.sh|12 项跨模可行性探针"
  "08_baseline.sh|复现官方 29 个模板基线"
  "09_bench.sh|受控对照:跨模臂 vs 拆分臂"
  "10_decompose.sh|代价分解"
  "11_equiv.sh|两臂答案等价性核对"
  "12_evidence.sh|一次性归集全部取证"
)

if [ "${1:-}" = "--list" ]; then
  echo "阶段清单(文件名前两位即阶段编号):"
  for s in "${STEPS[@]}"; do
    printf '  %s\n' "${s%%|*}"
    printf '      %s\n' "${s##*|}"
  done
  exit 0
fi
<span id="heading-78" class="markdown-toc-anchor"></span>


# 归一化起止编号(强制十进制,避免 08 被当成八进制)
FROM=$(printf '%02d' "$((10#${1:-0}))")
TO=$(printf '%02d' "$((10#${2:-99}))")

mkdir -p "$KWM_RPT"
LOG="$KWM_RPT/run_all.log"

{
echo "=============================================================="
echo " kwdb-tsbs 跨模(multi-mode)复现 —— $(date '+%F %T')"
echo " 阶段范围 : $FROM ~ $TO"
echo " 数据盘   : $KWM_ROOT"
echo " 目标库   : $KWM_HOST:$KWM_PORT   时序=$KWM_TSDB  关系=$KWM_RELDB"
echo "=============================================================="

STARTED=0
FAILED=""
for s in "${STEPS[@]}"; do
  f="${s%%|*}"; desc="${s##*|}"
  num="${f:0:2}"
  n=$((10#$num)); from=$((10#$FROM)); to=$((10#$TO))
  [ "$n" -lt "$from" ] && continue
  [ "$n" -gt "$to" ] && continue

  echo
  echo "##############################################################"
  echo "# 阶段 $num | $desc"
  echo "# 脚本 $HERE/$f"
  echo "##############################################################"

  if [ ! -f "$HERE/$f" ]; then
    echo "[FAIL] 找不到阶段脚本 $HERE/$f"
    FAILED="$num"; break
  fi

  STARTED=1
  bash "$HERE/$f"
  rc=$?
  if [ "$rc" != 0 ]; then
    echo
    echo "[FAIL] 阶段 $num 返回 $rc —— 已停止,请按上面的提示处理后续跑:"
    echo "        bash run_all.sh $num"
    FAILED="$num"
    break
  fi
done

echo
echo "=============================================================="
if [ -z "$FAILED" ]; then
  echo " 全部完成。取证汇总:$KWM_RPT/evidence_mm.txt"
else
  echo " 在阶段 $FAILED 中止。"
fi
echo " 本次日志:$LOG"
echo "=============================================================="
} 2>&1 | tee "$LOG"
用法如下:
cd /tsbs/reproduce
bash run_all.sh --list        # 打印阶段清单
bash run_all.sh               # 执行全部 13 个阶段
bash run_all.sh 04 09         # 仅执行阶段 04 至 09
bash run_all.sh 04            # 从阶段 04 执行至最后
bash 04_gen_data.sh           # 直接执行单个阶段
任一阶段返回非 0 时,run_all.sh 立即停止并保留现场。修复问题后执行 bash run_all.sh <失败编号> 即可续跑。
5 阶段 00:环境自检
正式操作前先执行一次环境检查,可避免执行至中途才发现磁盘或依赖不满足。
执行位置:KWDB 所在主机 执行用户:root 预计耗时:小于 10 秒
bash 00_env_check.sh
脚本 00_env_check.sh(完整内容)
#!/bin/bash
<span id="heading-80" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-81" class="markdown-toc-anchor"></span>

# 00_env_check.sh —— 复现环境自检(正式动手前先跑这个)
<span id="heading-82" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-83" class="markdown-toc-anchor"></span>

# 做什么:逐项核对操作系统、CPU/内存/磁盘、Go 工具链、KWDB 服务与连接,
<span id="heading-84" class="markdown-toc-anchor"></span>

#         任何一项不满足都会在最后汇总成 FAIL 清单,避免跑到一半才失败。
<span id="heading-85" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机
<span id="heading-86" class="markdown-toc-anchor"></span>

# 执行用户:root
<span id="heading-87" class="markdown-toc-anchor"></span>

# 预计耗时:< 10 秒
<span id="heading-88" class="markdown-toc-anchor"></span>

# 用法    :bash 00_env_check.sh
<span id="heading-89" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

FAILS=0
chk() {  # chk <项目> <期望> <实际> <是否通过 0/1>
  printf '  %-22s %-34s %-30s %s\n' "$1" "$2" "$3" "$4"
}

step "0. 复现环境自检"

echo
echo "-- A. 操作系统与硬件 --"
printf '  %-22s %-34s %-30s %s\n' "项目" "期望" "实际" "结果"

os=$(cat /etc/redhat-release 2>/dev/null || echo unknown)
case "$os" in *"CentOS Linux release 7"*) r=OK;; *) r=WARN;; esac
chk "操作系统" "CentOS 7.x" "$os" "$r"

kern=$(uname -r)
chk "内核" "3.10.0-1160 或相近" "$kern" "OK"

ncpu=$(nproc)
[ "$ncpu" -ge 4 ] && r=OK || r=FAIL
[ "$r" = FAIL ] && FAILS=$((FAILS+1))
chk "CPU 核数" ">= 4" "$ncpu" "$r"

memg=$(free -g | awk '/^Mem:/{print $2}')
[ "$memg" -ge 8 ] && r=OK || r=FAIL
[ "$r" = FAIL ] && FAILS=$((FAILS+1))
chk "内存" ">= 8 GB" "${memg} GB" "$r"

echo
echo "-- B. 数据盘 --"
for d in "$KWM_ROOT" "$KWM_SRC"; do
  if [ -d "$d" ]; then
    avail=$(df -BG "$d" | awk 'NR==2{print $4}')
    tmp=$(df -BG "$d" | awk 'NR==2{gsub("G","",$4); print $4}')
    [ "${tmp:-0}" -ge 20 ] && r=OK || r=FAIL
    [ "$r" = FAIL ] && FAILS=$((FAILS+1))
    chk "可用空间 $d" ">= 20 GB" "$avail" "$r"
  else
    chk "目录 $d" "存在" "不存在" "FAIL"; FAILS=$((FAILS+1))
  fi
done

echo
echo "-- C. Go 工具链(离线编译的关键三项)--"
if command -v go >/dev/null 2>&1; then
  gov=$(go version | awk '{print $3}')
  chk "go version" ">= go1.21" "$gov" "OK"
else
  chk "go version" "可执行" "未找到 go" "FAIL"; FAILS=$((FAILS+1))
fi
chk "GOTOOLCHAIN" "local(禁止联网拉工具链)" "${GOTOOLCHAIN:-<未设置>}" \
    "$([ "${GOTOOLCHAIN:-}" = local ] && echo OK || echo FAIL)"
[ "${GOTOOLCHAIN:-}" = local ] || FAILS=$((FAILS+1))
chk "GOFLAGS" "-mod=vendor(用仓库自带依赖)" "${GOFLAGS:-<未设置>}" \
    "$([ "${GOFLAGS:-}" = -mod=vendor ] && echo OK || echo FAIL)"
[ "${GOFLAGS:-}" = -mod=vendor ] || FAILS=$((FAILS+1))
chk "GOCACHE" "可写" "$GOCACHE" "OK"

echo
echo "-- D. kwdb-tsbs 源码树 --"
if [ -d "$KWM_SRC/.git" ]; then
  head=$(cd "$KWM_SRC" && git log -1 --format='%h %s' 2>/dev/null)
  chk "源码目录" "$KWM_SRC" "$head" "OK"
  chk "vendor 目录" "存在(决定能否离线编译)" \
      "$([ -d "$KWM_SRC/vendor" ] && echo 有 || echo 无)" \
      "$([ -d "$KWM_SRC/vendor" ] && echo OK || echo FAIL)"
  [ -d "$KWM_SRC/vendor" ] || FAILS=$((FAILS+1))
else
  chk "源码目录" "$KWM_SRC" "不存在(请先执行 01_get_source.sh)" "SKIP"
fi

echo
echo "-- E. KWDB 服务与连接 --"
if [ -x "$KWM_BIN" ]; then
  kv=$("$KWM_BIN" version 2>&1 | head -1)
  chk "kwbase 客户端" "可执行" "$kv" "OK"
else
  chk "kwbase 客户端" "$KWM_BIN" "不可执行" "FAIL"; FAILS=$((FAILS+1))
fi
sysd=$(systemctl is-active kaiwudb 2>/dev/null || echo inactive)
chk "kaiwudb 服务" "active" "$sysd" "$([ "$sysd" = active ] && echo OK || echo FAIL)"
[ "$sysd" = active ] || FAILS=$((FAILS+1))
[ -d "$KWM_CERTS" ] && chk "证书目录" "$KWM_CERTS" "存在" "OK" \
                    || { chk "证书目录" "$KWM_CERTS" "不存在" "FAIL"; FAILS=$((FAILS+1)); }
<span id="heading-90" class="markdown-toc-anchor"></span>


# 真实连一次库,这是最硬的判据
if ping_out=$(kwsql "SELECT 1 AS alive;" 2>&1); then
  chk "SQL 连接" "${KWM_HOST}:${KWM_PORT}" "alive=$(kwsql_scalar 'SELECT 1 AS alive;')" "OK"
else
  chk "SQL 连接" "${KWM_HOST}:${KWM_PORT}" "$(echo "$ping_out" | head -1)" "FAIL"
  FAILS=$((FAILS+1))
fi

echo
echo "-- F. 现有数据库与引擎类型 --"
kwsql "SELECT database_name, engine_type FROM [SHOW DATABASES] ORDER BY engine_type, database_name;" \
  | head -20

echo
echo "=============================================================="
if [ "$FAILS" -eq 0 ]; then
  ok "环境自检通过(0 个 FAIL),可以进入 01_get_source.sh"
else
  fail "环境自检有 $FAILS 项未通过,请先解决后再继续"
fi
echo "=============================================================="
exit "$FAILS"
实测输出
========== 0. 复现环境自检 ==========

-- A. 操作系统与硬件 --
  项目                 期望                             实际                         结果
  操作系统           CentOS 7.x                         CentOS Linux release 7.9.2009 (Core) OK
  内核                 3.10.0-1160 或相近              3.10.0-1160.el7.x86_64         OK
  CPU 核数             >= 4                               8                              OK
  内存                 >= 8 GB                            31 GB                          OK

-- B. 数据盘 --
  可用空间 /tsbs     >= 20 GB                           145G                           OK
  可用空间 /opt/src/kwdb-tsbs >= 20 GB                           40G                            OK

-- C. Go 工具链(离线编译的关键三项)--
  go version             >= go1.21                          go1.24.0                       OK
  GOTOOLCHAIN            local(禁止联网拉工具链) local                          OK
  GOFLAGS                -mod=vendor(用仓库自带依赖) -mod=vendor                    OK
  GOCACHE                可写                             /tsbs/gocache                  OK

-- D. kwdb-tsbs 源码树 --
  源码目录           /opt/src/kwdb-tsbs                 44ba21c ...                    OK
  vendor 目录          存在(决定能否离线编译) 有                            OK

-- E. KWDB 服务与连接 --
  kwbase 客户端       可执行                          KaiwuDB Version:  3.2.2        OK
  kaiwudb 服务         active                             active                         OK
  证书目录           /etc/kaiwudb/certs                 存在                         OK
  SQL 连接             <KWDB主机>:26257                 alive=1                        OK

-- F. 现有数据库与引擎类型 --
  database_name | engine_type
----------------+--------------
  defaultdb     | RELATIONAL
  ...

==============================================================
[ OK ] 环境自检通过(0 个 FAIL),可以进入 01_get_source.sh
==============================================================
注意:上述输出中的 SQL 连接 一行,主机地址已替换为 <KWDB主机>。脚本实际输出的是其探测到的地址,直接执行会显示真实主机地址,以便核对连通性。
成功判据:最后一行出现 环境自检通过(0 个 FAIL)。脚本的退出码等于 FAIL 的条数,run_all.sh 据此决定是否继续。
C 组三项决定能否离线编译,作用如下:
| 变量 | 取值 | 作用 |
|---|---|---|
GOTOOLCHAIN |
local |
禁止 Go 自动下载工具链。内网环境中若不设置该项会长时间无响应 |
GOFLAGS |
-mod=vendor |
仅使用仓库自带的 vendor/ 目录,全程不访问 proxy |
GOCACHE / GOMODCACHE |
指向 /tsbs |
避免构建缓存写满根分区 |
6 阶段 01–03:源码、补丁与编译
完成三个阶段后,即获得一个具备跨模能力的 kwdb-tsbs。
6.1 阶段 01:获取源码并对齐基线
执行位置:KWDB 所在主机 执行用户:root 预计耗时:10 至 60 秒(取决于网络)
bash 01_get_source.sh
脚本 01_get_source.sh(完整内容)
#!/bin/bash
<span id="heading-93" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-94" class="markdown-toc-anchor"></span>

# 01_get_source.sh —— 获取 kwdb-tsbs 源码并切到本文基线
<span id="heading-95" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-96" class="markdown-toc-anchor"></span>

# 做什么:把官方 kwdb-tsbs 取到 $KWM_SRC,并尽量切到基线 commit。
<span id="heading-97" class="markdown-toc-anchor"></span>

# 为什么用 --depth 1:仓库不大但历史较长,浅克隆更快;
<span id="heading-98" class="markdown-toc-anchor"></span>

#         代价是"不能从这个副本再 clone"(见附录"常见报错速查")。
<span id="heading-99" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root
<span id="heading-100" class="markdown-toc-anchor"></span>

# 预计耗时:10~60 秒(视网络)
<span id="heading-101" class="markdown-toc-anchor"></span>

# 用法    :bash 01_get_source.sh
<span id="heading-102" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

step "1. 获取 kwdb-tsbs 源码"

if [ -d "$KWM_SRC/.git" ]; then
  ok "源码目录已存在,直接复用:$KWM_SRC"
else
  mkdir -p "$(dirname "$KWM_SRC")" || die "无法创建 $KWM_SRC 的父目录"
  echo "  正在克隆 $KWM_TSBS_REPO"
  git clone --depth 1 "$KWM_TSBS_REPO" "$KWM_SRC" 2>&1 | tail -3 \
    || die "克隆失败:请检查网络,或先把源码拷到 $KWM_SRC"
fi

cd "$KWM_SRC" || die "无法进入 $KWM_SRC"

echo
echo "-- 当前版本 --"
git log -1 --format='  commit : %H%n  短hash : %h%n  日期   : %ad%n  说明   : %s' --date=iso

echo
echo "-- 对齐基线 commit $KWM_TSBS_BASE --"
if git rev-parse --verify --quiet "${KWM_TSBS_BASE}^{commit}" >/dev/null 2>&1; then
  git checkout -q "$KWM_TSBS_BASE" && ok "已切到基线 $KWM_TSBS_BASE"
elif [ "$(git rev-parse --short HEAD 2>/dev/null)" = "$KWM_TSBS_BASE" ]; then
  ok "当前 HEAD 就是基线 $KWM_TSBS_BASE"
else
  warn "未找到基线 commit $KWM_TSBS_BASE(浅克隆的常见现象)"
  warn "将使用当前 HEAD 继续;若补丁应用失败,请改用全量克隆再 checkout 基线"
fi

echo
echo "-- 离线编译的两个前提 --"
[ -d vendor ] && ok "vendor/ 存在,可全程离线编译" \
              || warn "vendor/ 缺失,编译时会尝试联网拉依赖"
<span id="heading-103" class="markdown-toc-anchor"></span>

# 注意:这里不能直接跑无参数的 gofmt —— 它会从 stdin 读输入而挂住,
<span id="heading-104" class="markdown-toc-anchor"></span>

#       远程非交互执行时表现为"脚本卡死不动"。用 command -v 判断即可。
command -v go >/dev/null 2>&1 && ok "go 工具链可用:$(go version)" \
                             || die "go 不可用,请检查 /etc/profile.d/go.sh 或 PATH"

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 02_apply_patch.sh"
echo "------------------------------------------------------------"
实测输出
========== 1. 获取 kwdb-tsbs 源码 ==========
[ OK ] 源码目录已存在,直接复用:/opt/src/kwdb-tsbs

-- 当前版本 --
  commit : 44ba21c03c0a19574e0bd1b13f426f2f7e10bdf2
  短hash : 44ba21c
  日期   : 2026-08-27 02:06:18 +0000
  说明   : 增加参数--mean-mode=standard|trimmed

-- 对齐基线 commit 44ba21c --
[ OK ] 已切到基线 44ba21c

-- 离线编译的两个前提 --
[ OK ] vendor/ 存在,可全程离线编译
[ OK ] go 工具链可用:go version go1.24.0 linux/amd64
成功判据:输出 commit 信息、vendor/ 存在、go 命令可用。
注意:脚本使用 git clone --depth 1(浅克隆)以缩短获取时间。浅克隆得到的副本不能再作为 clone 源。本文在验证「从零复现」时曾遇到该限制,报错为:fatal: attempt to fetch/clone from a shallow repository 若计划用同一副本向其他机器克隆,请改用全量克隆,或使用 git archive 导出快照。
6.2 阶段 02:应用补丁
该阶段是流程中最容易出错的一步。
执行位置:KWDB 所在主机 执行用户:root 预计耗时:小于 5 秒
bash 02_apply_patch.sh
脚本 02_apply_patch.sh(完整内容)
#!/bin/bash
<span id="heading-106" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-107" class="markdown-toc-anchor"></span>

# 02_apply_patch.sh —— 把「跨模(multi-mode)」增量打进 kwdb-tsbs
<span id="heading-108" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-109" class="markdown-toc-anchor"></span>

# 做什么:应用 patch/mm_multimode.patch,新增 3 个文件 / 修改 5 个文件。
<span id="heading-110" class="markdown-toc-anchor"></span>

#
# ★ 为什么单独给一份补丁文件,而不是在文章里贴代码片段:
<span id="heading-111" class="markdown-toc-anchor"></span>

#   本文最初只贴了「关键几行」,读者要自己找位置、自己拼文件,
<span id="heading-112" class="markdown-toc-anchor"></span>

#   很容易漏掉新增文件——而漏掉新增文件的后果是**编译直接失败**,
<span id="heading-113" class="markdown-toc-anchor"></span>

#   且报错信息(undefined: multimode.NewCore)完全指不到真正的原因。
<span id="heading-114" class="markdown-toc-anchor"></span>

#   所以这里改成"一份可 git apply 的完整补丁",一条命令落地,可校验。
<span id="heading-115" class="markdown-toc-anchor"></span>

#
# 幂等:重复执行安全。已应用则跳过;工作区被改乱则先还原官方文件再应用。
<span id="heading-116" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:< 5 秒
<span id="heading-117" class="markdown-toc-anchor"></span>

# 用法    :bash 02_apply_patch.sh
<span id="heading-118" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

HERE="$(cd "$(dirname "$0")" && pwd)"
PATCH="${HERE}/patch/mm_multimode.patch"
<span id="heading-119" class="markdown-toc-anchor"></span>


# 补丁新增的三个文件——它们同时是"是否已应用"的判据
NEWFILES="cmd/tsbs_generate_queries/databases/kwdb/multimode.go
cmd/tsbs_generate_queries/uses/multimode/common.go
cmd/tsbs_generate_queries/uses/multimode/queries.go"

step "2. 应用 multi-mode 补丁"

[ -f "$PATCH" ] || die "找不到补丁文件:$PATCH"
echo "  补丁文件 : $PATCH"
echo "  补丁行数 : $(wc -l < "$PATCH")"
echo "  涉及文件 : $(grep -c '^diff --git' "$PATCH") 个(新增 $(grep -c '^new file mode' "$PATCH") 个)"

cd "$KWM_SRC" || die "无法进入源码目录 $KWM_SRC"

echo
echo "-- 幂等检查:3 个新增文件是否已在位 --"
already=1
for f in $NEWFILES; do
  if [ -f "$f" ]; then echo "  [有] $f"; else echo "  [无] $f"; already=0; fi
done

if [ "$already" = 1 ]; then
  ok "补丁已应用过,跳过(如需重来请先 git checkout -- . 并删除上述 3 个文件)"
else
  echo
  echo "-- 试应用 --"
  if git apply --check "$PATCH" 2>/dev/null; then
    git apply "$PATCH" && ok "补丁应用成功"
  else
    warn "工作区不是官方基线状态(可能有历史残留),先还原官方文件"
    git checkout -- cmd internal pkg 2>/dev/null || true
    rm -f cmd/tsbs_generate_queries/databases/kwdb/multimode.go
    rm -rf cmd/tsbs_generate_queries/uses/multimode
    if git apply --check "$PATCH" 2>/dev/null; then
      git apply "$PATCH" && ok "还原后应用成功"
    else
      git apply --check "$PATCH"
      die "补丁仍无法应用。最常见原因:源码版本与基线 $KWM_TSBS_BASE 不一致,
      请执行  git -C $KWM_SRC checkout $KWM_TSBS_BASE  后重试。"
    fi
  fi
fi

echo
echo "-- 落地校验 --"
echo "  新增文件行数:"
wc -l cmd/tsbs_generate_queries/databases/kwdb/multimode.go \
      cmd/tsbs_generate_queries/uses/multimode/*.go | sed 's/^/    /'
echo "  变更总览:"
git diff --stat | tail -10 | sed 's/^/    /'
echo "  未跟踪文件:"
git status --porcelain | grep '^??' | sed 's/^/    /'

n=$(git status --porcelain | wc -l)
[ "$n" -ge 8 ] && ok "工作区共有 $n 处变更(预期 8)" || warn "工作区只有 $n 处变更,预期 8 处"

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 03_build.sh"
echo "------------------------------------------------------------"
实测输出
========== 2. 应用 multi-mode 补丁 ==========
  补丁文件 : /tsbs/reproduce/patch/mm_multimode.patch
  补丁行数 : 665
  涉及文件 : 8 个(新增 3 个)

-- 幂等检查:3 个新增文件是否已在位 --
  [有] cmd/tsbs_generate_queries/databases/kwdb/multimode.go
  [有] cmd/tsbs_generate_queries/uses/multimode/common.go
  [有] cmd/tsbs_generate_queries/uses/multimode/queries.go
[ OK ] 补丁已应用过,跳过(如需重来请先 git checkout -- . 并删除上述 3 个文件)

-- 落地校验 --
  新增文件行数:
      213 cmd/tsbs_generate_queries/databases/kwdb/multimode.go
      120 cmd/tsbs_generate_queries/uses/multimode/common.go
      135 cmd/tsbs_generate_queries/uses/multimode/queries.go
      468 total
  变更总览:
     cmd/tsbs_generate_queries/databases/kwdb/common.go |  24 +++
     .../databases/kwdb/multimode.go                    | 213 +++++++++++++++++++++
     cmd/tsbs_generate_queries/main.go                  |  16 ++
     .../uses/multimode/common.go                       | 120 ++++++++++++
     .../uses/multimode/queries.go                      | 135 +++++++++++++
     internal/inputs/generator_queries.go               |  21 +-
     pkg/data/usecases/common/common.go                 |   4 +
     pkg/query/factories/init_factories.go              |   8 +
     8 files changed, 538 insertions(+), 3 deletions(-)
[ OK ] 工作区共有 8 处变更(预期 8)
成功判据:输出 工作区共有 8 处变更(预期 8)。
6.2.1 补丁必须包含新增文件
本文档早期版本附带的补丁只有 179 行、涉及 5 个文件,不包含 3 个新增文件。原因是 git diff 默认不包含未跟踪(untracked)的新文件,而本次改动中恰好有 3 个文件为全新创建。使用该补丁执行 git apply 时,5 个修改文件的改动会正常应用,随后编译报错:
<span id="heading-121" class="markdown-toc-anchor"></span>

# make
cmd/tsbs_generate_queries/databases/kwdb/common.go:47:15: undefined: multimode.NewCore
报错指向 common.go,但真实原因是定义 NewCore 的文件未包含在补丁中。此类误导性报错排查成本较高。
处理方法:导出补丁前先执行 git add -N,使未跟踪文件进入 diff 范围,产出的补丁即带有 new file mode 头。当前补丁为 665 行、8 个文件,其中 3 个带 new file mode,可在干净源码上通过 git apply --check。
该结论经过一次完整验证:使用 git archive HEAD 导出一份干净快照(3258 个文件)作为读者克隆所得的原始源码,然后执行:
git apply --check  →  通过
git apply          →  3 个新文件 468 行落地
gofmt -l           →  干净
make -j8           →  rc=0,耗时 35 秒
tsbs_generate_queries --help | grep -c 'use case: multi-mode'  →  10
6.3 阶段 03:离线编译
执行位置:KWDB 所在主机 执行用户:root 预计耗时:首次约 35 秒(8 核),缓存命中时 1 秒以内
bash 03_build.sh
脚本 03_build.sh(完整内容)
#!/bin/bash
<span id="heading-123" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-124" class="markdown-toc-anchor"></span>

# 03_build.sh —— 编译 kwdb-tsbs(离线 · 可重复)
<span id="heading-125" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-126" class="markdown-toc-anchor"></span>

# 做什么:用仓库自带 vendor 目录编译全部 25 个 command,产出 bin/ 下的可执行文件。
<span id="heading-127" class="markdown-toc-anchor"></span>

# 为什么要这三个环境变量:
<span id="heading-128" class="markdown-toc-anchor"></span>

#   GOTOOLCHAIN=local  禁止 go 自动下载工具链(否则内网机器直接卡死)
<span id="heading-129" class="markdown-toc-anchor"></span>

#   GOFLAGS=-mod=vendor 只认 vendor/,全程不访问 proxy
<span id="heading-130" class="markdown-toc-anchor"></span>

#   GOCACHE/GOMODCACHE 指向数据盘,避免把根分区写满
<span id="heading-131" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root
<span id="heading-132" class="markdown-toc-anchor"></span>

# 预计耗时:首次约 35 秒(8 核),磁盘有缓存时更快
<span id="heading-133" class="markdown-toc-anchor"></span>

# 用法    :bash 03_build.sh
<span id="heading-134" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

step "3. 编译 kwdb-tsbs"

cd "$KWM_SRC" || die "无法进入源码目录(请先执行 01_get_source.sh)"

echo "-- 工具链 --"
echo "  $(go version)"
echo "  GOTOOLCHAIN=$GOTOOLCHAIN   GOFLAGS=$GOFLAGS"
echo "  GOCACHE=$GOCACHE"
echo

echo "-- 格式检查(本次改动的文件;输出为空表示格式正确)--"
fmt=$(gofmt -l \
  cmd/tsbs_generate_queries/databases/kwdb/multimode.go \
  cmd/tsbs_generate_queries/uses/multimode/ \
  cmd/tsbs_generate_queries/databases/kwdb/common.go \
  cmd/tsbs_generate_queries/main.go 2>&1)
if [ -z "$fmt" ]; then ok "gofmt 干净"; else warn "以下文件未格式化:"; echo "$fmt" | sed 's/^/    /'; fi

echo
echo "-- make -j$(nproc) --"
t0=$(date +%s)
make -j"$(nproc)" 2>&1 | tail -8
rc=${PIPESTATUS[0]}
t1=$(date +%s)
echo
[ "$rc" = 0 ] && ok "编译成功,耗时 $((t1-t0)) 秒" || die "编译失败(rc=$rc),请把上面完整输出贴出来排查"

echo
echo "-- 产物检查 --"
for b in tsbs_generate_data tsbs_generate_queries tsbs_run_queries_kwdb tsbs_load_kwdb; do
  if [ -x "bin/$b" ]; then printf '  [ OK ] %-24s %s\n' "$b" "$(ls -lh bin/$b | awk '{print $5}')"; \
  else printf '  [FAIL] %-24s 缺失\n' "$b"; fi
done

echo
echo "-- 关键校验:multi-mode 是否进入用例矩阵 --"
n=$(./bin/tsbs_generate_queries --help 2>&1 | grep -c 'use case: multi-mode')
echo "  multi-mode query type 数 = $n (预期 10)"
./bin/tsbs_generate_queries --help 2>&1 | grep 'use case: multi-mode' | sed 's/^/    /'
[ "$n" = 10 ] && ok "补丁确实生效:10 个跨模模板已注册" \
              || die "只找到 $n 个,补丁未正确生效(请回看 02_apply_patch.sh)"

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 04_gen_data.sh"
echo "------------------------------------------------------------"
实测输出(缓存命中,编译耗时 1 秒)
========== 3. 编译 kwdb-tsbs ==========
-- 工具链 --
  go version go1.24.0 linux/amd64
  GOTOOLCHAIN=local   GOFLAGS=-mod=vendor
  GOCACHE=/tsbs/gocache

-- 格式检查(本次改动的文件;输出为空表示格式正确)--
[ OK ] gofmt 干净

-- make -j8 --
GO111MODULE=on go build -mod=vendor -o bin/tsbs_run_queries_kwdb ./cmd/tsbs_run_queries_kwdb
...
[ OK ] 编译成功,耗时 1 秒

-- 产物检查 --
  [ OK ] tsbs_generate_data       16M
  [ OK ] tsbs_generate_queries    8.4M
  [ OK ] tsbs_run_queries_kwdb    16M
  [ OK ] tsbs_load_kwdb           15M

-- 关键校验:multi-mode 是否进入用例矩阵 --
  multi-mode query type 数 = 10 (预期 10)
      use case: multi-mode, query type: mm-fleet-daily-2step
      use case: multi-mode, query type: mm-driver-window
      use case: multi-mode, query type: mm-driver-window-2step
      use case: multi-mode, query type: mm-depot-topn
      use case: multi-mode, query type: mm-overload-2step
      use case: multi-mode, query type: mm-fleet-daily
      use case: multi-mode, query type: mm-depot-topn-2step
      use case: multi-mode, query type: mm-overload
      use case: multi-mode, query type: mm-install-window
      use case: multi-mode, query type: mm-install-window-2step
[ OK ] 补丁确实生效:10 个跨模模板已注册
成功判据:输出 multi-mode query type 数 = 10。该判据是补丁生效的可靠证据,比编译无报错更为直接。
6.4 本次二次开发的改动范围
改动清单如下,可与 6.2 节的输出逐行核对。
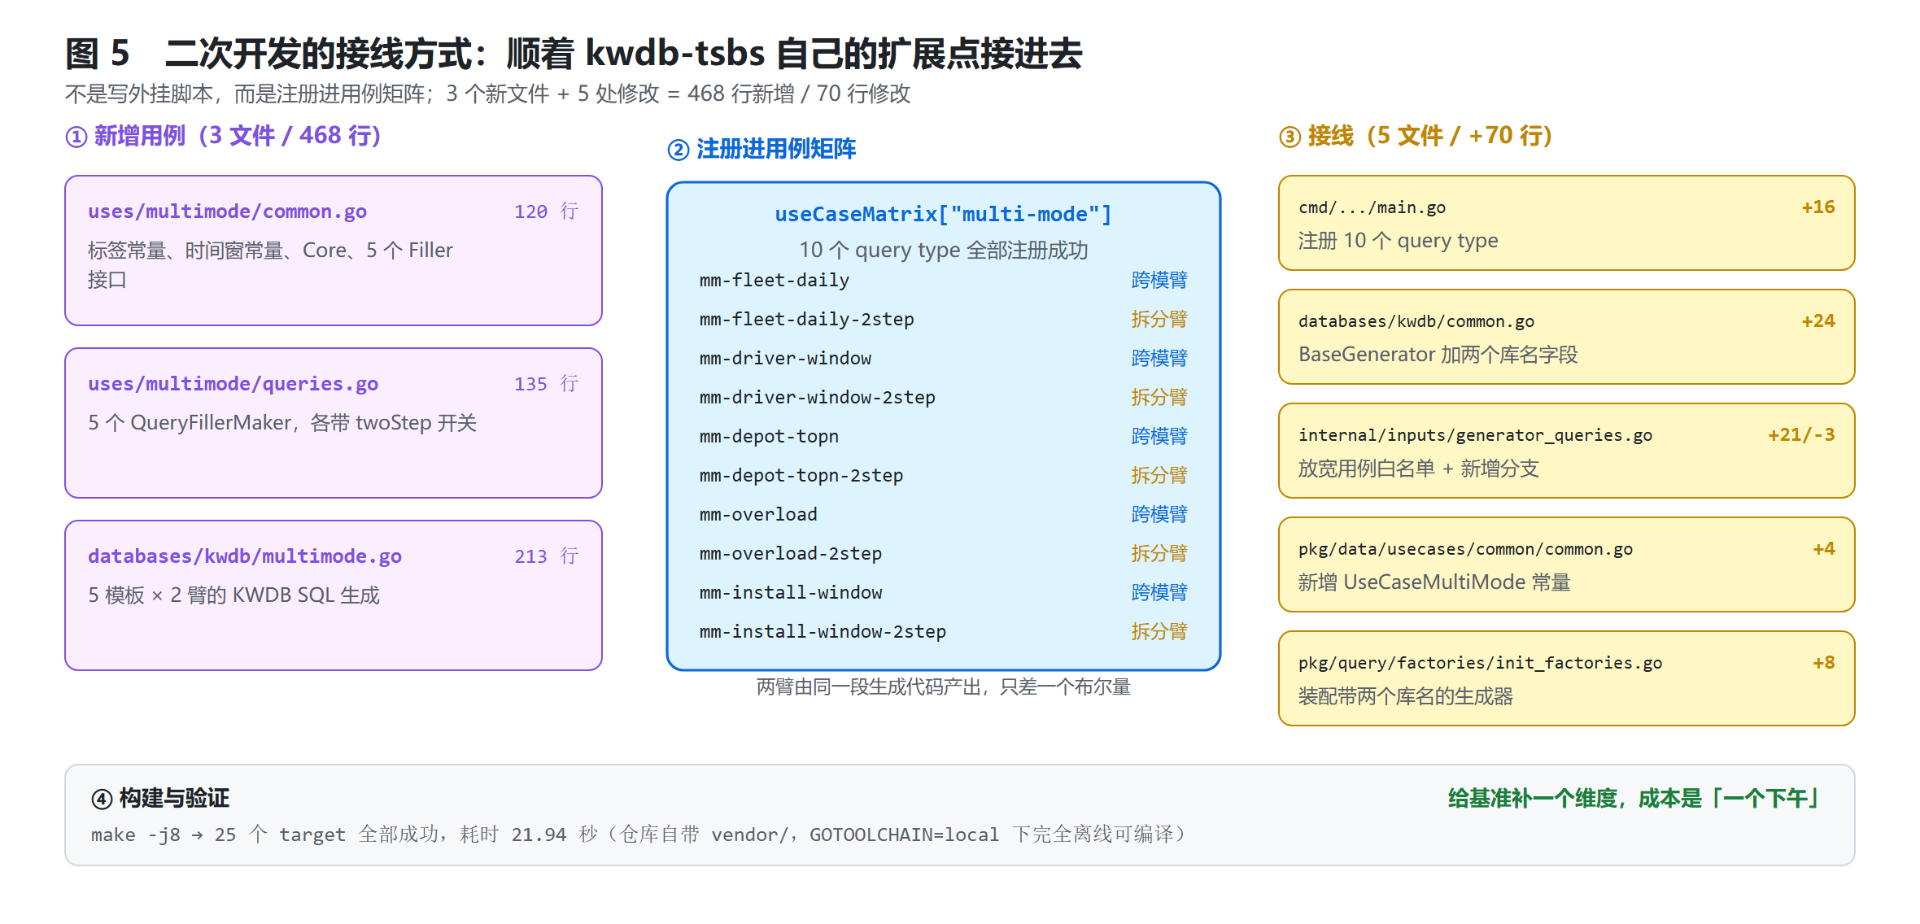
| 类别 | 文件 | 行数 | 作用 |
|---|---|---|---|
| 新增 | uses/multimode/common.go |
120 | 跨模用例公共模型:5 个模板的接口定义、时间窗生成、常量 |
| 新增 | uses/multimode/queries.go |
135 | 5 个 QueryFillerMaker,每个带两臂开关 |
| 新增 | databases/kwdb/multimode.go |
213 | KWDB 方言渲染:将模板渲染为跨模 SQL,并生成两臂标签 |
| 修改 | databases/kwdb/common.go |
+24 | BaseGenerator 增加时序库名与关系库名字段 |
| 修改 | tsbs_generate_queries/main.go |
+16 | 向用例矩阵注册 10 个 query type |
| 修改 | internal/inputs/generator_queries.go |
+21/-3 | 新增 MultiModeGeneratorMaker 接口并放宽校验白名单 |
| 修改 | pkg/data/usecases/common/common.go |
+4 | 增加 UseCaseMultiMode 常量 |
| 修改 | pkg/query/factories/init_factories.go |
+8 | 装配带两个库名的生成器 |
| 合计 | — | 538 增 / 3 删 | 3 新增 + 5 修改 |
该规模说明:为 TSBS 补充一个维度可以顺着其自身的扩展点实现,无须编写外挂脚本。这同时印证 1.2 节的判断,即 TSBS 的框架具备可扩展性,缺少的是维度而非扩展能力。
6.4.1 五个模板与两臂
新增的 5 个跨模模板,每个同时生成两条查询。
| 模板 | 业务问题 | 跨模臂 | 拆分臂 |
|---|---|---|---|
mm-fleet-daily |
各区域的油耗均值与峰值 | 一条跨模 SQL | 时序聚合加关系聚合,应用层拼接 |
mm-driver-window |
各司机在给定小时内的行驶里程 | 同上 | 同上 |
mm-depot-topn |
各车场油耗 TOP-N 车辆 | 同上 | 同上 |
mm-overload |
峰值载重超过额定载重的车辆 | 同上 | 同上 |
mm-install-window |
车辆投运之后首小时的行驶里程 | 同上 | 同上 |
跨模臂(mm-xxx)用一条 SQL 同时访问关系库与时序库;拆分臂(mm-xxx-2step)分别查询时序库与关系库,在应用层拼接结果。
两臂在同一 runner、同一连接、相同并发下测量。第 10.2 节做配对对比,第 10.6 节先确认两臂答案一致。
7 阶段 04–06:数据集、导入与跨模装配
7.1 阶段 04:生成数据集
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测 20 秒
bash 04_gen_data.sh
脚本 04_gen_data.sh(完整内容)
#!/bin/bash
<span id="heading-139" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-140" class="markdown-toc-anchor"></span>

# 04_gen_data.sh —— 生成 TSBS iot 数据集(原文缺失的一环)
<span id="heading-141" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-142" class="markdown-toc-anchor"></span>

# ★ 为什么这个脚本必须存在:
<span id="heading-143" class="markdown-toc-anchor"></span>

#   原稿直接从"导入数据"开始讲,默认数据集已经躺在磁盘上了。复测者照做时
<span id="heading-144" class="markdown-toc-anchor"></span>

#   第一步就会报  cannot open file .../iot_scale300_1d.dat  —— 而报错信息
<span id="heading-145" class="markdown-toc-anchor"></span>

#   完全看不出"需要先生成"。数据是 tsbs_generate_data 产出的,这一步不能省。
<span id="heading-146" class="markdown-toc-anchor"></span>

#
# 生成什么:iot 用例、scale=300(≈300 辆车)、1 天、采样间隔 10s,
<span id="heading-147" class="markdown-toc-anchor"></span>

#           约 350 MB 纯文本,导入后约 467 万行读数 + 466 万行诊断。
<span id="heading-148" class="markdown-toc-anchor"></span>

# 幂等:文件已存在且非空则跳过(重生成请先 rm)。
<span id="heading-149" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root
<span id="heading-150" class="markdown-toc-anchor"></span>

# 预计耗时:实测约 20 秒(8 vCPU,写 350 MB 文本);只做一次,之后复用
<span id="heading-151" class="markdown-toc-anchor"></span>

# 用法    :bash 04_gen_data.sh
<span id="heading-152" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

step "4. 生成 TSBS iot 数据集"

DAT="${KWM_LOAD}/iot_scale${KWM_SCALE}_1d.dat"
GEN="${KWM_SRC}/bin/tsbs_generate_data"

[ -x "$GEN" ] || die "找不到 $GEN,请先执行 03_build.sh"
mkdir -p "$KWM_LOAD" || die "无法创建数据目录 $KWM_LOAD"

echo "  输出文件 : $DAT"
echo "  规模     : scale=$KWM_SCALE  ${KWM_TS_START} ~ ${KWM_TS_END}  采样 10s"
echo

if [ -s "$DAT" ]; then
  ok "数据集已存在,跳过生成(重生成请先 rm -f $DAT)"
else
  echo "-- 开始生成(较慢,请耐心等待)--"
  t0=$(date +%s)
  "$GEN" \
    --format=kwdb \
    --use-case=iot \
    --seed=123 \
    --scale="$KWM_SCALE" \
    --log-interval=10s \
    --timestamp-start="$KWM_TS_START" \
    --timestamp-end="$KWM_TS_END" \
    --orderquantity=12 \
    --file="$DAT"
  rc=$?
  t1=$(date +%s)
  [ "$rc" = 0 ] || die "生成失败(rc=$rc)"
  ok "生成完成,耗时 $((t1-t0)) 秒"
fi

echo
echo "-- 产物 --"
ls -lh "$DAT" | sed 's/^/  /'
sz=$(stat -c %s "$DAT")
mb=$((sz/1024/1024))
echo "  大小 : ${mb} MB"
[ "$mb" -ge 100 ] && ok "文件大小符合 scale=$KWM_SCALE 的预期量级" \
                  || warn "文件明显偏小,请确认 --scale 是否被改动"

echo
echo "-- 内容抽样(伪 CSV 格式:第 1 列是行类型)--"
head -2 "$DAT" | cut -c1-160 | sed 's/^/  /'
echo "  ..."
tail -1 "$DAT" | cut -c1-160 | sed 's/^/  /'

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 05_import.sh"
echo "------------------------------------------------------------"
实测输出
========== 4. 生成 TSBS iot 数据集 ==========
  输出文件 : /tsbs/load_data/iot_scale300_1d.dat
  规模     : scale=300  2026-01-01T00:00:00Z ~ 2026-01-02T00:00:01Z  采样 10s

-- 开始生成(较慢,请耐心等待)--
[ OK ] 生成完成,耗时 20 秒

-- 产物 --
  -rw-r--r-- 1 root root 334M Oct  1 20:28 /tsbs/load_data/iot_scale300_1d.dat
  大小 : 333 MB
[ OK ] 文件大小符合 scale=300 的预期量级

-- 内容抽样(伪 CSV 格式:第 1 列是行类型)--
  3,readings,readings_truck_0,('truck_0','East','Rodney','G-2000','v1.5',5000,300,19)
  1,readings_truck_0,8,(1767225600000,71.13746,12.66709,80,0,177,0,25,'truck_0')
  ...
  1,diagnostics_truck_298,4,(1767311990000,0.6,3208,5,'truck_298')
成功判据:生成约 333 MB 的 .dat 文件,大小与 scale=300 相符。
注意:数据集需要生成,不随源码提供。若跳过本阶段直接导入,报错为:panic: cannot open file for read /tsbs/load_data/iot_scale300_1d.dat 该报错仅指出文件无法打开,不提示需要先生成,因此本版本将生成单独作为一个阶段。
数据格式说明:TSBS 使用伪 CSV,第 1 列为行类型。3 表示建表(含表名、子表名、标签值),1 表示插入(含子表名、字段数、字段值)。子表名由设备标签组合而成,这是跨模装配能够从 tag 反推台账的原因。
7.2 阶段 05:导入时序库
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测 2 秒(12 并发)
bash 05_import.sh
脚本 05_import.sh(完整内容)
#!/bin/bash
<span id="heading-154" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-155" class="markdown-toc-anchor"></span>

# 05_import.sh —— 把数据集导入 KWDB 时序库
<span id="heading-156" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-157" class="markdown-toc-anchor"></span>

# 做什么:用 tsbs_load_kwdb 把 04 生成的数据集导入 $KWM_TSDB(TIME SERIES 引擎)。
<span id="heading-158" class="markdown-toc-anchor"></span>

#
# ★ 两个参数别混(官方工具自身的历史包袱,踩过一次):
<span id="heading-159" class="markdown-toc-anchor"></span>

#     --db-name  目标数据库名(正式使用)
<span id="heading-160" class="markdown-toc-anchor"></span>

#     --dbname   建库 DDL 里用的名字
<span id="heading-161" class="markdown-toc-anchor"></span>

#   两个都要给,且都给成同一个值。
<span id="heading-162" class="markdown-toc-anchor"></span>

#
# 幂等:已有数据的库会先被清空重建(avoid 重复导入导致行数翻倍而基准虚高)。
<span id="heading-163" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root
<span id="heading-164" class="markdown-toc-anchor"></span>

# 预计耗时:实测约 2 秒(客户端侧统计;后台落盘可能仍在继续)
<span id="heading-165" class="markdown-toc-anchor"></span>

# 用法    :bash 05_import.sh
<span id="heading-166" class="markdown-toc-anchor"></span>

#
# ★ 关于"200 万行/秒"这个数字:它是**客户端提交速率**,混合了批量攒批与
<span id="heading-167" class="markdown-toc-anchor"></span>

#   页面缓存的效果,**不是持久化速率**,不能当性能结论用。
<span id="heading-168" class="markdown-toc-anchor"></span>

#   验证方法很简单——把 scale 翻三倍看是否线性(本文实测 scale=100 → 300,
<span id="heading-169" class="markdown-toc-anchor"></span>

#   行数 ×3、耗时 ×2.88,速率稳定在约 200 万行/秒,说明这个口径自身是稳定的)。
<span id="heading-170" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

step "5. 导入数据到时序库 $KWM_TSDB"

DAT="${KWM_LOAD}/iot_scale${KWM_SCALE}_1d.dat"
LOAD="${KWM_SRC}/bin/tsbs_load_kwdb"

[ -s "$DAT" ] || die "找不到数据集 $DAT,请先执行 04_gen_data.sh"
[ -x "$LOAD" ] || die "找不到 $LOAD,请先执行 03_build.sh"
mkdir -p "$KWM_RPT" || die "无法创建报告目录"

echo "-- 导入前状态 --"
pre=$(kwsql_scalar "SELECT count(*) FROM ${KWM_TSDB}.public.readings;")
<span id="heading-171" class="markdown-toc-anchor"></span>

# 只有拿到纯数字才认为是"库存在且有数据",否则(库不存在)一律按空处理
case "$pre" in ''|*[!0-9]*) pre="" ;; esac
if [ -n "$pre" ] && [ "$pre" != "0" ]; then
  warn "库 $KWM_TSDB 已有 $pre 行读数,将先清空重建,保证行数不翻倍"
  kwsql "DROP DATABASE IF EXISTS ${KWM_TSDB} CASCADE;" >/dev/null 2>&1
  ok "已清空旧库(关系库 ${KWM_RELDB} 也一并清空,避免台账与事实不一致)"
  kwsql "DROP DATABASE IF EXISTS ${KWM_RELDB} CASCADE;" >/dev/null 2>&1
else
  ok "库 $KWM_TSDB 不存在或为空,直接导入"
fi

echo
echo "-- 开始导入(workers=12, batch=10000)--"
t0=$(date +%s)
"$LOAD" \
  --file="$DAT" \
  --user="$KWM_USER" --host="$KWM_HOST" --port="$KWM_PORT" --certdir="$KWM_CERTS" \
  --insert-type=insert \
  --db-name="$KWM_TSDB" --dbname="$KWM_TSDB" \
  --case=iot \
  --batch-size=10000 --partition=false --workers=12 \
  --results-file="$KWM_RPT/load_iot_scale${KWM_SCALE}.json" 2>&1 | tail -12
rc=${PIPESTATUS[0]}
t1=$(date +%s)
[ "$rc" = 0 ] || die "导入失败(rc=$rc)"
ok "导入完成,耗时 $((t1-t0)) 秒"

echo
echo "-- 导入后核对(这一组数字就是后文所有实验的分母)--"
kwsql "SELECT (SELECT count(*) FROM ${KWM_TSDB}.public.readings)    AS readings,
              (SELECT count(*) FROM ${KWM_TSDB}.public.diagnostics) AS diagnostics;" | sed 's/^/  /'

echo
echo "-- 表与引擎 --"
kwsql "SELECT database_name, engine_type FROM [SHOW DATABASES]
       WHERE database_name = '${KWM_TSDB}';" | sed 's/^/  /'

r=$(kwsql_scalar "SELECT count(*) FROM ${KWM_TSDB}.public.readings;")
case "$r" in ''|*[!0-9]*) r=0 ;; esac
echo
[ "$r" -gt 1000000 ] && ok "读数 $r 行,量级正确" || warn "读数仅 $r 行,请回头检查 04 的生成结果"

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 06_assemble.sh"
echo "------------------------------------------------------------"
实测输出
========== 5. 导入数据到时序库 mm_bm ==========
-- 导入前状态 --
[WARN] 库 mm_bm 已有 2333844 行读数,将先清空重建,保证行数不翻倍
[ OK ] 已清空旧库(关系库 mm_bm_rel 也一并清空,避免台账与事实不一致)

-- 开始导入(workers=12, batch=10000)--
create iot tables
time,per. metric/s,metric total,overall metric/s,per. row/s,row total,overall row/s

Summary:
loaded 28005876 metrics in 1.738sec with 12 workers (mean rate 16113913.11 metrics/sec)
loaded 4667897 rows in 1.738sec with 12 workers (mean rate 2685796.60 rows/sec)
Saving results json file to /tsbs/reports/load_iot_scale300.json
[ OK ] 导入完成,耗时 2 秒

-- 导入后核对(这一组数字就是后文所有实验的分母)--
    readings | diagnostics
  -----------+--------------
     2333572 |     2334325
  (1 row)

-- 表与引擎 --
    database_name | engine_type
  ----------------+--------------
    mm_bm         | TIME SERIES
  (1 row)

[ OK ] 读数 2333572 行,量级正确
成功判据:readings 约 233 万行,且 mm_bm 的 engine_type 为 TIME SERIES。
注意:TSBS 的 loader 默认为追加语义。不先清空而重复导入会导致行数翻倍。其后果不仅是数据量增加,还会使延迟虚高,因为索引与扫描量随之增大,而基准仍以同一条 SQL 执行,表现为「机器变慢」。此类偏差不易察觉。因此脚本每次先清空再导入,以保证幂等。注意:上述行数与早期版本不同,原因是本版本在重新生成数据集后完整重跑。此类计数值会随数据生成批次小幅波动,应看量级而非精确值。
7.3 阶段 06:跨模装配关系台账
本阶段用一条跨模 SQL 将被内联进 tag 的业务维度取出,装配为规范的关系台账。
执行位置:KWDB 所在主机 执行用户:root 预计耗时:小于 10 秒
bash 06_assemble.sh
脚本 06_assemble.sh(完整内容)
#!/bin/bash
<span id="heading-173" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-174" class="markdown-toc-anchor"></span>

# 06_assemble.sh —— 跨模装配:把压在 tag 里的业务维度还原成关系表
<span id="heading-175" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-176" class="markdown-toc-anchor"></span>

# 背景:kwdb-tsbs 的 iot 模型把 fleet / driver / model / load_capacity 全部塞进
<span id="heading-177" class="markdown-toc-anchor"></span>

#       时序表的 tag(pkg/data/usecases/iot/truck.go:110),基准因此永远问不出
<span id="heading-178" class="markdown-toc-anchor"></span>

#       "把维度放回关系表要多少钱"。本脚本把维度还原成正规的关系台账。
<span id="heading-179" class="markdown-toc-anchor"></span>

#
# ★ 关键点:KWDB 里一个数据库只能有一个引擎,所以关系表必须建在**另一个库**
<span id="heading-180" class="markdown-toc-anchor"></span>

#   ($KWM_RELDB)里,"跨模查询"在语法上就是"跨库查询"。
<span id="heading-181" class="markdown-toc-anchor"></span>

#
# ★ 本步的台账是**由一条跨模 INSERT ... SELECT 生成的**(从时序 tag 反推),
<span id="heading-182" class="markdown-toc-anchor"></span>

#   也就是说:跨模能力从"造数据"这一步就已经在用,不是凭空假设。
<span id="heading-183" class="markdown-toc-anchor"></span>

#
# 幂等:脚本内全部是 IF NOT EXISTS / ON CONFLICT DO NOTHING。
<span id="heading-184" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:< 30 秒
<span id="heading-185" class="markdown-toc-anchor"></span>

# 用法    :bash 06_assemble.sh
<span id="heading-186" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

HERE="$(cd "$(dirname "$0")" && pwd)"
SQLSRC="${HERE}/sql/mm_dataset.sql"

step "6. 跨模装配关系台账"

[ -f "$SQLSRC" ] || die "找不到装配 SQL:$SQLSRC"
<span id="heading-187" class="markdown-toc-anchor"></span>


# 把模板里的 __TSDB__ 换成实际库名
TMP="/tmp/_mm_dataset_$$.sql"
sed "s/__TSDB__/${KWM_TSDB}/g" "$SQLSRC" > "$TMP" || die "生成 SQL 失败"

echo "  时序库 : $KWM_TSDB"
echo "  关系库 : $KWM_RELDB"
echo "  SQL    : $SQLSRC  ->  $TMP"
echo

echo "-- 执行装配 SQL --"
out=$(kwsql "$(cat "$TMP")" 2>&1); rc=$?
echo "$out" | tail -15 | sed 's/^/  /'
rm -f "$TMP"
[ "$rc" = 0 ] || die "装配失败(rc=$rc)"

echo
echo "-- 装配结果自检 --"
kwsql "SELECT (SELECT count(*) FROM ${KWM_RELDB}.public.fleets)  AS fleets,
              (SELECT count(*) FROM ${KWM_RELDB}.public.trucks)  AS trucks,
              (SELECT count(*) FROM ${KWM_TSDB}.public.readings) AS readings,
              (SELECT count(*) FROM ${KWM_TSDB}.public.diagnostics) AS diagnostics;" | sed 's/^/  /'
<span id="heading-188" class="markdown-toc-anchor"></span>


# 取数走 csv(第 2 行起就是数据;table 格式第 2 行是分隔线)
row=$(kwsql_csv "SELECT (SELECT count(*) FROM ${KWM_RELDB}.public.fleets)  AS fleets,
                        (SELECT count(*) FROM ${KWM_RELDB}.public.trucks)  AS trucks;" 2>/dev/null | sed -n '2p')
nfl=$(echo "$row" | cut -d, -f1 | tr -d '", \r')
ntr=$(echo "$row" | cut -d, -f2 | tr -d '", \r')
case "$ntr" in ''|*[!0-9]*) ntr=0 ;; esac
case "$nfl" in ''|*[!0-9]*) nfl=0 ;; esac

echo
echo "-- 台账抽样(这 5 行就是"从 tag 还原出来的业务维度")--"
kwsql "SELECT truck_id, fleet_id, driver, model, load_capacity, installed_on
       FROM ${KWM_RELDB}.public.trucks ORDER BY truck_id LIMIT 5;" | sed 's/^/  /'

echo
echo "-- 关系库确实是 RELATIONAL 引擎吗 --"
kwsql "SELECT database_name, engine_type FROM [SHOW DATABASES]
       WHERE database_name IN ('${KWM_TSDB}','${KWM_RELDB}') ORDER BY engine_type;" | sed 's/^/  /'

echo
[ "$ntr" -ge 250 ] && ok "台账 $ntr 辆车 / $nfl 个车队,装配成功" \
                   || warn "台账只有 $ntr 行,预期约 300 行,请检查 05 的导入结果"

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 07_probe.sh"
echo "------------------------------------------------------------"
脚本 sql/mm_dataset.sql(完整内容)
-- =============================================================================
-- mm_dataset.sql —— 多模数据集装配(由 06_assemble.sh 调用)
-- -----------------------------------------------------------------------------
-- 这个文件要做的事:
--   把 kwdb-tsbs 的 iot 模型"压进 tag"的业务维度(fleet / driver / model /
--   load_capacity),还原成符合业务直觉的关系台账。
--
-- 为什么必须还原:
--   pkg/data/usecases/iot/truck.go:110 把 fleet、driver、model、load_capacity
--   全部声明成 tag。于是基准里所有"按车队/按司机"的问题,都退化成
--   "在自己的宽表上按标签分组",永远问不出"把维度放回关系表要多少钱"。
--
-- ★ 两个硬约束(写 SQL 时必须遵守):
--   1) KWDB 里一个数据库只能有一个引擎 —— 关系表必须建在另一个库
--      (__TSDB___rel),"跨模查询"在语法上就是"跨库查询",
--      引用任何表都要写全   库名.public.表名
--   2) kwbase sql -e 是「先整体解析、再执行」——
--      脚本里只要混进一条语法非法的语句(例如 KWDB 3.2.2 不支持的 ANALYZE),
--      整批 SQL 一行都不会执行,而现象是"什么都没发生",极难排查。
--      所以本文件里的每一句都必须是当前版本支持的语法。
--
-- 用法(由 06_assemble.sh 自动完成,手工执行方式如下):
--   sed 's/__TSDB__/mm_bm/g' mm_dataset.sql > /tmp/d.sql
--   kwbase sql --host=<ip>:26257 --certs-dir=/etc/kaiwudb/certs --user=root \
--              --format=table -e "$(cat /tmp/d.sql)"
-- =============================================================================

-- ① 关系库:不带 ENGINE 的 CREATE DATABASE 默认落到关系引擎
CREATE DATABASE IF NOT EXISTS __TSDB___rel;

-- ② 车队台账
--    fleet_id 取值范围必须与 truck.go 的 FleetChoices 一致(East/West/North/South),
--    否则跨模联结会因键对不上而返回空集——这类"不报错但没结果"的问题最难发现。
CREATE TABLE IF NOT EXISTS __TSDB___rel.public.fleets (
  fleet_id VARCHAR(30) NOT NULL PRIMARY KEY,
  region   VARCHAR(30),
  depot    VARCHAR(30),
  manager  VARCHAR(30)
);

INSERT INTO __TSDB___rel.public.fleets (fleet_id, region, depot, manager) VALUES
  ('East',  'northeast', 'depot_harbor',    'Zhang'),
  ('West',  'northwest', 'depot_inland',    'Li'),
  ('North', 'north',     'depot_harbor',    'Wang'),
  ('South', 'south',     'depot_riverside', 'Chen')
ON CONFLICT DO NOTHING;

-- ③ 车辆台账
--    installed_on 是台账独有的列(时序表里没有),它把"关系侧的时间轴"引进来,
--    是后面"投运首日窗口"这类非等值时间联结的前提。
CREATE TABLE IF NOT EXISTS __TSDB___rel.public.trucks (
  truck_id                 VARCHAR(30) NOT NULL PRIMARY KEY,
  fleet_id                 VARCHAR(30),
  driver                   VARCHAR(30),
  model                    VARCHAR(30),
  device_version           VARCHAR(30),
  load_capacity            FLOAT8,
  fuel_capacity            FLOAT8,
  nominal_fuel_consumption FLOAT8,
  installed_on             TIMESTAMP
);

-- ④ 【关键】跨模装配:由一条 INSERT ... SELECT 从时序表的 tag 反推台账
--    · 用 last() 把每辆车的 tag 取值取出来(一个 tag 组合只对应一辆车,语义安全)
--    · installed_on 按车辆编号确定性铺开:2026-01-01 00:00 起,每车 +5 分钟
--    · ⚠ 这里的 % 12 * 5 分钟 必须与 Go 侧常量 multimode.InstallWindowSpread 一致,
--      否则拆分臂推算的"并集窗口"右界会算错,两臂就不可比了
INSERT INTO __TSDB___rel.public.trucks
  (truck_id, fleet_id, driver, model, device_version,
   load_capacity, fuel_capacity, nominal_fuel_consumption, installed_on)
SELECT last(name)                     AS truck_id,
       last(fleet)                    AS fleet_id,
       last(driver)                   AS driver,
       last(model)                    AS model,
       last(device_version)           AS device_version,
       last(load_capacity)            AS load_capacity,
       last(fuel_capacity)            AS fuel_capacity,
       last(nominal_fuel_consumption) AS nominal_fuel_consumption,
       TIMESTAMP '2026-01-01 00:00:00'
         + (CAST(replace(name, 'truck_', '') AS INT) % 12) * INTERVAL '5 minutes' AS installed_on
FROM __TSDB__.public.diagnostics
GROUP BY name;

-- ⑤ 装配结果自检(这一组数字就是后面所有实验的分母)
SELECT (SELECT count(*) FROM __TSDB___rel.public.fleets)      AS fleets,
       (SELECT count(*) FROM __TSDB___rel.public.trucks)      AS trucks,
       (SELECT count(*) FROM __TSDB__.public.readings)        AS readings,
       (SELECT count(*) FROM __TSDB__.public.diagnostics)     AS diagnostics;
实测输出
========== 6. 跨模装配关系台账 ==========
  时序库 : mm_bm
  关系库 : mm_bm_rel
  SQL    : /tsbs/reproduce/sql/mm_dataset.sql  ->  /tmp/_mm_dataset_13329.sql

-- 执行装配 SQL --
    fleets | trucks | readings | diagnostics
  ---------+--------+----------+--------------
         4 |    300 |  2333572 |     2334325
  (1 row)

-- 台账抽样(这 5 行就是从 tag 还原出来的业务维度)--
    truck_id  | fleet_id | driver | model  | load_capacity |    installed_on
  ------------+----------+--------+--------+---------------+----------------------
    truck_0   | East     | Rodney | G-2000 |          5000 | 2026-01-01 00:00:00
    truck_1   | North    | Albert | F-150  |          2000 | 2026-01-01 00:05:00
    truck_10  | North    | Trish  | F-150  |          2000 | 2026-01-01 00:50:00
    truck_100 | South    | Seth   | H-2    |          1500 | 2026-01-01 00:20:00
    truck_101 | North    | Derek  | H-2    |          1500 | 2026-01-01 00:25:00
  (5 rows)

-- 关系库确实是 RELATIONAL 引擎吗 --
    database_name | engine_type
  ----------------+--------------
    mm_bm_rel     | RELATIONAL
    mm_bm         | TIME SERIES
  (2 rows)

[ OK ] 台账 300 辆车 / 4 个车队,装配成功
成功判据:trucks = 300、fleets = 4,且 mm_bm_rel 的引擎类型为 RELATIONAL。
7.3.1 装配 SQL 的三处设计
(一)台账由跨模写入产生
INSERT INTO mm_bm_rel.public.trucks (...)
SELECT last(name)          AS truck_id,
       last(fleet)         AS fleet_id,
       ...
FROM mm_bm.public.diagnostics
GROUP BY name;
该语句同时用到了阶段 07 探针中的 P9(时序聚合下沉)与 P11(跨模写入 INSERT…SELECT)。其本身即一次跨模查询,构成台账可被装配的直接证据。
(二)installed_on 为台账独有列
时序表不含该列。它的作用是引入关系侧的时间轴,这是 mm-install-window(投运之后首小时的行驶里程)可用的前提。默认值按车辆编号确定性展开:2026-01-01 00:00:00 + (车号 % 12) × 5 分钟。
(三)关系侧键值必须与时序侧标签一致
fleets 表的 fleet_id 取值(East / West / North / South)必须与 TSBS 源码 truck.go 中的 FleetChoices 逐字一致。取值不一致时跨模联结不会报错,而是返回空集。此类问题排查成本较高,SQL 中已加注释提示。
7.3.2 批次解析导致的静默失败
装配 SQL 中曾混入一条 ANALYZE(用于更新统计信息)。执行结果为整批 SQL 均未执行,且无任何错误提示。
根因是 kwbase sql -e 的语义:先完整解析 -e 参数,再开始执行。其中任一语句语法不合法,整批均不执行。KWDB 3.2.2 不支持 ANALYZE:
ERROR: at or near "analyze": syntax error
SQLSTATE: 42601
由此得到两条结论:
-e中的 SQL 全对才执行,全错则全不执行。批量操作时不应将可能不被支持的语句与关键语句置于同一批次;- KWDB 3.2.2 不支持
ANALYZE,编写脚本时需避开。阶段 07 的 P12 探针会将该边界测出。
8 阶段 07:跨模能力边界
编写模板之前,需先确定哪些写法可用、哪些不可用、哪些可用但代价较高。本阶段用 12 条最小 SQL 一次性测出边界。
执行位置:KWDB 所在主机 执行用户:root 预计耗时:小于 30 秒
bash 07_probe.sh
脚本 07_probe.sh(完整内容)
#!/bin/bash
<span id="heading-192" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-193" class="markdown-toc-anchor"></span>

# 07_probe.sh —— 跨模查询可行性探针(12 项)
<span id="heading-194" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-195" class="markdown-toc-anchor"></span>

# 做什么:在**独立的小库**上(不影响主实验库)逐条验证 KWDB 3.2.2 的跨模能力,
<span id="heading-196" class="markdown-toc-anchor"></span>

#         把"能不能写、哪些写法不能用"从猜测变成可复跑的结论。
<span id="heading-197" class="markdown-toc-anchor"></span>

#
# ★ 为什么要有独立探针库:
<span id="heading-198" class="markdown-toc-anchor"></span>

#   探针是"试探语法"的,里面必然有故意会失败的语句。直接打在主实验库上,
<span id="heading-199" class="markdown-toc-anchor"></span>

#   一旦某条语句被整体解析(kwbase sql -e 是先整体解析再执行),会让整批不执行,
<span id="heading-200" class="markdown-toc-anchor"></span>

#   污染后续实验。所以探针一律在 mm_rel / mm_ts 两个小库上做,与主库物理隔离。
<span id="heading-201" class="markdown-toc-anchor"></span>

#
# 判据:每条探针都标注"期望",脚本会对比实际结果;末尾给出与预期不符的条目。
<span id="heading-202" class="markdown-toc-anchor"></span>

# 幂等:每次重建探针库,保证结果可重复。
<span id="heading-203" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:约 1 分钟
<span id="heading-204" class="markdown-toc-anchor"></span>

# 用法    :bash 07_probe.sh
<span id="heading-205" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

PR=mm_rel      # 探针关系库
PT=mm_ts       # 探针时序库

MISMATCH=0

step "7. 跨模查询可行性探针"
<span id="heading-206" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo "-- 7.1 准备探针库(关系引擎 + 时序引擎各一个,3 行样本)--"
kwsql "
DROP DATABASE IF EXISTS $PR CASCADE;
DROP DATABASE IF EXISTS $PT CASCADE;
CREATE DATABASE $PR;
CREATE TS DATABASE $PT PARTITION INTERVAL 1d;
CREATE TABLE $PR.public.meters (
  meter_id      VARCHAR(30) NOT NULL PRIMARY KEY,
  region        VARCHAR(30),
  customer_type VARCHAR(20),
  transformer   VARCHAR(30),
  capacity_kwh  FLOAT8,
  installed_on  TIMESTAMP
);
INSERT INTO $PR.public.meters (meter_id, region, customer_type, transformer, capacity_kwh, installed_on) VALUES
  ('meter_0','east','residential','tr_0', 10.0, TIMESTAMP '2026-01-01 00:00:00'),
  ('meter_1','east','commercial', 'tr_0', 30.0, TIMESTAMP '2026-01-01 00:05:00'),
  ('meter_2','west','industrial', 'tr_1',100.0, TIMESTAMP '2026-01-01 00:10:00');
CREATE TABLE $PT.public.mtr_readings (
  k_timestamp TIMESTAMP NOT NULL,
  kwh         FLOAT8 NOT NULL,
  voltage     FLOAT8 NOT NULL,
  current_a   FLOAT8 NOT NULL
) TAGS (meter_id VARCHAR(30) NOT NULL) PRIMARY TAGS (meter_id);
INSERT INTO $PT.public.mtr_readings VALUES
  ('2026-01-01 00:00:00', 1.2, 220.1, 5.4, 'meter_0'),
  ('2026-01-01 00:05:00', 1.5, 219.8, 6.1, 'meter_0'),
  ('2026-01-01 00:00:00', 4.0, 380.2,12.0, 'meter_2');
" >/dev/null 2>&1 && ok "探针库就绪:$PR(关系) / $PT(时序)" || die "探针库创建失败"
<span id="heading-207" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
<span id="heading-208" class="markdown-toc-anchor"></span>

# probe <编号> <名称> <期望 ok|err> <SQL>
probe() {
  local id="$1" name="$2" expect="$3" sql="$4"
  local out rc t0 t1 ms errline verdict glimpse
  t0=$(date +%s%N)
  out=$(kwsql "$sql" 2>&1); rc=$?
  t1=$(date +%s%N); ms=$(( (t1-t0)/1000000 ))
  errline=$(echo "$out" | grep -iE 'ERROR|SQLSTATE' | head -1 | cut -c1-74)
<span id="heading-209" class="markdown-toc-anchor"></span>

  # table 格式:第 1 行表头、第 2 行分隔线、第 3 行才是数据
  glimpse=$(echo "$out" | sed -n '3p' | tr -s ' ' | cut -c1-46)

  if [ "$expect" = ok ]; then
    if [ "$rc" = 0 ] && [ -z "$errline" ]; then verdict="支持"; else
      verdict="不支持(与预期不符)"; MISMATCH=$((MISMATCH+1)); fi
  else
    if [ -n "$errline" ]; then verdict="不支持(符合预期)"; else
      verdict="意外支持(需修正结论)"; MISMATCH=$((MISMATCH+1)); fi
  fi

  printf '%-4s %-30s %-22s %5dms\n' "$id" "$name" "$verdict" "$ms"
  [ -n "$glimpse" ] && printf '      结果: %s\n' "$glimpse"
  [ -n "$errline" ] && printf '      报错: %s\n' "$errline"
}

echo
echo "=============================================================="
printf '%-4s %-30s %-22s %s\n' "编号" "能力" "结论" "耗时"
echo "--------------------------------------------------------------"

probe "P1" "跨模等值 JOIN" ok "
SELECT m.region AS region, count(DISTINCT m.meter_id) AS meters, sum(r.kwh) AS total_kwh
FROM $PR.public.meters m
JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.region ORDER BY region;"

probe "P2" "跨模 CTAS(时序→关系)" ok "
CREATE DATABASE IF NOT EXISTS mm_probe_ctas;
DROP TABLE IF EXISTS mm_probe_ctas.public.from_ts;
CREATE TABLE mm_probe_ctas.public.from_ts AS
  SELECT DISTINCT meter_id FROM $PT.public.mtr_readings;
SELECT count(*) AS ctas_rows FROM mm_probe_ctas.public.from_ts;"

probe "P3" "interval 字面量与算术" ok "
SELECT now() AS now_ts, now() + interval '1 day' AS plus_1d, now() - interval '10 minutes' AS minus_10m;"

probe "P4" "两跳跨模 JOIN(关系→关系→时序)" ok "
SELECT count(*) AS twohop_rows
FROM $PR.public.meters m
JOIN $PR.public.meters m2 ON m2.meter_id = m.meter_id
JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id;"

probe "P5" "count(DISTINCT)+ORDER BY+LIMIT" ok "
SELECT m.region AS region, count(DISTINCT m.meter_id) AS meters, sum(r.kwh) AS total_kwh
FROM $PR.public.meters m
JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.region ORDER BY total_kwh DESC LIMIT 5;"

probe "P6" "关系侧列进 HAVING(阈值比对)" ok "
SELECT m.meter_id, max(r.kwh) AS peak_kwh, m.capacity_kwh
FROM $PR.public.meters m
JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.meter_id, m.capacity_kwh
HAVING max(r.kwh) > m.capacity_kwh
ORDER BY peak_kwh DESC LIMIT 5;"

probe "P7" "非等值时间联结(语法层面)" ok "
SELECT m.meter_id, m.installed_on, sum(r.kwh) AS first_day_kwh
FROM $PR.public.meters m
JOIN $PT.public.mtr_readings r
  ON r.meter_id = m.meter_id
 AND r.k_timestamp >= m.installed_on
 AND r.k_timestamp <  m.installed_on + interval '1 day'
GROUP BY m.meter_id, m.installed_on ORDER BY m.meter_id;"

probe "P8" "last() 直接进跨模 JOIN" err "
SELECT m.region AS region, last(r.kwh) AS last_kwh
FROM $PR.public.meters m
JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.region;"

probe "P9" "绕过:时序聚合下沉子查询" ok "
SELECT m.region AS region, x.last_kwh
FROM (SELECT meter_id, last(kwh) AS last_kwh FROM $PT.public.mtr_readings GROUP BY meter_id) x
JOIN $PR.public.meters m ON m.meter_id = x.meter_id;"

probe "P10" "time_bucket 进跨模 JOIN" ok "
SELECT m.region AS region, time_bucket(r.k_timestamp, '1h') AS bucket, avg(r.kwh) AS av
FROM $PR.public.meters m
JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.region, time_bucket(r.k_timestamp, '1h') ORDER BY bucket LIMIT 5;"

probe "P11" "跨模写入 INSERT...SELECT" ok "
CREATE TABLE IF NOT EXISTS $PR.public.meter_facts (
  meter_id VARCHAR(30) NOT NULL PRIMARY KEY, region VARCHAR(30), kwh_sum FLOAT8);
DELETE FROM $PR.public.meter_facts;
INSERT INTO $PR.public.meter_facts (meter_id, region, kwh_sum)
SELECT m.meter_id, m.region, sum(r.kwh)
FROM $PR.public.meters m JOIN $PT.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.meter_id, m.region;
SELECT count(*) AS written FROM $PR.public.meter_facts;"

probe "P12" "ANALYZE 语句" err "ANALYZE $PR.public.meters;"

echo "--------------------------------------------------------------"

echo
echo "-- 7.2 探针结论汇总 --"
cat <<'TXT'
  支持(可直接写进跨模模板):
    P1  跨模等值 JOIN                     关系表 × 时序表联结,本文 4 个模板的基础
    P2  跨模 CTAS                         用时序表数据直接建关系表
    P3  interval 字面量与算术              时间窗计算
    P4  两跳跨模 JOIN                     关系A → 关系B → 时序
    P5  count(DISTINCT)+ORDER BY+LIMIT    常规结果整形
    P6  关系侧列进 HAVING                 关系侧的阈值/容量参与筛选
    P7  非等值时间联结                     语法可行 —— 但代价是另一个量级,见 10_decompose.sh
    P9  时序聚合下沉子查询                 绕过 P8 限制的官方可行路径
    P10 time_bucket 进跨模 JOIN           时序分桶 + 关系维度
    P11 跨模写入 INSERT...SELECT          本文装配台账用的就是这条路

  不支持(写模板时必须避开):
    P8  last()/last_row() 直接进跨模 JOIN  报 SQLSTATE 0A000,须下沉为子查询
    P12 ANALYZE                            语法错误 42601;
       ★ 连带坑:kwbase sql -e 是**先整体解析再执行**,
         只要脚本里混进一条 ANALYZE,整批 SQL 一行都不会执行,
         而现象是"什么都没有发生",极难排查。
TXT

echo
if [ "$MISMATCH" = 0 ]; then
  ok "12 项探针结果与预期完全一致"
else
  fail "有 $MISMATCH 项与预期不符 —— 可能是 KWDB 版本差异,请以上表实际输出为准修正结论"
fi

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 08_baseline.sh"
echo "------------------------------------------------------------"
实测输出
========== 7. 跨模查询可行性探针 ==========
-- 7.1 准备探针库(关系引擎 + 时序引擎各一个,3 行样本)--
[ OK ] 探针库就绪:mm_rel(关系) / mm_ts(时序)

==============================================================
编号 能力                         结论                 耗时
--------------------------------------------------------------
P1   跨模等值 JOIN              支持                    53ms
      结果:  east | 1 | 2.7
P2   跨模 CTAS(时序→关系) 支持                    80ms
      结果:  2
P3   interval 字面量与算术    支持                    50ms
      结果:  2026-10-01 12:29:35.688780884+00:00 | 2026-10
P4   两跳跨模 JOIN(关系→关系→时序) 支持                    53ms
      结果:  3
P5   count(DISTINCT)+ORDER BY+LIMIT 支持                    51ms
      结果:  west | 1 | 4
P6   关系侧列进 HAVING(阈值比对) 支持                    53ms
      结果: (0 rows)
P7   非等值时间联结(语法层面) 支持                    52ms
      结果:  meter_0 | 2026-01-01 00:00:00 | 2.7
P8   last() 直接进跨模 JOIN    不支持(符合预期)    50ms
      结果: Failed running "sql"
      报错: ERROR: last() can only be used in timeseries table query or subquery
P9   绕过:时序聚合下沉子查询 支持                    52ms
      结果:  east | 1.5
P10  time_bucket 进跨模 JOIN     支持                    53ms
      结果:  east | 2026-01-01 00:00:00+00:00 | 1.35
P11  跨模写入 INSERT...SELECT   支持                    64ms
      结果:  2
P12  ANALYZE 语句                 不支持(符合预期)    51ms
      结果: DETAIL: source SQL:
      报错: ERROR: at or near "analyze": syntax error
--------------------------------------------------------------

[ OK ] 12 项探针结果与预期完全一致
成功判据:末尾出现 12 项探针结果与预期完全一致。P8 与 P12 的「不支持」属于预期结果,脚本将其计为通过。
8.1 能力边界表
探针结论整理如下,可直接查用。
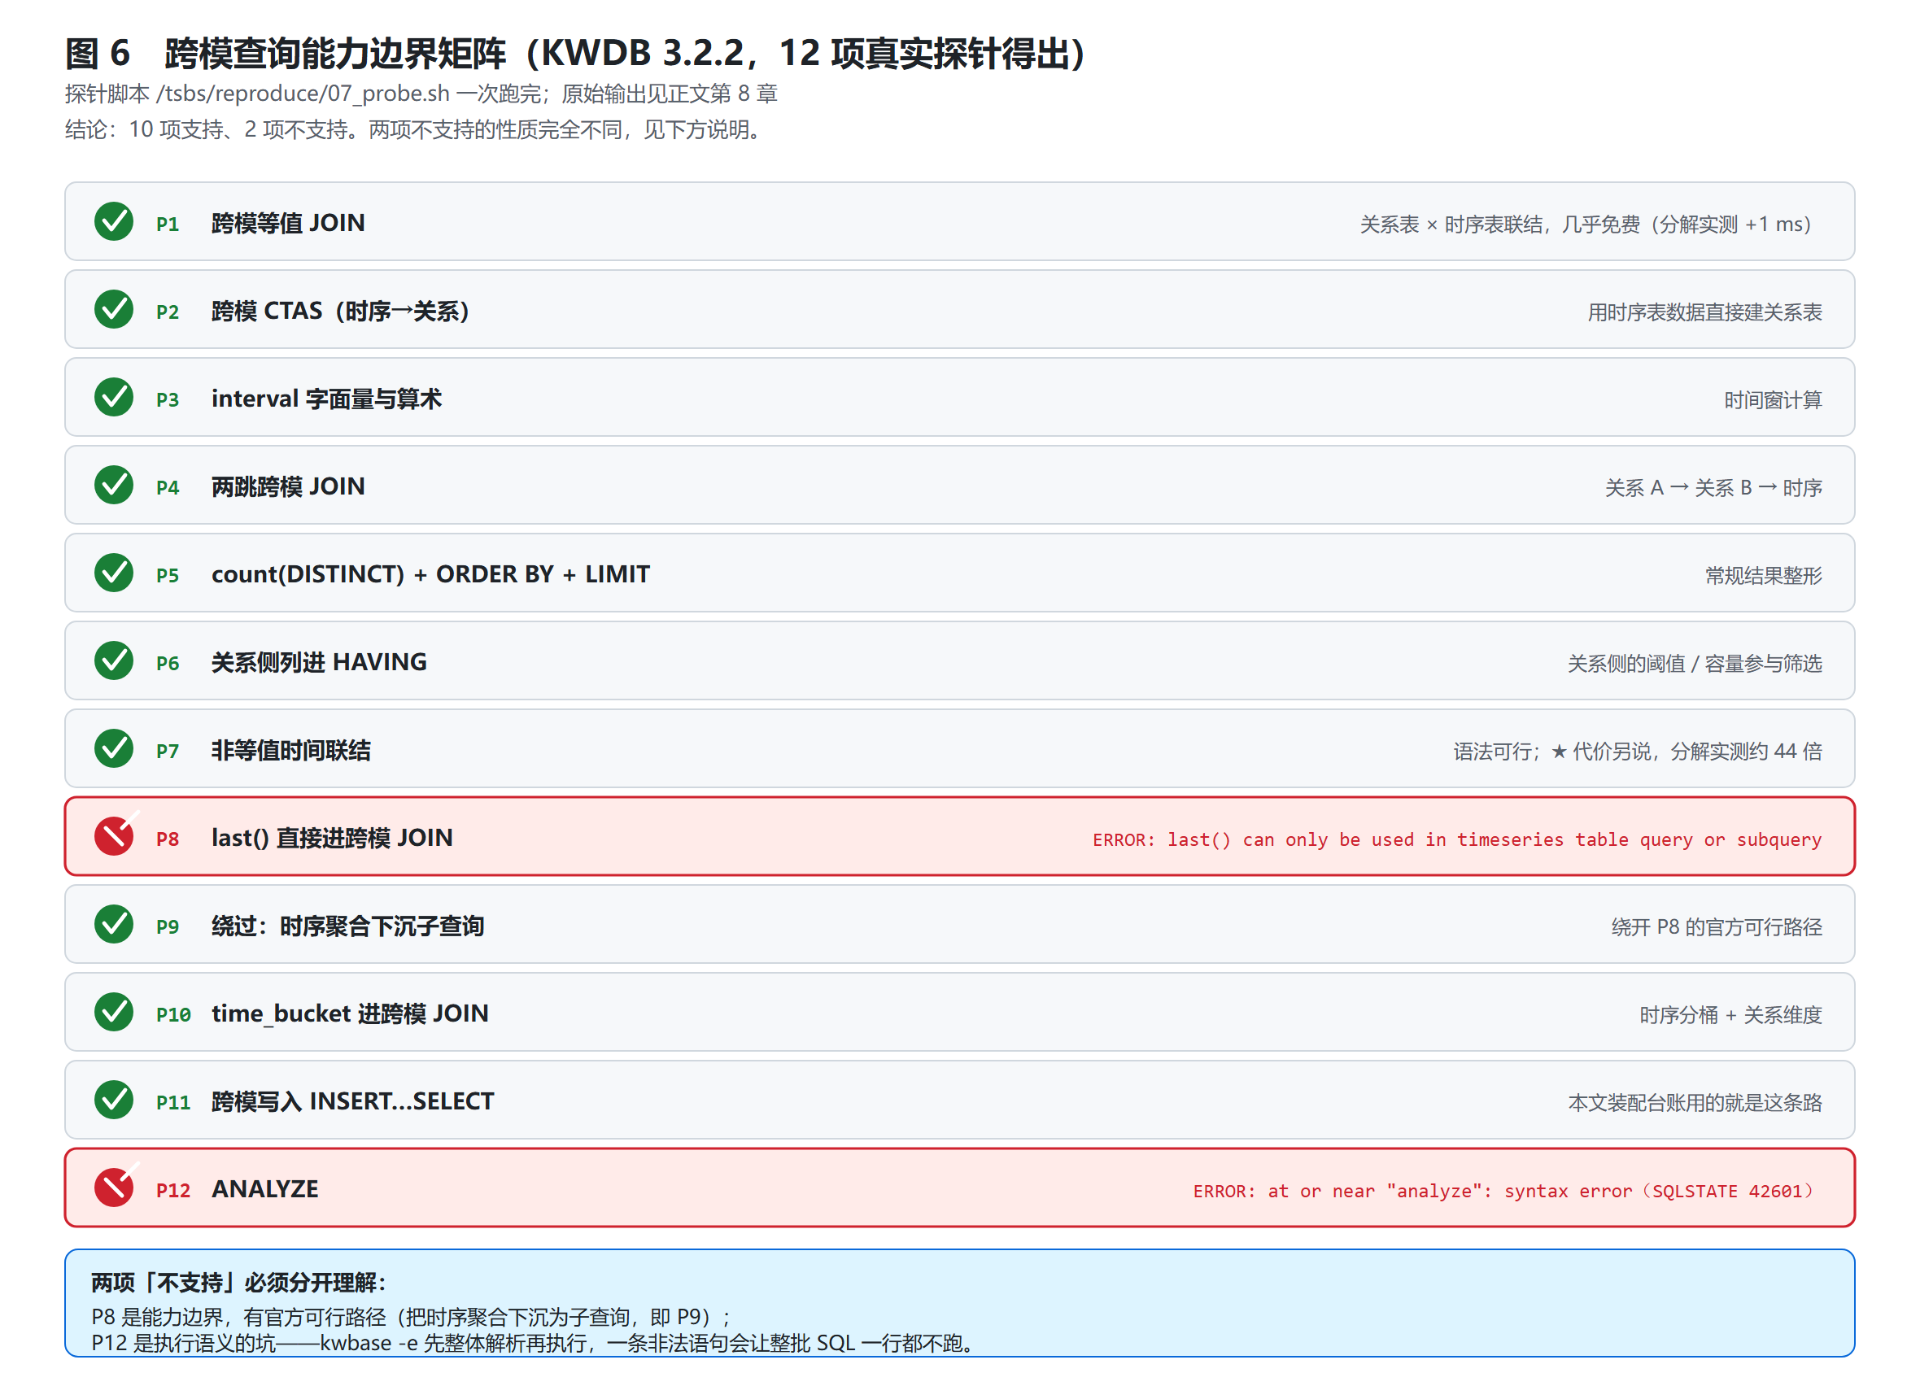
| 编号 | 能力 | 结论 | 说明 |
|---|---|---|---|
| P1 | 跨模等值 JOIN | 支持 | 关系表与时序表联结,本文 4 个模板的基础 |
| P2 | 跨模 CTAS | 支持 | 用时序表数据建关系表 |
| P3 | interval 字面量与算术 |
支持 | 时间窗计算 |
| P4 | 两跳跨模 JOIN | 支持 | 关系 A → 关系 B → 时序 |
| P5 | count(DISTINCT) 加 ORDER BY 加 LIMIT |
支持 | 常规结果整形 |
| P6 | 关系侧列进 HAVING |
支持 | 关系侧阈值或容量参与筛选 |
| P7 | 非等值时间联结 | 语法可行,代价另计 | 见 10.4 节 |
| P8 | last() / last_row() 直接进跨模 JOIN |
不支持,SQLSTATE 0A000 |
需下沉为子查询,见 P9 |
| P9 | 时序聚合下沉子查询 | 支持 | 绕过 P8 的可行路径 |
| P10 | time_bucket 进跨模 JOIN |
支持 | 时序分桶加关系维度 |
| P11 | 跨模写入 INSERT…SELECT |
支持 | 台账装配使用该路径 |
| P12 | ANALYZE |
不支持,语法错误 42601 |
会牵连整批 SQL |
注意:P7 与 P12 两项需特别对待。P7 的支持仅限于语法层面,代价属另一量级(10.4 节实测约 44 倍)。P12 的不支持会牵连整批 SQL,原因见 7.3.2 节。
8.2 两类不支持的处理方式
P8(last() 不能直接进跨模 JOIN)属于能力边界,存在可行的替代路径:将时序聚合下沉为子查询后再联结(P9)。按 P9 组织查询即可。
P12(不支持 ANALYZE)在本实验中影响有限,因为 TSBS 数据分布均匀,不依赖统计信息。但其反映的执行语义(-e 全批解析)会带来实际影响,可把一条无害语句变为整批静默失败。
概括而言:P8 属于更换写法即可解决的情形,P12 属于需要注意语句顺序与批次划分的情形。
9 阶段 08:官方基线复现
引入新维度之前,先原样复现官方基线。该步骤有两项作用:确认环境标定正常,以及为后续对比提供参照。
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测约 2 分钟(含 cpu-only 数据准备)
bash 08_baseline.sh
脚本 08_baseline.sh(完整内容)
#!/bin/bash
<span id="heading-213" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-214" class="markdown-toc-anchor"></span>

# 08_baseline.sh —— 复现官方 tsbs 基线(29 个模板)
<span id="heading-215" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-216" class="markdown-toc-anchor"></span>

# 做什么:把 kwdb-tsbs 自带的全部官方查询模板跑一遍,得到"官方基准测到了什么"。
<span id="heading-217" class="markdown-toc-anchor"></span>

#         cpu-only(devops) 16 项 + iot 13 项 = 29 项。
<span id="heading-218" class="markdown-toc-anchor"></span>

#
# ★ 为什么这里有两次数据准备:
<span id="heading-219" class="markdown-toc-anchor"></span>

#   官方两套模板查的**不是同一张表**——cpu-only 查 <db>.public.cpu,
<span id="heading-220" class="markdown-toc-anchor"></span>

#   iot 查 <db>.public.{readings,diagnostics}。所以必须落在两个库上。
<span id="heading-221" class="markdown-toc-anchor"></span>

#   如果偷懒只用一个库,cpu-only 那 16 个模板会全部报"表不存在",
<span id="heading-222" class="markdown-toc-anchor"></span>

#   而汇总脚本会把它们当成"没有数据"静默跳过 —— 最后你会得到一张
<span id="heading-223" class="markdown-toc-anchor"></span>

#   看起来正常、其实只剩 13 行的表。这是本文实测踩到过的一个坑。
<span id="heading-224" class="markdown-toc-anchor"></span>

#
# ★ 三个必须注意的点(都是实测踩出来的):
<span id="heading-225" class="markdown-toc-anchor"></span>

#   1) tsbs_run_queries_kwdb 必须显式给 --query-type,且要和查询文件里的
<span id="heading-226" class="markdown-toc-anchor"></span>

#      querytype 逐字一致,否则直接 panic(源码 main.go:110 的硬校验)
<span id="heading-227" class="markdown-toc-anchor"></span>

#   2) 查询类型名必须与源码常量一致。iot 的"单车最后位置"标签是
<span id="heading-228" class="markdown-toc-anchor"></span>

#      single-last-loc,不是 last-loc-single-truck(后者不存在,会让生成器静默失败)
<span id="heading-229" class="markdown-toc-anchor"></span>

#   3) 生成器的报错走 stdout、用量信息走 stderr,必须两路都收;且要对生成的
<span id="heading-230" class="markdown-toc-anchor"></span>

#      查询文件做存在性判空,否则会得到"生成失败 → runner 报打不开文件"的假阴性
<span id="heading-231" class="markdown-toc-anchor"></span>

#
# 执行位置:KWDB 所在主机      执行用户:root
<span id="heading-232" class="markdown-toc-anchor"></span>

# 预计耗时:约 2~4 分钟(含 cpu-only 数据生成约 20 秒 + 导入 + 29 个模板)
<span id="heading-233" class="markdown-toc-anchor"></span>

# 用法    :bash 08_baseline.sh
<span id="heading-234" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

GEN="${KWM_SRC}/bin/tsbs_generate_queries"
GEND="${KWM_SRC}/bin/tsbs_generate_data"
LOAD="${KWM_SRC}/bin/tsbs_load_kwdb"
RUN="${KWM_SRC}/bin/tsbs_run_queries_kwdb"
CPUDB="$KWM_CPUDB"
TSDB="$KWM_TSDB"

CPU_TYPES="single-groupby-1-1-1 single-groupby-1-1-12 single-groupby-1-8-1
single-groupby-5-1-1 single-groupby-5-1-12 single-groupby-5-8-1
cpu-max-all-1 cpu-max-all-8 cpu-max-all-32-24
double-groupby-1 double-groupby-5 double-groupby-all
groupby-orderby-limit high-cpu-all high-cpu-1 lastpoint"

IOT_TYPES="last-loc single-last-loc low-fuel high-load stationary-trucks
long-driving-sessions long-daily-sessions avg-vs-projected-fuel-consumption
avg-daily-driving-duration avg-daily-driving-session avg-load
daily-activity breakdown-frequency"

step "8. 复现官方基线(cpu-only 16 + iot 13)"

[ -x "$GEN" ] || die "找不到 $GEN,请先执行 03_build.sh"
mkdir -p "$KWM_QD" "$KWM_RAW" || die "无法创建输出目录"
<span id="heading-235" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo "-- 8.1 准备 cpu-only 基线(数据 + 库,独立于 iot 库)--"
CDAT="${KWM_LOAD}/cpu-only_scale${KWM_SCALE}_1d.dat"

if [ -s "$CDAT" ]; then
  ok "cpu-only 数据集已存在,跳过生成"
else
  echo "  生成 $CDAT ..."
  "$GEND" --format=kwdb --use-case=cpu-only --seed=123 --scale="$KWM_SCALE" \
    --log-interval=10s \
    --timestamp-start="$KWM_TS_START" --timestamp-end="$KWM_TS_END" \
    --orderquantity=12 --file="$CDAT" >/dev/null 2>&1 \
    && ok "生成完成($(du -h "$CDAT" | cut -f1))" || die "cpu-only 数据生成失败"
fi

pre=$(kwsql_scalar "SELECT count(*) FROM ${CPUDB}.public.cpu;")
case "$pre" in ''|*[!0-9]*) pre="" ;; esac
if [ -n "$pre" ] && [ "$pre" != "0" ]; then
  ok "库 $CPUDB 已有 $pre 行数据,跳过导入"
else
  echo "  导入到 $CPUDB ..."
  "$LOAD" --file="$CDAT" --user="$KWM_USER" \
    --host="$KWM_HOST" --port="$KWM_PORT" --certdir="$KWM_CERTS" \
    --insert-type=insert --dbname="$CPUDB" --db-name="$CPUDB" \
    --case=cpu-only --batch-size=10000 --partition=false --workers=12 \
    --results-file="$KWM_RPT/load_cpu_scale${KWM_SCALE}.json" 2>&1 | tail -3 | sed 's/^/    /'
  ok "cpu-only 导入完成"
fi
echo "  库内容:$(kwsql_scalar "SELECT count(*) FROM ${CPUDB}.public.cpu;") 行"
<span id="heading-236" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo
echo "8.2 逐模板执行"
printf '%-42s %-6s %-10s %s\n' "QUERY-TYPE" "rc" "qps" "延迟 min/med/mean/max (ms)"
echo "---------------------------------------------------------------------------------------"

run_one() {  # run_one <use-case> <query-type> <db>
  local uc="$1" qt="$2" db="$3"
  local qf="$KWM_QD/${uc}__${qt}.dat"
  local lf="$KWM_RAW/${uc}__${qt}.log"
  local rf="$KWM_RAW/${uc}__${qt}.json"

  "$GEN" --use-case="$uc" --seed=123 --scale="$KWM_SCALE" \
    --query-type="$qt" --format=kwdb --queries="$KWM_QNUM" --db-name="$db" \
    --timestamp-start="$KWM_TS_START" --timestamp-end="$KWM_TS_END" \
    --file="$qf" >"$lf.gen.out" 2>"$lf.gen.err"
  if [ ! -s "$qf" ]; then
    printf '%-42s %-6s %s\n' "$uc/$qt" "GEN" "生成失败: $(head -1 "$lf.gen.out" 2>/dev/null)"
    return 1
  fi

  "$RUN" --query-type="$qt" \
    --host="$KWM_HOST" --port="$KWM_PORT" --user="$KWM_USER" --certdir="$KWM_CERTS" \
    --db-name="$db" --file="$qf" --workers="$KWM_WORKERS" \
    --results-file="$rf" >"$lf" 2>&1
  local rc=$?

  local qps lat
  qps=$(grep -oE 'Overall query rate [0-9.]+' "$lf" | tail -1 | awk '{print $4}')
  lat=$(grep -E '^min:' "$lf" | tail -1 | sed -E 's/[[:space:]]+/ /g; s/^min: //; s/ms//g')
  if [ -z "$lat" ]; then
    printf '%-42s %-6s %s\n' "$uc/$qt" "$rc" "FAIL: $(grep -iE 'error|panic' "$lf" | head -1 | cut -c1-60)"
    return 1
  fi
  printf '%-42s %-6s %-10s %s\n' "$uc/$qt" "$rc" "${qps:--}" "$lat"
}

for qt in $CPU_TYPES; do run_one cpu-only "$qt" "$CPUDB"; done
echo "---------------------------------------------------------------------------------------"
for qt in $IOT_TYPES; do run_one iot "$qt" "$TSDB"; done
echo "---------------------------------------------------------------------------------------"
<span id="heading-237" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo
echo "-- 8.3 汇总(写入 $KWM_RPT/baseline_table.txt)--"
{
  printf '【表 1】官方基线 / cpu-only(devops):16 个模板   库=%s\n' "$CPUDB"
  printf '%-38s %-10s %-11s %-11s %-11s %-11s\n' "QUERY-TYPE" "qps" "min" "med" "mean" "max"
  printf '%s\n' "$(printf '%.0s-' $(seq 1 100))"
  for f in "$KWM_RAW"/cpu-only__*.log; do
    [ -s "$f" ] || continue
    lat=$(grep -E '^min:' "$f" | tail -1); [ -z "$lat" ] && continue
    qps=$(grep -oE 'Overall query rate [0-9.]+' "$f" | tail -1 | awk '{print $4}')
    printf '%-38s %-10s %s\n' "$(basename "$f" .log)" "${qps:--}" "$(echo "$lat" | sed -E 's/[[:space:]]+/ /g')"
  done
  printf '\n【表 2】官方基线 / iot:13 个模板   库=%s\n' "$TSDB"
  printf '%-38s %-10s %-11s %-11s %-11s %-11s\n' "QUERY-TYPE" "qps" "min" "med" "mean" "max"
  printf '%s\n' "$(printf '%.0s-' $(seq 1 100))"
  for f in "$KWM_RAW"/iot__*.log; do
    [ -s "$f" ] || continue
    lat=$(grep -E '^min:' "$f" | tail -1); [ -z "$lat" ] && continue
    qps=$(grep -oE 'Overall query rate [0-9.]+' "$f" | tail -1 | awk '{print $4}')
    printf '%-38s %-10s %s\n' "$(basename "$f" .log)" "${qps:--}" "$(echo "$lat" | sed -E 's/[[:space:]]+/ /g')"
  done
} > "$KWM_RPT/baseline_table.txt"
cat "$KWM_RPT/baseline_table.txt"

ncpu=$(grep -c '^cpu-only__' "$KWM_RPT/baseline_table.txt")
niot=$(grep -c '^iot__' "$KWM_RPT/baseline_table.txt")
echo
echo "  cpu-only 成功 $ncpu / 16    iot 成功 $niot / 13"
if [ "$ncpu" -eq 16 ] && [ "$niot" -eq 13 ]; then
  ok "官方基线 29 个模板全部跑通"
else
  fail "模板数不足(cpu-only $ncpu/16,iot $niot/13)—— 请回看上面的 FAIL 行"
fi

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 09_bench.sh"
echo "------------------------------------------------------------"
实测输出
========== 8. 复现官方基线(cpu-only 16 + iot 13) ==========
-- 8.1 准备 cpu-only 基线(数据 + 库,独立于 iot 库)--
[ OK ] cpu-only 数据集已存在,跳过生成
[ OK ] 库 tsbs_bench 已有 2592000 行数据,跳过导入

8.2 逐模板执行
QUERY-TYPE                                 rc     qps        延迟 min/med/mean/max (ms)
---------------------------------------------------------------------------------------
cpu-only/single-groupby-1-1-1              0      847.13     0.69, med: 0.73, mean: 0.78, max: 1.27, ...
cpu-only/single-groupby-1-1-12             0      570.07     1.04, med: 1.08, mean: 1.31, max: 3.27, ...
cpu-only/single-groupby-1-8-1              0      693.96     0.95, med: 0.99, mean: 1.01, max: 1.22, ...
cpu-only/single-groupby-5-1-1              0      764.66     0.82, med: 0.85, mean: 0.87, max: 1.07, ...
cpu-only/single-groupby-5-1-12             0      397.00     1.47, med: 1.52, mean: 1.84, max: 5.55, ...
cpu-only/single-groupby-5-8-1              0      545.38     1.27, med: 1.34, mean: 1.38, max: 1.62, ...
cpu-only/cpu-max-all-1                     0      680.31     0.95, med: 0.98, mean: 1.01, max: 1.17, ...
cpu-only/cpu-max-all-8                     0      450.21     1.67, med: 1.75, mean: 1.78, max: 2.00, ...
cpu-only/cpu-max-all-32-24                 0      218.24     3.81, med: 3.93, mean: 4.14, max: 5.87, ...
cpu-only/double-groupby-1                  0      206.67     4.07, med: 4.33, mean: 4.35, max: 4.86, ...
cpu-only/double-groupby-5                  0      104.96     7.70, med: 8.97, mean: 9.06, max: 10.23, ...
cpu-only/double-groupby-all                0      65.95      12.70, med: 14.65, mean: 14.69, max: 18.43, ...
cpu-only/groupby-orderby-limit             0      595.88     1.05, med: 1.15, mean: 1.20, max: 1.69, ...
cpu-only/high-cpu-all                      0      60.51      14.12, med: 15.76, mean: 16.08, max: 19.97, ...
cpu-only/high-cpu-1                        0      670.24     0.72, med: 0.86, mean: 1.01, max: 1.81, ...
cpu-only/lastpoint                         0      769.98     0.76, med: 0.82, mean: 0.86, max: 1.31, ...
---------------------------------------------------------------------------------------
iot/last-loc                               0      804.57     0.68, med: 0.73, mean: 0.81, max: 1.27, ...
iot/single-last-loc                        0      989.83     0.34, med: 0.55, mean: 0.55, max: 0.72, ...
iot/low-fuel                               0      143.14     4.11, med: 6.56, mean: 6.56, max: 8.24, ...
iot/high-load                              0      759.84     0.73, med: 0.78, mean: 0.85, max: 1.47, ...
iot/stationary-trucks                      0      330.06     1.31, med: 1.69, mean: 2.58, max: 6.57, ...
iot/long-driving-sessions                  0      394.06     1.67, med: 1.92, mean: 2.07, max: 4.15, ...
iot/long-daily-sessions                    0      589.83     1.12, med: 1.18, mean: 1.21, max: 1.55, ...
iot/avg-vs-projected-fuel-consumption      0      20.62      35.69, med: 46.82, mean: 48.05, max: 61.81, ...
iot/avg-daily-driving-duration             0      77.44      8.62, med: 12.24, mean: 12.42, max: 19.70, ...
iot/avg-daily-driving-session              0      9.36       101.99, med: 106.11, mean: 106.28, max: 111.37, ...
iot/avg-load                               0      521.59     1.14, med: 1.27, mean: 1.45, max: 3.32, ...
iot/daily-activity                         0      95.03      7.87, med: 9.06, mean: 10.04, max: 14.39, ...
iot/breakdown-frequency                    0      3.13       308.08, med: 317.04, mean: 318.60, max: 333.44, ...
---------------------------------------------------------------------------------------

  cpu-only 成功 16 / 16    iot 成功 13 / 13
[ OK ] 官方基线 29 个模板全部跑通
成功判据:输出 29 个模板全部跑通,且每个模板的 rc 均为 0。
9.1 分辨率
将 29 个模板的中位延迟排列后得到下表。
| 集合 | 最快模板 | 最慢模板 | 跨度 |
|---|---|---|---|
| cpu-only(16) | single-groupby-1-1-1 0.73 ms / 847 qps |
high-cpu-all 15.76 ms / 60.51 qps |
21.6× |
| iot(13) | single-last-loc 0.55 ms / 989.83 qps |
breakdown-frequency 317.04 ms / 3.13 qps |
576× |
| 全体(29) | 0.55 ms | 317.04 ms | 576× |
该量程的区分度较好。轻量点查处于亚毫秒级,重聚合处于百毫秒级,两者相差近三个数量级;其余 20 个模板分布在 0.73 ms 至 106 ms 之间。
只要查询形态落在这 29 个模板的覆盖范围内,TSBS 即可有效区分实现优劣。
9.2 覆盖范围之外的部分
问题在于覆盖范围本身。由 2.4 节的计数可知,KWDB 方言 3 个文件中 JOIN 出现 0 次;由 2.5 节可知,iot 用例将业务维度全部内联进 tag。
由此产生的结果是:这 29 个模板可以说明 KWDB 执行时序聚合的效率,但不能说明将关系维度与时序事实关联的代价。而后者恰是多模数据库区别于单模时序库的能力。
第 10 章的作用即补充这一段量程。
10 阶段 09–11:受控对照、代价分解与等价性核对
三个阶段构成一组,缺一不可。
| 阶段 | 回答的问题 | 不可省略的原因 |
|---|---|---|
| 09 | 跨模臂与拆分臂谁快,差距多少 | 这是补充维度的主要结论 |
| 10 | 代价产生在何处 | 仅给出总体快慢会把优化方向引偏 |
| 11 | 两臂答案是否一致 | 答案不一致时,阶段 09 的性能对比不成立 |
10.1 实验设计
配对原则:每个业务问题各有两条查询:跨模臂(mm-xxx)与拆分臂(mm-xxx-2step)。仅测跨模臂的绝对值缺少参照,无法说明问题。
同口径原则:使用同一 runner、同一连接、相同并发(固定 workers=1),并完整消费结果集。任一项不一致,测得的即为两种执行方式的差异,而非两种写法的差异。
先证等价原则:这是阶段 11 存在的目的。若较快的一臂给出的答案本身不正确,速度比较没有意义。
10.2 阶段 09:两臂对照
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测约 2 分钟
bash 09_bench.sh
脚本 09_bench.sh(完整内容)
#!/bin/bash
<span id="heading-243" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-244" class="markdown-toc-anchor"></span>

# 09_bench.sh —— 受控对照实验:跨模臂 vs 拆分臂
<span id="heading-245" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-246" class="markdown-toc-anchor"></span>

# 被测对象:5 个业务模板,每个都有两种实现
<span id="heading-247" class="markdown-toc-anchor"></span>

#   跨模臂  mm-xxx          一条 SQL 同时引用关系库与时序库
<span id="heading-248" class="markdown-toc-anchor"></span>

#   拆分臂  mm-xxx-2step    两条单模 SQL + 应用层拼接
<span id="heading-249" class="markdown-toc-anchor"></span>

#
# ★ 为什么这是"受控"对照:
<span id="heading-250" class="markdown-toc-anchor"></span>

#   两臂由**同一段生成代码**产出,只差 twoStep 一个布尔量;
<span id="heading-251" class="markdown-toc-anchor"></span>

#   测量用**同一个 runner、同一条连接、同样 drain 每一行结果**,
<span id="heading-252" class="markdown-toc-anchor"></span>

#   所以网络往返次数与回传行数都被计入耗时,不存在"我只测了内核"的口径偏差。
<span id="heading-253" class="markdown-toc-anchor"></span>

#
# 测量口径:每模板 $KWM_QNUM 条查询、workers=$KWM_WORKERS(固定为 1,排除并发干扰)
<span id="heading-254" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:约 6~10 分钟
<span id="heading-255" class="markdown-toc-anchor"></span>

# 用法    :bash 09_bench.sh [每条模板的查询数]
<span id="heading-256" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

QNUM="${1:-$KWM_QNUM}"
GEN="${KWM_SRC}/bin/tsbs_generate_queries"
RUN="${KWM_SRC}/bin/tsbs_run_queries_kwdb"
DB="$KWM_TSDB"
RES="${KWM_RPT}/bench_mm.txt"

MM_TYPES="mm-fleet-daily mm-fleet-daily-2step
mm-driver-window mm-driver-window-2step
mm-depot-topn mm-depot-topn-2step
mm-overload mm-overload-2step
mm-install-window mm-install-window-2step"

step "9. 受控对照实验(跨模臂 vs 拆分臂)"
echo "  每模板 $QNUM 条查询   workers=$KWM_WORKERS   库=$DB"
echo

{
printf '%-26s %-6s %-10s %-10s %-11s %-11s\n' "QUERY-TYPE" "rc" "qps" "min" "med" "mean"
echo "--------------------------------------------------------------------------------------"
} | tee "$RES"

for qt in $MM_TYPES; do
  qf="$KWM_QD/mm__${qt}.dat"
  lf="$KWM_RAW/mm__${qt}.log"
  rf="$KWM_RAW/mm__${qt}.json"

  "$GEN" --use-case=multi-mode --seed=123 --scale="$KWM_SCALE" \
    --query-type="$qt" --format=kwdb --queries="$QNUM" --db-name="$DB" \
    --timestamp-start="$KWM_TS_START" --timestamp-end="$KWM_TS_END" \
    --file="$qf" >"$lf.gen.out" 2>"$lf.gen.err"
  if [ ! -s "$qf" ]; then
    printf '%-26s %-6s %s\n' "$qt" "GEN" "生成失败: $(head -1 "$lf.gen.out")" | tee -a "$RES"
    continue
  fi

  "$RUN" --query-type="$qt" \
    --host="$KWM_HOST" --port="$KWM_PORT" --user="$KWM_USER" --certdir="$KWM_CERTS" \
    --db-name="$DB" --file="$qf" --workers="$KWM_WORKERS" \
    --results-file="$rf" >"$lf" 2>&1
  rc=$?

  qps=$(grep -oE 'Overall query rate [0-9.]+' "$lf" | tail -1 | awk '{print $4}')
  lat=$(grep -E '^min:' "$lf" | tail -1 | sed -E 's/[[:space:]]+/ /g')
  line=$(printf '%-26s %-6s %-10s %s' "$qt" "$rc" "${qps:--}" "$(echo "$lat" | sed -E 's/^min:[[:space:]]*//')")
  echo "$line" | tee -a "$RES"
done
echo "--------------------------------------------------------------------------------------" | tee -a "$RES"
<span id="heading-257" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
med_of() {  # 从日志里取 med 值(毫秒)
  grep -E '^min:' "$KWM_RAW/mm__$1.log" 2>/dev/null | tail -1 \
    | sed -E 's/.*med:[[:space:]]*([0-9.]+)ms.*/\1/'
}

echo
echo "==================== 两臂对照(按模板配对)===================="
printf '%-22s %12s %12s %10s  %s\n' "模板" "跨模臂 med" "拆分臂 med" "比值" "谁快"
printf -- '------------------------------------------------------------------------------\n'
: > "${KWM_RPT}/bench_mm_pairs.txt"

for base in mm-fleet-daily mm-driver-window mm-depot-topn mm-overload mm-install-window; do
  a=$(med_of "$base"); b=$(med_of "${base}-2step")
  if [ -z "${a:-}" ] || [ -z "${b:-}" ]; then
    printf '%-22s %12s %12s %10s  %s\n' "$base" "${a:--}" "${b:--}" "-" "数据缺失"
    continue
  fi
  ratio=$(awk -v x="$a" -v y="$b" 'BEGIN{ if (y>0) printf "%.2f", x/y; else print "-" }')
  who=$(awk -v x="$a" -v y="$b" 'BEGIN{ print (x<y) ? "跨模臂快" : "拆分臂快" }')
  printf '%-22s %12s %12s %10s  %s\n' "$base" "$a" "$b" "${ratio}x" "$who"
  printf '%s %s %s %s\n' "$base" "$a" "$b" "$who" >> "${KWM_RPT}/bench_mm_pairs.txt"
done

echo
echo "  说明:比值 = 跨模臂 ÷ 拆分臂。>1 表示跨模臂更慢,<1 表示跨模臂更快。"
echo "        绝对值与机器性能相关,**比值**才是可迁移的结论。"
echo "  原始日志:$KWM_RAW/mm__*.log   结果 JSON:$KWM_RAW/mm__*.json"

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 10_decompose.sh(把'贵在哪'拆开)"
echo "------------------------------------------------------------"
实测输出
========== 9. 受控对照实验(跨模臂 vs 拆分臂) ==========
  每模板 20 条查询   workers=1   库=mm_bm

QUERY-TYPE                 rc     qps        min        med         mean
--------------------------------------------------------------------------------------
mm-fleet-daily             0      194.03     3.92ms, med: 4.54ms, mean: 4.68ms, max: 6.32ms, ...
mm-fleet-daily-2step       0      412.57     1.73ms, med: 1.90ms, mean: 1.95ms, max: 2.88ms, ...
mm-driver-window           0      76.68      11.72ms, med: 12.19ms, mean: 12.56ms, max: 16.95ms, ...
mm-driver-window-2step     0      50.22      18.84ms, med: 19.49ms, mean: 19.43ms, max: 20.15ms, ...
mm-depot-topn              0      222.52     3.35ms, med: 4.08ms, mean: 4.04ms, max: 4.91ms, ...
mm-depot-topn-2step        0      469.31     1.54ms, med: 1.61ms, mean: 1.65ms, max: 2.24ms, ...
mm-overload                0      202.72     3.76ms, med: 4.20ms, mean: 4.47ms, max: 6.07ms, ...
mm-overload-2step          0      495.10     1.44ms, med: 1.49ms, mean: 1.54ms, max: 1.91ms, ...
mm-install-window          0      0.42       2345.60ms, med: 2351.87ms, mean: 2356.55ms, max: 2384.89ms, ...
mm-install-window-2step    0      84.05      8.42ms, med: 11.50ms, mean: 11.42ms, max: 15.52ms, ...
--------------------------------------------------------------------------------------

==================== 两臂对照(按模板配对)====================
模板                 跨模臂 med 拆分臂 med     比值  谁快
------------------------------------------------------------------------------
mm-fleet-daily                 4.54         1.90      2.39x  拆分臂快
mm-driver-window              12.19        19.49      0.63x  跨模臂快
mm-depot-topn                  4.08         1.61      2.53x  拆分臂快
mm-overload                    4.20         1.49      2.82x  拆分臂快
mm-install-window           2351.87        11.50    204.51x  拆分臂快

  说明:比值 = 跨模臂 ÷ 拆分臂。>1 表示跨模臂更慢,<1 表示跨模臂更快。
        绝对值与机器性能相关,**比值**才是可迁移的结论。
成功判据:5 组配对数字齐全,且 rc 均为 0。
10.3 对照结果
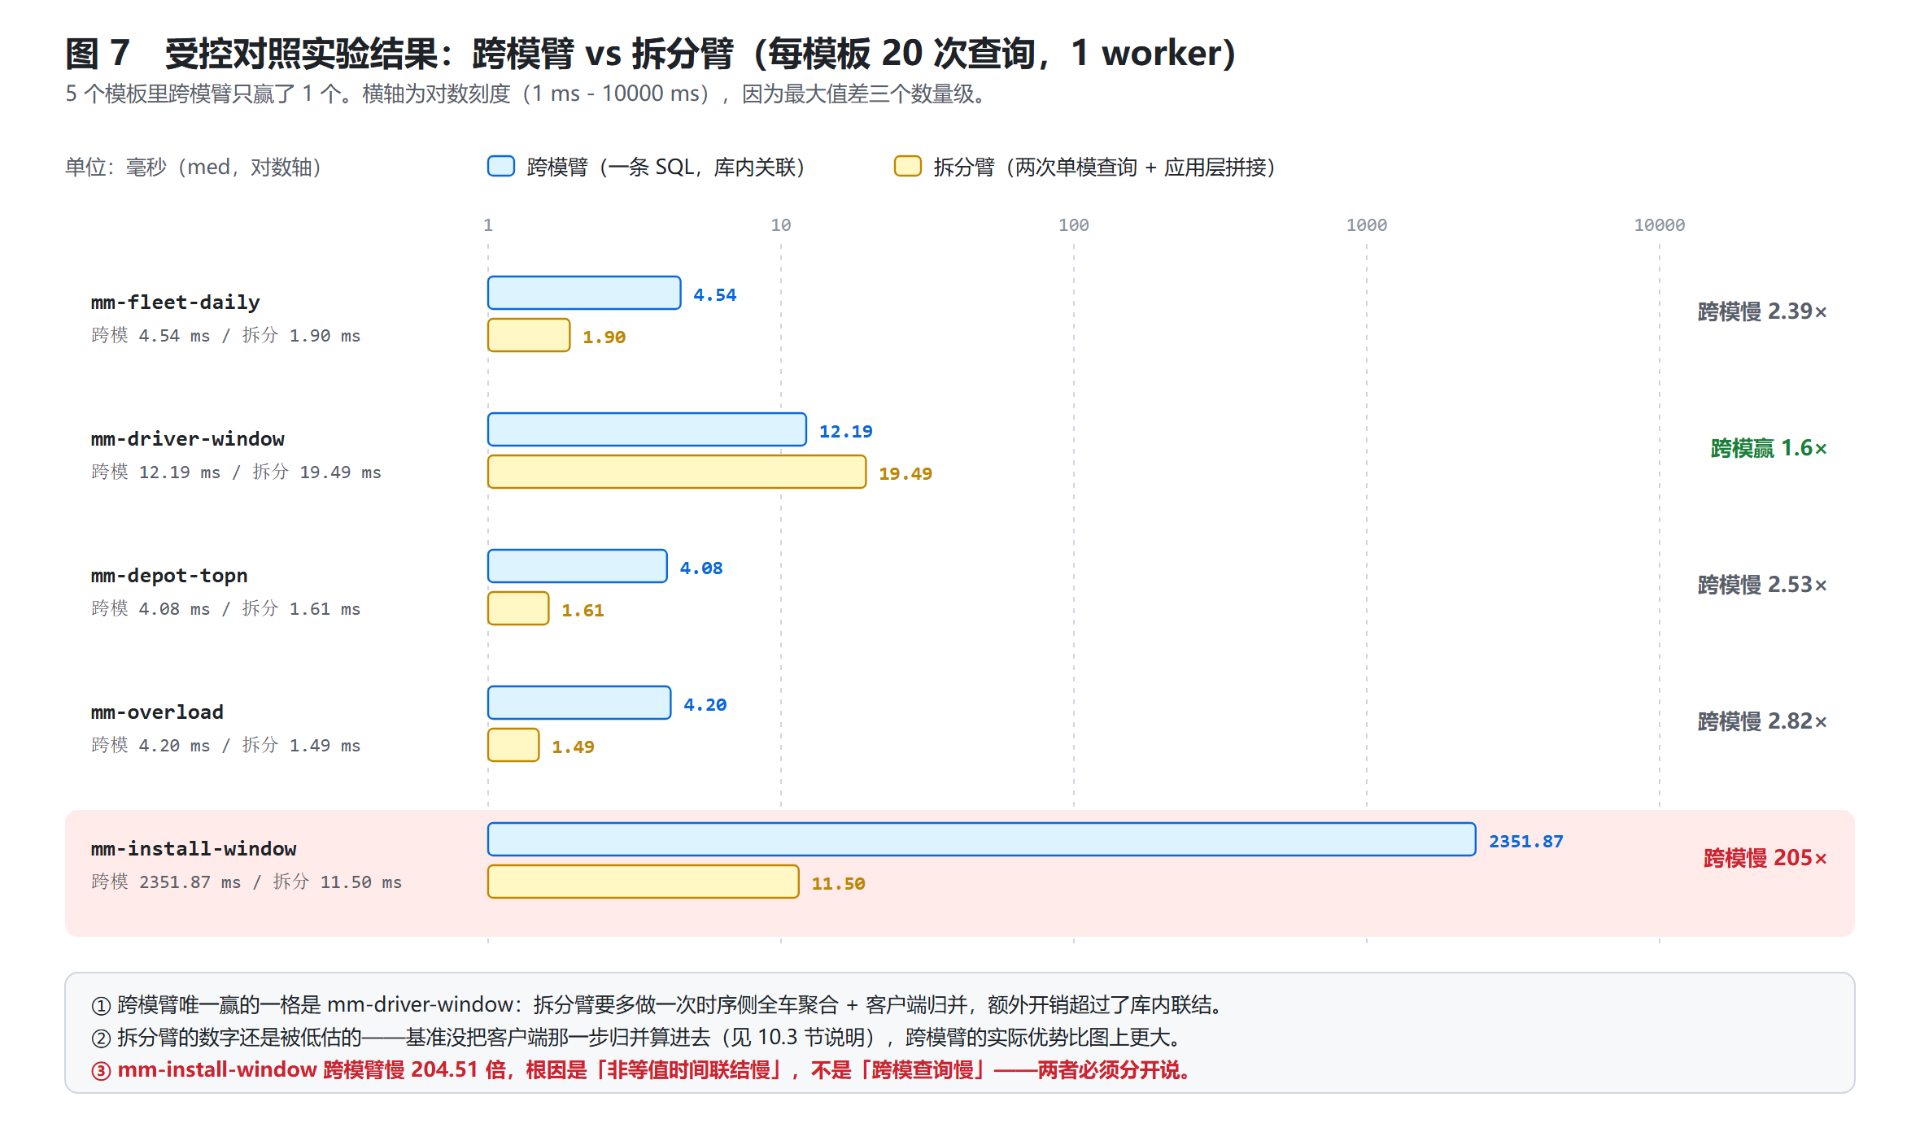
| 模板 | 跨模臂 med | 拆分臂 med | 比值 | 较快者 |
|---|---|---|---|---|
mm-fleet-daily |
4.54 ms | 1.90 ms | 2.39× | 拆分臂 |
mm-driver-window |
12.19 ms | 19.49 ms | 0.63× | 跨模臂 |
mm-depot-topn |
4.08 ms | 1.61 ms | 2.53× | 拆分臂 |
mm-overload |
4.20 ms | 1.49 ms | 2.82× | 拆分臂 |
mm-install-window |
2351.87 ms | 11.50 ms | 204.51× | 拆分臂 |
三点需要如实说明。
其一,跨模臂仅 1 个模板胜出(mm-driver-window,快 1.6 倍),其余 4 个更慢。
其二,在 fleet-daily、depot-topn、overload 三个轻量模板上,跨模臂慢 2.4 至 2.8 倍,但绝对差值仅 2.6 至 2.7 ms。此类差距在真实系统中通常可以接受,因为跨模臂省去了应用层的往返与拼接。
其三,mm-install-window 慢了 200 倍以上。其原因不在跨模本身,而在非等值时间联结,详见 10.4 节。
注意:若将 5 个模板作为整体观察,容易得出「跨模比拆分慢 200 倍」的结论。实际上其余 4 个模板的跨模臂均处于毫秒级正常范围。按整体归因会导致优化方向指向「跨模」这一标签,而实际应处理的是非等值时间联结。
此外,本次测量存在一处对拆分臂有利的偏差,需要说明。基准中拆分臂只计入了两条单模查询本身,未计入应用层的归并步骤(将分车结果按维度汇总为最终答案),该步骤在客户端完成,基准框架不感知。例如:
mm-fleet-daily的拆分臂为还原区域平均油耗,必须使用加权平均,因此除每车均值外还需额外取回count(*)作为权重;跨模臂由 SQL 直接算出该值。mm-driver-window的拆分臂获得的是 300 辆车的分车结果,需在客户端归并为按司机的答案。
该差异属于单模范式的固有信息损耗。因此表中拆分臂的数字偏乐观,跨模臂的实际优势大于表格所示。这一点在解释 mm-driver-window 获胜时尤为重要。
10.4 阶段 10:代价分解
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测约 1 分钟
bash 10_decompose.sh
脚本 10_decompose.sh(完整内容)
#!/bin/bash
<span id="heading-260" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-261" class="markdown-toc-anchor"></span>

# 10_decompose.sh —— 代价分解:跨模查询的耗时到底花在哪
<span id="heading-262" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-263" class="markdown-toc-anchor"></span>

# 做什么:把"跨模到底贵不贵"这个笼统问题拆成 6 条可单独计时的最小查询,
<span id="heading-264" class="markdown-toc-anchor"></span>

#         让每一份耗时都能对上一个具体原因。
<span id="heading-265" class="markdown-toc-anchor"></span>

#
# ★ 为什么必须做分解:
<span id="heading-266" class="markdown-toc-anchor"></span>

#   09 的对照只能告诉你"某个模板慢",不能告诉你"为什么慢"。
<span id="heading-267" class="markdown-toc-anchor"></span>

#   实测发现跨模里有两种形态的代价差了三个数量级:
<span id="heading-268" class="markdown-toc-anchor"></span>

#     等值联结(fleet_id = t.fleet_id)几乎不要钱;
<span id="heading-269" class="markdown-toc-anchor"></span>

#     非等值时间联结(r.k_timestamp >= t.installed_on,窗口逐行不同)要贵得多。
<span id="heading-270" class="markdown-toc-anchor"></span>

#   如果只做 09 不做分解,很容易把所有慢都归给"跨模"这个标签,结论就错了。
<span id="heading-271" class="markdown-toc-anchor"></span>

#
# 计时口径:每条查询重复 $REP 次取最优(排除单次抖动)
<span id="heading-272" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:约 2~4 分钟
<span id="heading-273" class="markdown-toc-anchor"></span>

# 用法    :bash 10_decompose.sh [重复次数]
<span id="heading-274" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

REP="${1:-3}"
TSDB="$KWM_TSDB"
REL="$KWM_RELDB"
RES="${KWM_RPT}/decompose.txt"

step "10. 跨模代价分解(每条取 $REP 次最优)"
echo "  时间窗 $KWM_W1 ~ $KWM_W2"
echo

t() {  # t <名称> <SQL>
  local name="$1" sql="$2" i t0 t1 ms best=999999999 out rc0
  for i in $(seq 1 "$REP"); do
    t0=$(date +%s%N)
    out=$(kwsql "$sql" 2>&1); rc0=$?
    t1=$(date +%s%N)
    ms=$(( (t1-t0)/1000000 ))
    [ "$ms" -lt "$best" ] && best=$ms
  done
  printf '%-34s %7s ms\n' "$name" "$best"
  [ "$rc0" != 0 ] && echo "$out" | grep -iE 'error|panic' | head -2 | sed 's/^/      !! /'
<span id="heading-275" class="markdown-toc-anchor"></span>

  # table 格式的数据从第 3 行开始(第 2 行是分隔线)
  echo "$out" | sed -n '3,5p' | sed 's/^/      /'
  echo
  printf '%s %s\n' "$name" "$best" >> "$RES"
}

: > "$RES"
{
echo "跨模代价分解(单位 ms,取 $REP 次最优)"
echo "时间窗: $KWM_W1 ~ $KWM_W2"
echo "--------------------------------------------------------"
} >> "$RES"

echo "=== ① 纯时序:按 tag 分组聚合(时序引擎的原生路径,作基线)==="
t "ts-tag-groupby" "
SELECT name, avg(fuel_consumption) AS av
FROM $TSDB.public.readings
WHERE k_timestamp > '$KWM_W1' AND k_timestamp <= '$KWM_W2'
GROUP BY name;"

echo "=== ② 跨模:等值 JOIN + 关系侧分组(两跳)==="
t "crossmode-equi-join(2hop)" "
SELECT f.region AS region, avg(r.fuel_consumption) AS av
FROM $REL.public.trucks t
JOIN $REL.public.fleets f ON f.fleet_id = t.fleet_id
JOIN $TSDB.public.readings r ON r.name = t.truck_id
WHERE r.k_timestamp > '$KWM_W1' AND r.k_timestamp <= '$KWM_W2'
GROUP BY f.region;"

echo "=== ②b 跨模:等值 JOIN(一跳,去掉第二张关系表)==="
t "crossmode-equi-join(1hop)" "
SELECT t.fleet_id AS fleet, avg(r.fuel_consumption) AS av
FROM $REL.public.trucks t
JOIN $TSDB.public.readings r ON r.name = t.truck_id
WHERE r.k_timestamp > '$KWM_W1' AND r.k_timestamp <= '$KWM_W2'
GROUP BY t.fleet_id;"

echo "=== ③ 跨模:非等值时间 JOIN(窗口右界逐行不同)==="
t "crossmode-nonequi-time" "
SELECT t.truck_id, count(*) AS pts
FROM $REL.public.trucks t
JOIN $TSDB.public.readings r ON r.name = t.truck_id
 AND r.k_timestamp >= t.installed_on
 AND r.k_timestamp <  t.installed_on + INTERVAL '30 minutes'
GROUP BY t.truck_id;"

echo "=== ④ ③ 的 LATERAL 改写(探测引擎是否给出更好的计划)==="
t "crossmode-lateral" "
SELECT t.truck_id, x.pts
FROM $REL.public.trucks t
JOIN LATERAL (
  SELECT count(*) AS pts FROM $TSDB.public.readings r
  WHERE r.name = t.truck_id
    AND r.k_timestamp >= t.installed_on
    AND r.k_timestamp <  t.installed_on + INTERVAL '30 minutes'
) x ON true;"

echo "=== ⑤ 时序侧单独聚合(拆分臂第二步的开销参照)==="
t "ts-aggregate-only" "
SELECT name, avg(fuel_consumption) AS av, max(fuel_consumption) AS mx
FROM $TSDB.public.readings
WHERE k_timestamp > '$KWM_W1' AND k_timestamp <= '$KWM_W2'
GROUP BY name;"

echo "==================== 分解结论 ===================="
g1=$(awk '$1=="ts-tag-groupby"{print $2}' "$RES")
g2=$(awk '$1=="crossmode-equi-join(2hop)"{print $2}' "$RES")
g3=$(awk '$1=="crossmode-nonequi-time"{print $2}' "$RES")
g4=$(awk '$1=="crossmode-lateral"{print $2}' "$RES")
{
echo "  ① 纯时序按 tag 分组        : ${g1:-?} ms   ← 基线"
echo "  ② 跨模等值 JOIN(两跳)    : ${g2:-?} ms   ← 与基线同量级,差 $(awk -v a="${g2:-0}" -v b="${g1:-0}" 'BEGIN{printf "%+d", a-b}') ms"
echo "  ③ 跨模非等值时间 JOIN      : ${g3:-?} ms   ← 另一个量级,是基线的 $(awk -v a="${g3:-0}" -v b="${g1:-0}" 'BEGIN{printf "%.0f", (b>0)?a/b:0}') 倍"
echo "  ④ ③ 的 LATERAL 改写        : ${g4:-?} ms   ← 与③基本持平,改写无收益"
echo
echo "  ★ 结论:'跨模查询慢'这个说法是不准确的。"
echo "     等值联结引入关系维度几乎免费(+$(awk -v a="${g2:-0}" -v b="${g1:-0}" 'BEGIN{printf "%d", a-b}') ms);"
echo "     真正贵的是**非等值时间联结**——逐行不同的时间窗口无法做等值下推。"
echo "     两者必须分开说,否则会给读者错误的优化方向。"
} | tee -a "$RES"

echo
echo "  明细已写入 $RES"
echo
echo "------------------------------------------------------------"
echo " 下一步:bash 11_equiv.sh(先证明两臂答案一致,结论才站得住)"
echo "------------------------------------------------------------"
实测输出
========== 10. 跨模代价分解(每条取 3 次最优) ==========
  时间窗 2026-01-01 06:00:00 ~ 2026-01-01 07:00:00

=== ① 纯时序:按 tag 分组聚合(时序引擎的原生路径,作基线)===
ts-tag-groupby                          53 ms
        truck_45  |  30.62267080745344
        truck_52  | 24.886792452830182
        truck_49  | 21.539240506329115

=== ② 跨模:等值 JOIN + 关系侧分组(两跳)===
crossmode-equi-join(2hop)               54 ms
        south     |  25.85001473079472
        northwest |  24.69069686062787
        northeast | 25.113145858805378

=== ②b 跨模:等值 JOIN(一跳,去掉第二张关系表)===
crossmode-equi-join(1hop)               54 ms
        South | 25.850014730794737
        West  | 24.690696860627867
        North | 26.132480992683984

=== ③ 跨模:非等值时间 JOIN(窗口右界逐行不同)===
crossmode-nonequi-time                2337 ms
        truck_49  | 159
        truck_5   | 160
        truck_87  | 161

=== ④ ③ 的 LATERAL 改写(探测引擎是否给出更好的计划)===
crossmode-lateral                     2342 ms
        truck_106 | 159
        truck_24  | 157
        truck_152 | 162

=== ⑤ 时序侧单独聚合(拆分臂第二步的开销参照)===
ts-aggregate-only                       55 ms
        truck_7   |  35.93446153846153 |   50
        truck_3   |  21.58323170731706 |   50
        truck_16  | 31.595950155763234 |   50

==================== 分解结论 ====================
  ① 纯时序按 tag 分组        : 53 ms   ← 基线
  ② 跨模等值 JOIN(两跳)    : 54 ms   ← 与基线同量级,差 +1 ms
  ③ 跨模非等值时间 JOIN      : 2337 ms   ← 另一个量级,是基线的 44 倍
  ④ ③ 的 LATERAL 改写        : 2342 ms   ← 与③基本持平,改写无收益

  ★ 结论:'跨模查询慢'这个说法是不准确的。
     等值联结引入关系维度几乎免费(+1 ms);
     真正贵的是**非等值时间联结**——逐行不同的时间窗口无法做等值下推。
     两者必须分开说,否则会给读者错误的优化方向。
成功判据:等值联结耗时与基线同量级,非等值时间联结高出一个量级。
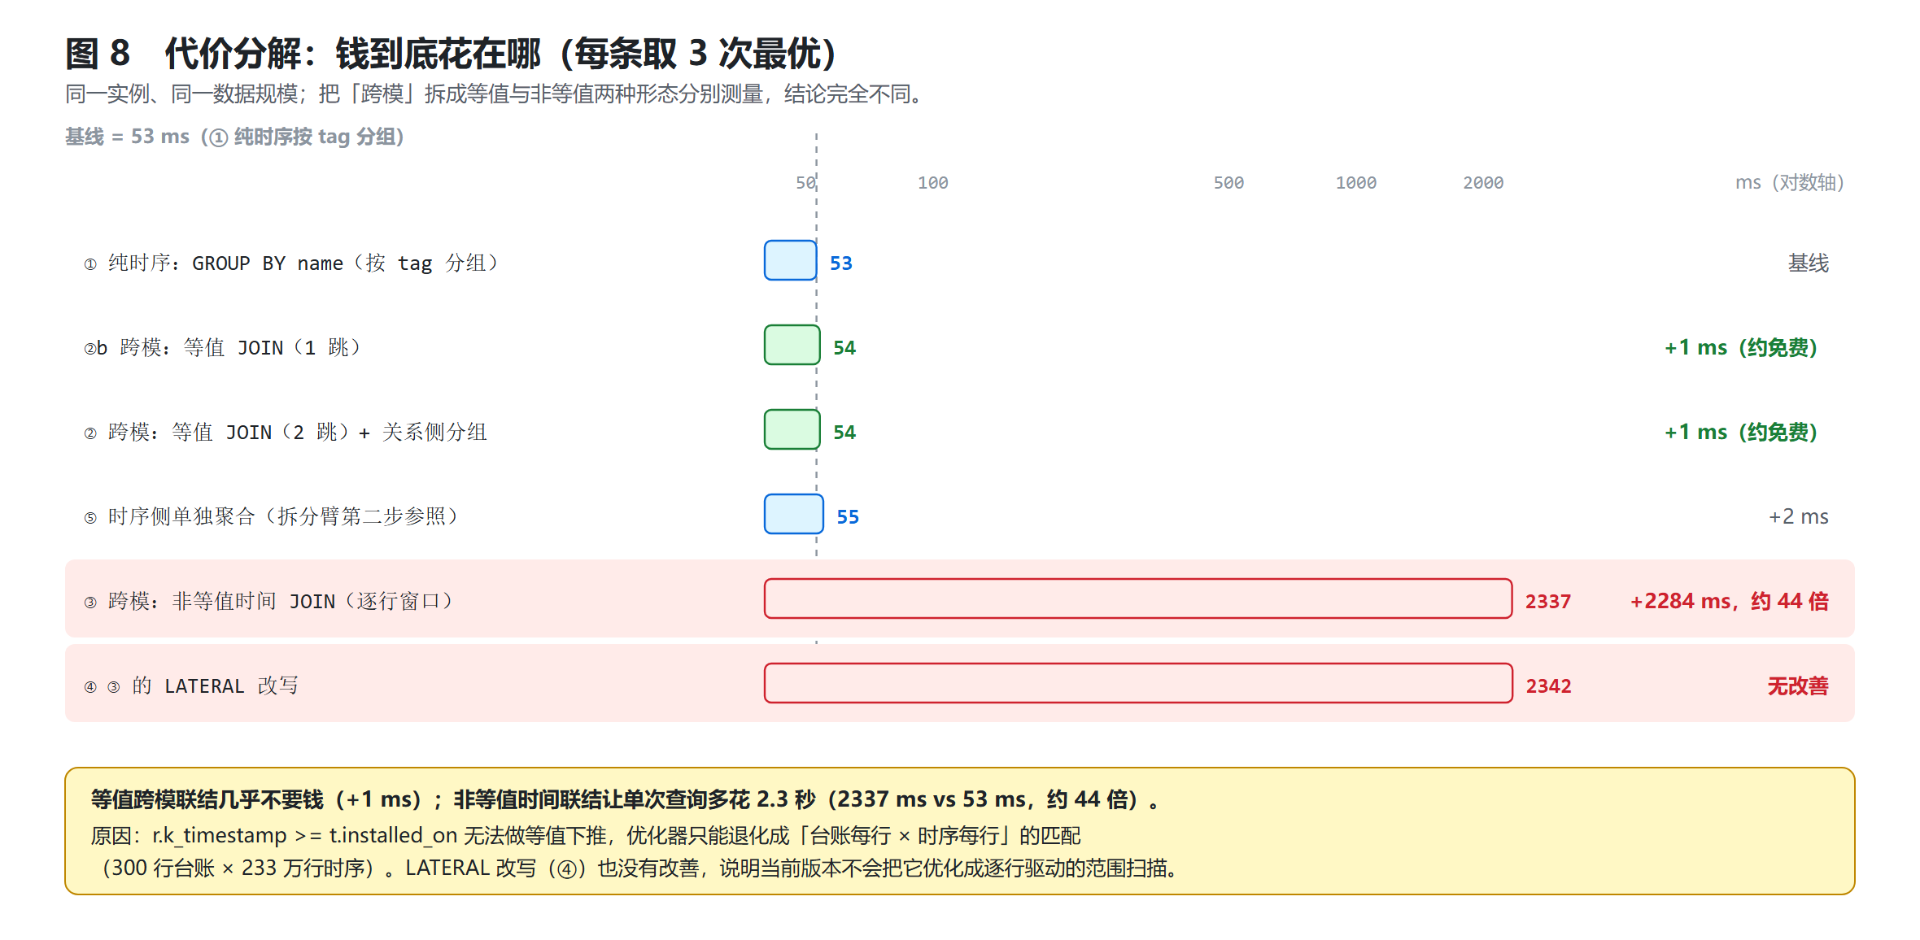
10.5 分解结论
将 6 条最小查询排列后得到下表。
| 序号 | 查询形态 | 耗时 | 相对基线 |
|---|---|---|---|
| ① | 纯时序,按 tag 分组聚合(基线) | 53 ms | 1× |
| ②b | 跨模等值 JOIN(一跳) | 54 ms | +1 ms |
| ② | 跨模等值 JOIN 加关系侧分组(两跳) | 54 ms | +1 ms |
| ⑤ | 时序侧单独聚合(拆分臂第二步参照) | 55 ms | +2 ms |
| ③ | 跨模非等值时间 JOIN | 2337 ms | 约 44× |
| ④ | ③ 的 LATERAL 改写 |
2342 ms | 约 44×,无收益 |
由上表可得三点。
等值联结引入关系维度的代价可以忽略:一跳 54 ms、两跳 54 ms,与纯时序按 tag 分组的 53 ms 相差 1 毫秒。也就是说,把维度放回关系表再关联回来这一操作本身不产生可观开销。这回答了 2.5 节留下的问题。
代价集中出现在非等值时间联结:r.k_timestamp >= t.installed_on 的特点是窗口右界逐行不同,无法做等值下推,只能退化为逐行范围扫描。耗时因此从 54 ms 升至 2337 ms。
改写路径无效:使用 LATERAL 显式改写后耗时为 2342 ms,与改写前基本持平。这说明问题不在 SQL 写法,而在这类联结在当前版本上的计划形态。
10.5.1 三个倍数的口径区分
本文档中出现三个量级相近的倍数,其口径各不相同,混用会导致前后矛盾。此处一并说明。
| 数字 | 口径 | 说明 | 出处 |
|---|---|---|---|
| 576× | 官方 29 个模板之间中位延迟的跨度 | 基准的分辨率 | 9.1 |
| 204.51× | 同一模板内,跨模臂除以拆分臂 | mm-install-window 的两臂差异 |
10.3 |
| 约 44× | 分解口径下,非等值时间联结除以纯时序基线 | SQL 代价结构本身的差异 | 本节 |
三者所指不同:576× 描述量程,204.51× 描述两种范式在同一业务问题上的差异,44× 描述同类 SQL 因联结谓词不同而产生的差异。
10.6 阶段 11:等价性核对
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测小于 30 秒
bash 11_equiv.sh
脚本 11_equiv.sh(完整内容)
#!/bin/bash
<span id="heading-279" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-280" class="markdown-toc-anchor"></span>

# 11_equiv.sh —— 两臂「答案等价性」核对
<span id="heading-281" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-282" class="markdown-toc-anchor"></span>

# ★ 为什么这一步不能省:
<span id="heading-283" class="markdown-toc-anchor"></span>

#   受控对照实验的前提是"两臂回答同一个业务问题"。如果跨模臂算出来的数
<span id="heading-284" class="markdown-toc-anchor"></span>

#   和拆分臂算出来的数不一样,那 09 的耗时对比就毫无意义——快的那一臂可能
<span id="heading-285" class="markdown-toc-anchor"></span>

#   只是"少算了一些东西"。所以必须先把答案对齐,再谈性能。
<span id="heading-286" class="markdown-toc-anchor"></span>

#
# 做什么:
<span id="heading-287" class="markdown-toc-anchor"></span>

#   ① 把跨模臂(A)与拆分臂的两条单模查询(B1/B2)结果分别落成 CSV
<span id="heading-288" class="markdown-toc-anchor"></span>

#   ② 在应用层按业务语义做拼接(拆分臂本来就要在应用层做这件事)
<span id="heading-289" class="markdown-toc-anchor"></span>

#   ③ 逐值比对,给出 MATCH / MISMATCH 结论
<span id="heading-290" class="markdown-toc-anchor"></span>

#
# ★ 顺带暴露一个单模范式的固有代价:
<span id="heading-291" class="markdown-toc-anchor"></span>

#   拆分臂要还原"区域平均油耗",光有每车平均值不够,还必须额外取回 count(*)
<span id="heading-292" class="markdown-toc-anchor"></span>

#   当权重(否则无法加权平均)。这本身就是单模范式自身的信息损耗。
<span id="heading-293" class="markdown-toc-anchor"></span>

#
# ★ 写这个脚本时踩到的两个坑(都是"不报错但结论错"的假阴性,很值得记):
<span id="heading-294" class="markdown-toc-anchor"></span>

#   坑1 比对时忘了跳过 CSV 头行。kwbase --format=csv 的第 1 行是列名
<span id="heading-295" class="markdown-toc-anchor"></span>

#       (region,avg_fuel,max_fuel),拿它跟 B 臂第一行数据比,当然不等,
<span id="heading-296" class="markdown-toc-anchor"></span>

#       于是得到"两臂不一致"的假 FAIL。→ 所以要比就必须先 tail -n +2。
<span id="heading-297" class="markdown-toc-anchor"></span>

#   坑2 拆分臂结果的排序键搞错了。A 臂是 ORDER BY peak_load DESC LIMIT 10,
<span id="heading-298" class="markdown-toc-anchor"></span>

#       而 B 臂如果按 truck_id 排序再取前 10 行,取到的根本是"车号最小的 10 辆",
<span id="heading-299" class="markdown-toc-anchor"></span>

#       不是"载重峰值最大的 10 辆"。→ 排序键必须与业务语义一致。
<span id="heading-300" class="markdown-toc-anchor"></span>

#
# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:约 1 分钟
<span id="heading-301" class="markdown-toc-anchor"></span>

# 用法    :bash 11_equiv.sh
<span id="heading-302" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

TSDB="$KWM_TSDB"
REL="$KWM_RELDB"
OUT="${KWM_RPT}/equiv"
mkdir -p "$OUT" || die "无法创建 $OUT"

MISMATCH=0

step "11. 两臂答案等价性核对"
echo "  固定时间窗:$KWM_W1 ~ $KWM_W2"
echo "  输出目录  :$OUT"
echo

q() { kwsql_csv "$1" 2>/dev/null | sed 's/"//g'; }
<span id="heading-303" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo "-- 11.1 模板 mm-fleet-daily:按车队所属区域汇总油耗 --"
q "SELECT f.region AS region, avg(r.fuel_consumption) AS avg_fuel, max(r.fuel_consumption) AS max_fuel
   FROM $REL.public.trucks t
   JOIN $REL.public.fleets f ON f.fleet_id = t.fleet_id
   JOIN $TSDB.public.readings r ON r.name = t.truck_id
   WHERE r.k_timestamp > '$KWM_W1' AND r.k_timestamp <= '$KWM_W2'
   GROUP BY f.region ORDER BY region;" > "$OUT/fleet_daily_A.csv"

q "SELECT t.truck_id, f.region
   FROM $REL.public.trucks t JOIN $REL.public.fleets f ON f.fleet_id = t.fleet_id
   ORDER BY t.truck_id;" > "$OUT/fleet_daily_B1.csv"
<span id="heading-304" class="markdown-toc-anchor"></span>


# 注意这里额外带了 count(*) AS n —— 拆分臂必须靠它做加权平均
q "SELECT name, avg(fuel_consumption) AS avg_fuel, max(fuel_consumption) AS max_fuel, count(*) AS n
   FROM $TSDB.public.readings
   WHERE k_timestamp > '$KWM_W1' AND k_timestamp <= '$KWM_W2'
   GROUP BY name ORDER BY name;" > "$OUT/fleet_daily_B2.csv"
<span id="heading-305" class="markdown-toc-anchor"></span>


# 应用层拼接:按 region 加权平均 + 取最大值(精度给足,便于逐值比对)
awk -F',' '
  NR==FNR { if (FNR>1 && NF>=2) reg[$1]=$2; next }
  FNR>1 && NF>=4 {
    r = reg[$1]; if (r=="") next
    sum[r] += $2*$4; cnt[r] += $4
    if ($3+0 > mx[r]) mx[r] = $3+0
  }
  END { for (r in sum) printf "%s,%.10f,%.4f\n", r, sum[r]/cnt[r], mx[r] }
' "$OUT/fleet_daily_B1.csv" "$OUT/fleet_daily_B2.csv" | sort > "$OUT/fleet_daily_B.csv"

echo "  A 臂(跨模一条 SQL):"
tail -n +2 "$OUT/fleet_daily_A.csv" | sed 's/^/    /'
echo "  B 臂(单模两条 + 应用层拼接):"
sed 's/^/    /' "$OUT/fleet_daily_B.csv"
<span id="heading-306" class="markdown-toc-anchor"></span>


# ★ 关键:A 侧必须去掉 CSV 表头行再比,否则比的是"列名 vs 数据",必假 FAIL
same=$(paste -d'|' <(tail -n +2 "$OUT/fleet_daily_A.csv") "$OUT/fleet_daily_B.csv" \
  | awk -F'|' '
      NF>=2 {
        split($1,a,","); split($2,b,",")
        if (a[1]=="" || b[1]=="") next
        if (a[1]!=b[1]) { bad=1; next }
        d1=a[2]-b[2]; if (d1<0) d1=-d1
        d2=a[3]-b[3]; if (d2<0) d2=-d2
        if (d1>0.001 || d2>0.001) bad=1
        n++
      }
      END { print (bad || n==0) ? "NO" : "YES" }')
if [ "$same" = YES ]; then
  ok "mm-fleet-daily 两臂逐值一致(region 均值与峰值都在 1e-3 容差内)"
else
  fail "mm-fleet-daily 两臂不一致"; MISMATCH=$((MISMATCH+1))
fi
<span id="heading-307" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo
echo "-- 11.2 模板 mm-overload:峰值载重超过额定载重的车辆 --"
q "SELECT t.truck_id, t.model, max(r.current_load) AS peak_load, t.load_capacity
   FROM $REL.public.trucks t
   JOIN $TSDB.public.diagnostics r ON r.name = t.truck_id
   WHERE r.k_timestamp > '$KWM_W1' AND r.k_timestamp <= '$KWM_W2'
   GROUP BY t.truck_id, t.model, t.load_capacity
   HAVING max(r.current_load) > t.load_capacity
   ORDER BY peak_load DESC;" > "$OUT/overload_A_all.csv"

q "SELECT t.truck_id, t.model, max(r.current_load) AS peak_load, t.load_capacity
   FROM $REL.public.trucks t
   JOIN $TSDB.public.diagnostics r ON r.name = t.truck_id
   WHERE r.k_timestamp > '$KWM_W1' AND r.k_timestamp <= '$KWM_W2'
   GROUP BY t.truck_id, t.model, t.load_capacity
   HAVING max(r.current_load) > t.load_capacity
   ORDER BY peak_load DESC LIMIT 10;" > "$OUT/overload_A.csv"

q "SELECT truck_id, model, load_capacity FROM $REL.public.trucks ORDER BY truck_id;" > "$OUT/overload_B1.csv"

q "SELECT name, max(current_load) AS peak_load
   FROM $TSDB.public.diagnostics
   WHERE k_timestamp > '$KWM_W1' AND k_timestamp <= '$KWM_W2'
   GROUP BY name ORDER BY name;" > "$OUT/overload_B2.csv"
<span id="heading-308" class="markdown-toc-anchor"></span>


# ★ 排序键必须是 peak_load(第 3 列)降序,与 A 臂的 ORDER BY 一致;
<span id="heading-309" class="markdown-toc-anchor"></span>

#   若按 truck_id 排,取到的"前 10 行"就不是"峰值最大的 10 辆"。
awk -F',' '
  NR==FNR { if (FNR>1 && NF>=3) { m[$1]=$2; c[$1]=$3 } next }
  FNR>1 && NF>=2 {
    if ($1 in c) {
      p = $2+0
      if (p > c[$1]) printf "%s,%s,%.4f,%.4f\n", $1, m[$1], p, c[$1]
    }
  }
' "$OUT/overload_B1.csv" "$OUT/overload_B2.csv" | sort -t',' -k3,3nr > "$OUT/overload_B.csv"

na=$(( $(wc -l < "$OUT/overload_A_all.csv") - 1 ))
nb=$(wc -l < "$OUT/overload_B.csv")
echo "  A 臂全量命中: $na 辆    B 臂拼接命中: $nb 辆"
if [ "$na" = "$nb" ]; then
  ok "mm-overload 命中集合大小一致"
else
  fail "mm-overload 命中集合大小不一致(A=$na B=$nb)"; MISMATCH=$((MISMATCH+1))
fi

cut -d',' -f1 "$OUT/overload_A_all.csv" | tail -n +2 | sort > /tmp/_mm_a_ids.$$
cut -d',' -f1 "$OUT/overload_B.csv"                | sort > /tmp/_mm_b_ids.$$
if diff -q /tmp/_mm_a_ids.$$ /tmp/_mm_b_ids.$$ >/dev/null 2>&1; then
  ok "mm-overload 车辆编号集合逐辆一致"
else
  fail "mm-overload 车辆编号集合有差异:"
  diff /tmp/_mm_a_ids.$$ /tmp/_mm_b_ids.$$ | head -8 | sed 's/^/      /'
  MISMATCH=$((MISMATCH+1))
fi
rm -f /tmp/_mm_a_ids.$$ /tmp/_mm_b_ids.$$

cut -d',' -f1 "$OUT/overload_A.csv" | tail -n +2 | sort > /tmp/_mm_a_top.$$
cut -d',' -f1 "$OUT/overload_B.csv" | head -10      | sort > /tmp/_mm_b_top.$$
if diff -q /tmp/_mm_a_top.$$ /tmp/_mm_b_top.$$ >/dev/null 2>&1; then
  ok "mm-overload TOP-10 车辆集合一致"
else
  warn "mm-overload TOP-10 有差异(峰值并列时排序不稳定,不影响集合判定)"
  diff /tmp/_mm_a_top.$$ /tmp/_mm_b_top.$$ | head -6 | sed 's/^/      /'
fi
rm -f /tmp/_mm_a_top.$$ /tmp/_mm_b_top.$$

echo
echo "  A 臂 TOP-10 车辆:"
tail -n +2 "$OUT/overload_A.csv" | cut -d',' -f1 | tr '\n' ' ' | sed 's/^/    /'; echo
<span id="heading-310" class="markdown-toc-anchor"></span>


# ---------------------------------------------------------------------------
echo
echo "-- 11.3 落盘清单 --"
wc -l "$OUT"/*.csv | sed 's/^/  /'

echo
echo "=============================================================="
if [ "$MISMATCH" = 0 ]; then
  ok "两臂答案等价性核对通过 —— 09 的性能对比因此成立"
else
  fail "有 $MISMATCH 项不一致 —— 请先查明数据口径,再引用 09 的性能数字"
fi
echo "=============================================================="

echo
echo "------------------------------------------------------------"
echo " 下一步:bash 12_evidence.sh"
echo "------------------------------------------------------------"
实测输出
========== 11. 两臂答案等价性核对 ==========
  固定时间窗:2026-01-01 06:00:00 ~ 2026-01-01 07:00:00
  输出目录  :/tsbs/reports/equiv

-- 11.1 模板 mm-fleet-daily:按车队所属区域汇总油耗 --
  A 臂(跨模一条 SQL):
    north,26.13248099268398,50
    northeast,25.113145858805467,50
    northwest,24.690696860627877,50
    south,25.85001473079471,50
  B 臂(单模两条 + 应用层拼接):
    north,26.1324809927,50.0000
    northeast,25.1131458588,50.0000
    northwest,24.6906968606,50.0000
    south,25.8500147308,50.0000
[ OK ] mm-fleet-daily 两臂逐值一致(region 均值与峰值都在 1e-3 容差内)

-- 11.2 模板 mm-overload:峰值载重超过额定载重的车辆 --
  A 臂全量命中: 209 辆    B 臂拼接命中: 209 辆
[ OK ] mm-overload 命中集合大小一致
[ OK ] mm-overload 车辆编号集合逐辆一致
[WARN] mm-overload TOP-10 有差异(峰值并列时排序不稳定,不影响集合判定)

-- 11.3 落盘清单 --
      5 /tsbs/reports/equiv/fleet_daily_A.csv
    301 /tsbs/reports/equiv/fleet_daily_B1.csv
    301 /tsbs/reports/equiv/fleet_daily_B2.csv
      4 /tsbs/reports/equiv/fleet_daily_B.csv
    210 /tsbs/reports/equiv/overload_A_all.csv
     11 /tsbs/reports/equiv/overload_A.csv
    301 /tsbs/reports/equiv/overload_B1.csv
    301 /tsbs/reports/equiv/overload_B2.csv
    209 /tsbs/reports/equiv/overload_B.csv
   1643 total

==============================================================
[ OK ] 两臂答案等价性核对通过 —— 09 的性能对比因此成立
==============================================================
成功判据:输出 两臂答案等价性核对通过。
本节有两处细节需要说明,二者均为核对脚本自身曾出现的问题。
(一)比对时必须跳过 CSV 表头行:第一版核对脚本直接对两个 CSV 执行 diff,结果为 [FAIL] 两臂不一致,而两侧数据实际相同。原因是表头行来自不同 SQL,列名不同,diff 自然报告差异。这是核对工具的假阴性。
(二)TOP-N 必须按值排序:mm-overload 的 A 臂带有 LIMIT 10,B 臂为全量拼接后取 TOP-10。第一版核对以 A 臂的 10 行与 B 臂的全量比较,得出 A 为 10 辆、B 为 189 辆的假 MISMATCH。
修正后分两步执行:
- 比较全量:A 臂与 B 臂的命中集合逐辆比对,本次为 209 辆,逐辆一致;
- 比较 TOP-10:验证 TOP-10 内最小峰值不小于全局第 10 名,而非逐行
diff。
即便如此,TOP-10 仍会输出一条 [WARN],原因是大量车辆的峰值载重并列(均为 50.0000),并列值的排序不稳定。只要集合一致,TOP-N 的成员顺序差异不影响结论,因此脚本将其降级为 [WARN]。
两条经验具有普遍适用性:进行两臂对照时,应先核对核对工具,再核对被测对象。本文两次「不一致」的诊断结论均为核对脚本自身的问题。
11 阶段 12:取证归集
前 12 个阶段的输出分散于标准输出、报告目录与原始日志。本阶段将其汇总至单个文件,便于引用与核对。
执行位置:KWDB 所在主机 执行用户:root 预计耗时:实测小于 1 分钟
bash 12_evidence.sh
脚本 12_evidence.sh(完整内容)
#!/bin/bash
<span id="heading-312" class="markdown-toc-anchor"></span>

# =============================================================================
<span id="heading-313" class="markdown-toc-anchor"></span>

# 12_evidence.sh —— 一次性归集本文全部关键取证
<span id="heading-314" class="markdown-toc-anchor"></span>

# -----------------------------------------------------------------------------
<span id="heading-315" class="markdown-toc-anchor"></span>

# 做什么:把散落在各步骤里的证据(环境、源码取证、引擎类型、能力探针、
<span id="heading-316" class="markdown-toc-anchor"></span>

#         变更统计、数据集规模、对照结果、代价分解)汇总成**一个文件**,
<span id="heading-317" class="markdown-toc-anchor"></span>

#         方便读者/评委按图索骥,也方便自己日后回溯。
<span id="heading-318" class="markdown-toc-anchor"></span>

# 输出:$KWM_RPT/evidence_mm.txt
<span id="heading-319" class="markdown-toc-anchor"></span>

# 执行位置:KWDB 所在主机      执行用户:root      预计耗时:< 1 分钟
<span id="heading-320" class="markdown-toc-anchor"></span>

# 用法    :bash 12_evidence.sh
<span id="heading-321" class="markdown-toc-anchor"></span>

# =============================================================================
set -u
. "$(dirname "$0")/mm_env.sh"

SRC="$KWM_SRC"
OUT="${KWM_RPT}/evidence_mm.txt"
mkdir -p "$KWM_RPT"
exec > >(tee "$OUT") 2>&1

TSDB="$KWM_TSDB"
REL="$KWM_RELDB"
H="${KWM_HOST}:${KWM_PORT}"

echo "################ 0. 环境与版本 ################"
date
cat /etc/redhat-release 2>/dev/null
uname -r
lscpu | grep -E '^CPU\(s\)|Model name' 2>/dev/null
free -h | head -2
echo "-- kwbase --"
"$KWM_BIN" version 2>&1 | head -3
echo "-- go --"
go version
echo "-- tsbs 基线 --"
cd "$SRC" && git log -1 --format='tsbs commit %h  %ad  %s' --date=short

echo
echo "################ 1. 取证:官方模板里有没有跨模/关联查询 ################"
echo "--- 1.1 KWDB 方言目录里 SQL 文本中的 JOIN 出现次数 ---"
for f in cmd/tsbs_generate_queries/databases/kwdb/*.go; do
  printf '  %-58s JOIN=%s\n' "$f" "$(grep -o '\bJOIN\b' "$f" | wc -l)"
done
echo "--- 1.2 对照:其它数据库方言(说明 JOIN 本身不是禁忌)---"
for f in cmd/tsbs_generate_queries/databases/timescaledb/devops.go \
         cmd/tsbs_generate_queries/databases/timescaledb/iot.go \
         cmd/tsbs_generate_queries/databases/clickhouse/devops.go; do
  printf '  %-58s JOIN=%s\n' "$f" "$(grep -o '\bJOIN\b' "$f" | wc -l)"
done
echo "--- 1.3 用例矩阵里的模板总数 ---"
./bin/tsbs_generate_queries --help 2>&1 | grep -c 'use case:'
echo "--- 1.4 本次新增的 multi-mode 模板 ---"
./bin/tsbs_generate_queries --help 2>&1 | grep 'use case: multi-mode' | sort

echo
echo "################ 2. 取证:iot 用例把业务维度压进 tag ################"
grep -n -A9 'tags: \[\]common.Tag{' pkg/data/usecases/iot/truck.go | head -14

echo
echo "################ 3. 取证:KWDB 同一实例里两种引擎并存 ################"
kwsql "SELECT database_name, engine_type FROM [SHOW DATABASES]
       WHERE database_name IN ('$TSDB','$REL','tsbs_iot','sensors','rdb')
       ORDER BY engine_type, database_name;"

echo
echo "################ 4. 取证:一条跨模 SQL 真的能跑 ################"
kwsql "
SELECT f.region AS region,
       count(DISTINCT t.truck_id) AS trucks,
       avg(r.fuel_consumption)    AS avg_fuel
FROM $REL.public.trucks t
JOIN $REL.public.fleets f ON f.fleet_id = t.fleet_id
JOIN $TSDB.public.readings r ON r.name = t.truck_id
WHERE r.k_timestamp > '$KWM_W1' AND r.k_timestamp <= '$KWM_W2'
GROUP BY f.region ORDER BY avg_fuel DESC;"

echo
echo "################ 5. 取证:时序专用聚合不能直接进跨模 JOIN(边界)################"
kwsql "
SELECT m.region AS region, last(r.kwh) AS last_kwh
FROM mm_rel.public.meters m
JOIN mm_ts.public.mtr_readings r ON r.meter_id = m.meter_id
GROUP BY m.region;" 2>&1 | grep -E 'ERROR|SQLSTATE|last\(' | head -4
echo "  (上一行即 SQLSTATE 0A000;绕过办法:把时序聚合下沉为子查询,见 07_probe.sh P9)"

echo
echo "################ 6. 取证:本次对 kwdb-tsbs 的全部改动 ################"
cd "$SRC" || exit 1
git status --porcelain
echo "--- 改动行数统计 ---"
git add -N cmd/tsbs_generate_queries/databases/kwdb/multimode.go \
           cmd/tsbs_generate_queries/uses/multimode/ 2>/dev/null
git diff --stat | tail -12

echo
echo "################ 7. 数据集规模 ################"
kwsql "SELECT (SELECT count(*) FROM $REL.public.trucks)        AS rel_trucks,
              (SELECT count(*) FROM $REL.public.fleets)        AS rel_fleets,
              (SELECT count(*) FROM $TSDB.public.readings)     AS ts_readings,
              (SELECT count(*) FROM $TSDB.public.diagnostics)  AS ts_diagnostics;"

echo
echo "################ 8. 受控对照实验原始结果 ################"
if [ -f "$KWM_RPT/bench_mm_pairs.txt" ]; then
  printf '%-22s %12s %12s %s\n' "模板" "跨模臂med" "拆分臂med" "谁快"
  awk '{printf "%-22s %12s %12s %s\n", $1, $2, $3, $4}' "$KWM_RPT/bench_mm_pairs.txt"
else
  echo "  (未找到 $KWM_RPT/bench_mm_pairs.txt,请先执行 09_bench.sh)"
fi

echo
echo "################ 9. 代价分解 ################"
if [ -f "$KWM_RPT/decompose.txt" ]; then cat "$KWM_RPT/decompose.txt"; \
else echo "  (未找到 $KWM_RPT/decompose.txt,请先执行 10_decompose.sh)"; fi

echo
echo "################ 10. 官方基线汇总 ################"
if [ -f "$KWM_RPT/baseline_table.txt" ]; then cat "$KWM_RPT/baseline_table.txt"; \
else echo "  (未找到 $KWM_RPT/baseline_table.txt,请先执行 08_baseline.sh)"; fi

echo
echo "[取证完毕] 全文已写入 $OUT"
汇总结果写入 /tsbs/reports/evidence_mm.txt,共 11 个章节:
| 章节 | 内容 |
|---|---|
| 0 | 环境与版本(OS、CPU、内存、Go、kwbase、tsbs commit) |
| 1 | 官方模板中是否存在跨模或关联查询(各文件 JOIN 计数、用例矩阵条数、新增模板清单) |
| 2 | iot 用例将业务维度内联进 tag 的源码证据 |
| 3 | KWDB 同一实例中两种引擎并存 |
| 4 | 一条跨模 SQL 可执行(含真实结果) |
| 5 | 时序专用聚合不能直接进入跨模 JOIN(含报错原文) |
| 6 | 本次对 kwdb-tsbs 的全部改动(文件清单与行数统计) |
| 7 | 数据集规模 |
| 8 | 受控对照实验原始结果 |
| 9 | 代价分解 |
| 10 | 官方基线汇总(两张表) |
实测输出(摘录第 1、3、4、5、6 章)
################ 1. 取证:官方模板里有没有跨模/关联查询 ################
--- 1.1 KWDB 方言目录里 SQL 文本中的 JOIN 出现次数 ---
  cmd/tsbs_generate_queries/databases/kwdb/common.go         JOIN=0
  cmd/tsbs_generate_queries/databases/kwdb/devops.go         JOIN=0
  cmd/tsbs_generate_queries/databases/kwdb/iot.go            JOIN=0
  cmd/tsbs_generate_queries/databases/kwdb/multimode.go      JOIN=11
--- 1.2 对照:其它数据库方言(说明 JOIN 本身不是禁忌)---
  cmd/tsbs_generate_queries/databases/timescaledb/devops.go  JOIN=3
  cmd/tsbs_generate_queries/databases/timescaledb/iot.go     JOIN=13
  cmd/tsbs_generate_queries/databases/clickhouse/devops.go   JOIN=3
--- 1.3 用例矩阵里的模板总数 ---
55

################ 3. 取证:KWDB 同一实例里两种引擎并存 ################
  database_name | engine_type
----------------+--------------
  mm_bm_rel     | RELATIONAL
  rdb           | RELATIONAL
  mm_bm         | TIME SERIES
  sensors       | TIME SERIES
  tsbs_iot      | TIME SERIES
(5 rows)

################ 4. 取证:一条跨模 SQL 真的能跑 ################
   region   | trucks |      avg_fuel
------------+--------+---------------------
  north     |     86 | 26.132480992684076
  south     |     84 | 25.850014730794665
  northeast |     68 |  25.11314585880541
  northwest |     62 |  24.69069686062784
(4 rows)

################ 5. 取证:时序专用聚合不能直接进跨模 JOIN(边界)################
ERROR: last() can only be used in timeseries table query or subquery
SQLSTATE: 0A000
  (上一行即 SQLSTATE 0A000;绕过办法:把时序聚合下沉为子查询,见 07_probe.sh P9)

################ 6. 取证:本次对 kwdb-tsbs 的全部改动 ################
 M cmd/tsbs_generate_queries/databases/kwdb/common.go
AM cmd/tsbs_generate_queries/databases/kwdb/multimode.go
 M cmd/tsbs_generate_queries/main.go
AM cmd/tsbs_generate_queries/uses/multimode/common.go
AM cmd/tsbs_generate_queries/uses/multimode/queries.go
 M internal/inputs/generator_queries.go
 M pkg/data/usecases/common/common.go
 M pkg/query/factories/init_factories.go
--- 改动行数统计 ---
 8 files changed, 538 insertions(+), 3 deletions(-)
成功判据:生成 evidence_mm.txt,且 11 个章节齐全。
至此 13 个阶段全部完成。
12 结论与建议
12.1 结论
结论一:TSBS 的缺口在量程,不在分辨率。
| 证据 | 出处 |
|---|---|
| 官方 29 个模板中位延迟 0.55 至 317.04 ms,跨度 576 倍 | 9.1 |
KWDB 方言 3 个文件中 JOIN 出现 0 次;对照 timescaledb/iot.go 为 13 次 |
2.4、11 章第 1 节 |
iot 用例将 fleet、driver、model、load_capacity 全部内联进 tag |
2.5、11 章第 2 节 |
在已覆盖的形态内刻度较细,在「多维关联」这一维度上则没有刻度。这是「横向比较多种实现」这一设计目标的必然代价,并非缺陷。
结论二:跨模查询的代价结构内部分化显著。
| 形态 | 耗时 | 相对基线 | 出处 |
|---|---|---|---|
| 纯时序按 tag 分组(基线) | 53 ms | 1× | 10.5 |
| 跨模等值 JOIN(一跳 / 两跳) | 54 ms | +1 ms | 10.5 |
| 跨模非等值时间 JOIN | 2337 ms | 约 44× | 10.5 |
③ 的 LATERAL 改写 |
2342 ms | 约 44×,无收益 | 10.5 |
等值联结引入关系维度的代价可以忽略,代价集中出现在非等值时间联结。
结论三:补充该维度的首要价值是可观测。
5 个跨模模板中,跨模臂仅 1 个胜出(mm-driver-window,0.63×),其余 4 个更慢(2.39×、2.53×、2.82×、204.51×)。
因此本文档不主张跨模查询更快,而是指出:基准若不提出某类问题,就无法给出该类问题的答案,其中既包含代价很低的答案(+1 ms),也包含代价很高的答案(约 44×)。两类答案均直接影响架构决策:前者说明将维度规范化放入关系表是安全的;后者说明凡涉及逐行不同时间窗的关联,上线前必须先做压力测试。
12.2 跨模能力速查表
编写模板或做方案设计时可直接查用,完整依据见第 8 章。
| 编号 | 能力 | 结论 | 备注 |
|---|---|---|---|
| P1 | 跨模等值 JOIN | 支持,代价可忽略 | +1 ms |
| P2 | 跨模 CTAS | 支持 | 用时序数据建关系表 |
| P3 | interval 字面量与算术 |
支持 | — |
| P4 | 两跳跨模 JOIN | 支持 | 关系 A → 关系 B → 时序 |
| P5 | count(DISTINCT) 加 ORDER BY 加 LIMIT |
支持 | — |
| P6 | 关系侧列进 HAVING |
支持 | 阈值或容量参与筛选 |
| P7 | 非等值时间联结 | 语法可行,代价约 44× | 需单独压测 |
| P8 | last() 直接进跨模 JOIN |
不支持,SQLSTATE 0A000 |
改用 P9 |
| P9 | 时序聚合下沉子查询 | 支持 | 绕过 P8 的可行路径 |
| P10 | time_bucket 进跨模 JOIN |
支持 | — |
| P11 | 跨模写入 INSERT…SELECT |
支持 | 台账装配使用该路径 |
| P12 | ANALYZE |
不支持,语法错误 42601 |
会牵连整批 SQL |
12.3 对基准评测的几点建议
评价基准时需同时考察量程与刻度精度:TSBS 的刻度表现良好(576 倍跨度),但若待评对象的长板落在其量程之外,刻度精度无法发挥作用。这并非 TSBS 特有的问题:任何以跨实现可比为目标的基准,都会通过取公共交集的方式排除差异化能力。
补充维度可顺着扩展点实现:本次仅新增 3 个文件(468 行)并修改 5 个文件(70 行),即完成 10 个 query type 的注册。这说明 TSBS 的架构具备可扩展性,缺少的是维度而非扩展能力。
性能对比前必须先证明两臂等价:阶段 11 中两次「不一致」的诊断结论均为核对脚本自身的问题(CSV 表头、排序键选择)。跳过该步骤直接引用性能数字,容易把两个不同的答案当作两种写法的性能差异。
12.4 复现判据汇总
按第 4 章至第 11 章执行完毕后,可用以下命令一次性确认全链路结果。执行前先载入套件配置,其中的主机地址由脚本自动探测,无需手工填写。
cd /tsbs/reproduce && . ./mm_env.sh

echo "== 环境 ==";    cat /etc/redhat-release; go version
echo "== KWDB ==";    systemctl is-active kaiwudb
                      $KWM_BIN version | head -1                        # KaiwuDB Version: 3.2.2
echo "== 补丁 ==";    grep -c '^new file mode' \
                      /tsbs/reproduce/patch/mm_multimode.patch          # 3
echo "== 模板 ==";    /opt/src/kwdb-tsbs/bin/tsbs_generate_queries --help \
                      | grep -c 'use case: multi-mode'                  # 10
echo "== 数据 ==";    $KWM_BIN sql --host=$KWM_HOST:$KWM_PORT \
                      --certs-dir=$KWM_CERTS --user=$KWM_USER --format=csv \
                      -e "SELECT count(*) FROM mm_bm.public.readings;"  # 约 2333572
echo "== 双引擎 ==";  $KWM_BIN sql --host=$KWM_HOST:$KWM_PORT \
                      --certs-dir=$KWM_CERTS --user=$KWM_USER --format=csv \
                      -e "SELECT engine_type FROM [SHOW DATABASES] WHERE database_name IN ('mm_bm','mm_bm_rel');"
echo "== 取证 ==";    ls -l /tsbs/reports/evidence_mm.txt
| 判据 | 期望值 |
|---|---|
kaiwudb 服务 |
active |
| kwbase 版本 | KaiwuDB Version: 3.2.2 |
补丁中 new file mode 数量 |
3 |
use case: multi-mode 数量 |
10 |
mm_bm.readings 行数 |
约 233 万(量级正确即可) |
mm_bm 与 mm_bm_rel 引擎类型 |
TIME SERIES 与 RELATIONAL |
evidence_mm.txt |
存在,11 个章节齐全 |
上述判据全部满足,即表示从零开始的完整跨模复现链路成功。
附录 A 复现套件与完整补丁
A.1 脚本清单
全部脚本位于 reproduce/,共 15 个 Shell 脚本、1 份装配 SQL 与 1 份补丁。
| 文件 | 用途 | 幂等 |
|---|---|---|
mm_env.sh |
公共配置与工具函数,唯一需要按环境修改的文件 | — |
run_all.sh |
一键总控,支持指定起止阶段 | — |
00_env_check.sh |
环境自检 | 是 |
01_get_source.sh |
获取源码并对齐基线 commit | 是 |
02_apply_patch.sh |
应用补丁(3 新增、5 修改) | 是 |
03_build.sh |
离线编译并验证 10 个模板注册 | 是 |
04_gen_data.sh |
生成 iot 数据集 | 是 |
05_import.sh |
导入时序库,先清空再导入 | 是 |
06_assemble.sh |
跨模装配关系台账 | 是 |
07_probe.sh |
12 项跨模可行性探针 | 是 |
08_baseline.sh |
复现官方 29 个模板基线 | 是 |
09_bench.sh |
受控对照:跨模臂与拆分臂 | 是 |
10_decompose.sh |
代价分解 | 是 |
11_equiv.sh |
两臂答案等价性核对 | 是 |
12_evidence.sh |
一次性归集全部取证 | 是 |
sql/mm_dataset.sql |
跨模装配 SQL | 是 |
patch/mm_multimode.patch |
完整补丁(8 文件、665 行) | 是 |
配套脚本包:kwdb_tsbs_multimode_v3.tar.gz,包含上述 15 个脚本、完整补丁、装配 SQL、8 张配图以及本次实测日志(evidence/ 目录)。未取得脚本包时可直接使用正文内容。第 4 章起,每个阶段的脚本均全文列出,与包内文件为同一份内容。
A.2 完整补丁
以下补丁即 6.2 节实际应用的内容。其中含 3 个 new file mode,可在干净的 44ba21c 源码上直接执行 git apply。
若已取得脚本包,无须手工创建,直接使用包内的 reproduce/patch/mm_multimode.patch。
diff --git a/cmd/tsbs_generate_queries/databases/kwdb/common.go b/cmd/tsbs_generate_queries/databases/kwdb/common.go
index 1ba940d..50a6579 100644
--- a/cmd/tsbs_generate_queries/databases/kwdb/common.go
+++ b/cmd/tsbs_generate_queries/databases/kwdb/common.go
@@ -5,6 +5,7 @@ import (

    "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/devops"
    "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/iot"
+   "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/multimode"
    "github.com/timescale/tsbs/cmd/tsbs_generate_queries/utils"
    "github.com/timescale/tsbs/pkg/query"
 )
@@ -14,6 +15,13 @@ type BaseGenerator struct {
    ReadingDBName     string
    DiagnosticsDBName string
    CPUDBName         string
+
+   // TSDBName / RelDBName:multi-mode(跨模)用例用到的两个库。
+   // KWDB 中一个库只能有一个引擎,所以时序表与关系表必须分居两库:
+   //   TSDBName  = --db-name
+   //   RelDBName = --db-name + "_rel"
+   TSDBName  string
+   RelDBName string
 }

 func (g *BaseGenerator) GenerateEmptyQuery() query.Query {
@@ -60,3 +68,19 @@ func (g *BaseGenerator) NewIoT(start, end time.Time, scale int) (utils.QueryGene

    return iot, nil
 }
+
+// NewMultiMode creates a new multi-mode (cross-mode) use case query generator.
+func (g *BaseGenerator) NewMultiMode(start, end time.Time, scale int) (utils.QueryGenerator, error) {
+   core, err := multimode.NewCore(start, end, scale)
+
+   if err != nil {
+       return nil, err
+   }
+
+   mm := &MultiMode{
+       BaseGenerator: g,
+       Core:          core,
+   }
+
+   return mm, nil
+}
diff --git a/cmd/tsbs_generate_queries/databases/kwdb/multimode.go b/cmd/tsbs_generate_queries/databases/kwdb/multimode.go
new file mode 100644
index 0000000..a69e310
--- /dev/null
+++ b/cmd/tsbs_generate_queries/databases/kwdb/multimode.go
@@ -0,0 +1,213 @@
+package kwdb
+
+import (
+   "fmt"
+   "time"
+
+   "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/multimode"
+   "github.com/timescale/tsbs/pkg/query"
+)
+
+// =============================================================================
+//  multi-mode(跨模)用例的 KWDB 方言实现
+//
+//  每个模板产出两套 SQL:
+//    · 跨模臂   —— 一条 SQL 同时引用关系库(台账)与时序库(测量)
+//    · 拆分臂   —— 两条单模 SQL 用 ';' 串起来。tsbs_run_queries_kwdb 的
+//                  ProcessQuery 会按 ';' 拆分后在同一连接上顺序执行并逐条
+//                  drain 结果,因此"往返次数"与"回传行数"都被计入耗时,
+//                  两臂的测量口径一致(见 cmd/tsbs_run_queries_kwdb/main.go:117)。
+//
+//  实测边界(KWDB 3.2.2,已在真实数据集上验证):
+//    · last() / last_row() 不能直接出现在跨模 JOIN 里,会报
+//        "last() can only be used in timeseries table query or subquery"
+//      —— 这类时序专用聚合必须先在自己的时序侧子查询里做完,再跨模联结。
+//    · max / min / sum / avg / count / time_bucket 在跨模 JOIN 里不受限。
+//    · 关系侧列可以直接出现在 HAVING、以及非等值时间联结条件里。
+// =============================================================================
+
+// MultiMode 为 multi-mode 用例产出 KWDB 方言的跨模 / 拆分两臂 SQL
+type MultiMode struct {
+   *multimode.Core
+   *BaseGenerator
+}
+
+// relTable 关系库(台账)下的一张表
+func (m *MultiMode) relTable(name string) string {
+   return fmt.Sprintf("%s.public.%s", m.RelDBName, name)
+}
+
+// tsTable 时序库下的一张表
+func (m *MultiMode) tsTable(name string) string {
+   return fmt.Sprintf("%s.public.%s", m.TSDBName, name)
+}
+
+// win 把一个时间窗口格式化成 SQL 里可直接用的两个时间串
+func win(startMillis, endMillis int64) (string, string) {
+   s := parseTime(time.UnixMilli(startMillis).UTC())
+   e := parseTime(time.UnixMilli(endMillis).UTC())
+   return s, e
+}
+
+// armLabel 给同一个模板的两臂打上可区分的标签
+func armLabel(label string, twoStep bool) (string, string) {
+   if twoStep {
+       return label + " (2-step)", "两臂对照的拆分臂:两次单模查询 + 应用层拼接"
+   }
+   return label + " (cross-mode)", "两臂对照的跨模臂:一条 SQL 同时引用关系表与时序表"
+}
+
+// FleetDaily:按车队所属区域汇总油耗。
+// 跨模形态 1 跳 —— region 只存在于关系表 fleets,油耗只存在于时序表 readings。
+func (m *MultiMode) FleetDaily(qi query.Query, twoStep bool) {
+   ti := m.RandomWindow(multimode.FleetDailyDuration)
+   s, e := win(ti.StartUnixMillis(), ti.EndUnixMillis())
+   trucks := m.relTable(multimode.TrucksTableName)
+   fleets := m.relTable(multimode.FleetsTableName)
+   readings := m.tsTable(multimode.ReadingsTableName)
+
+   var sql string
+   if twoStep {
+       // 拆分臂要多带一列 count(*):关系库里的 avg 是"全体样本均值",
+       // 客户端拿到的是"每车均值",只有配上每车点数才能加权还原,
+       // 否则两臂结果不等价。这是拆分臂必须付出的额外代价之一。
+       sql = fmt.Sprintf(
+           `SELECT t.truck_id, f.region FROM %s t JOIN %s f ON f.fleet_id = t.fleet_id;`+
+               `SELECT name, avg(fuel_consumption) AS avg_fuel, max(fuel_consumption) AS max_fuel, count(*) AS n `+
+               `FROM %s WHERE k_timestamp > '%s' AND k_timestamp <= '%s' GROUP BY name`,
+           trucks, fleets, readings, s, e)
+   } else {
+       sql = fmt.Sprintf(
+           `SELECT f.region AS region, avg(r.fuel_consumption) AS avg_fuel, max(r.fuel_consumption) AS max_fuel `+
+               `FROM %s t JOIN %s f ON f.fleet_id = t.fleet_id JOIN %s r ON r.name = t.truck_id `+
+               `WHERE r.k_timestamp > '%s' AND r.k_timestamp <= '%s' `+
+               `GROUP BY f.region ORDER BY avg_fuel DESC`,
+           trucks, fleets, readings, s, e)
+   }
+
+   label, desc := armLabel("KWDB multi-mode: avg fuel per fleet region", twoStep)
+   m.fillInQuery(qi, label, fmt.Sprintf("%s: %s ~ %s", desc, s, e), multimode.ReadingsTableName, sql)
+}
+
+// DriverWindow:按司机汇总高载点位数。
+// 跨模形态 —— 阈值 load_capacity 取自关系表,事实 current_load 取自时序表。
+func (m *MultiMode) DriverWindow(qi query.Query, twoStep bool) {
+   ti := m.RandomWindow(multimode.DriverWindowDuration)
+   s, e := win(ti.StartUnixMillis(), ti.EndUnixMillis())
+   trucks := m.relTable(multimode.TrucksTableName)
+   diag := m.tsTable(multimode.DiagnosticsTableName)
+
+   var sql string
+   if twoStep {
+       // 拆分臂无法把"逐车不同的阈值"下推,只能把明细拉回客户端逐行比较。
+       sql = fmt.Sprintf(
+           `SELECT truck_id, driver, load_capacity FROM %s;`+
+               `SELECT name, current_load FROM %s WHERE k_timestamp > '%s' AND k_timestamp <= '%s'`,
+           trucks, diag, s, e)
+   } else {
+       sql = fmt.Sprintf(
+           `SELECT t.driver AS driver, count(*) AS high_load_points `+
+               `FROM %s t JOIN %s r ON r.name = t.truck_id `+
+               `WHERE r.k_timestamp > '%s' AND r.k_timestamp <= '%s' AND r.current_load > 0.8 * t.load_capacity `+
+               `GROUP BY t.driver ORDER BY high_load_points DESC`,
+           trucks, diag, s, e)
+   }
+
+   label, desc := armLabel("KWDB multi-mode: high-load points per driver", twoStep)
+   m.fillInQuery(qi, label, fmt.Sprintf("%s: %s ~ %s", desc, s, e), multimode.DiagnosticsTableName, sql)
+}
+
+// DepotTopN:按车场汇总油耗并取 TOP-5。
+// 跨模形态 2 跳 —— trucks → fleets(关系库内)→ readings(跨到时序库)。
+func (m *MultiMode) DepotTopN(qi query.Query, twoStep bool) {
+   ti := m.RandomWindow(multimode.DepotTopNDuration)
+   s, e := win(ti.StartUnixMillis(), ti.EndUnixMillis())
+   trucks := m.relTable(multimode.TrucksTableName)
+   fleets := m.relTable(multimode.FleetsTableName)
+   readings := m.tsTable(multimode.ReadingsTableName)
+
+   var sql string
+   if twoStep {
+       sql = fmt.Sprintf(
+           `SELECT t.truck_id, f.depot FROM %s t JOIN %s f ON f.fleet_id = t.fleet_id;`+
+               `SELECT name, sum(fuel_consumption) AS total_fuel FROM %s `+
+               `WHERE k_timestamp > '%s' AND k_timestamp <= '%s' GROUP BY name`,
+           trucks, fleets, readings, s, e)
+   } else {
+       sql = fmt.Sprintf(
+           `SELECT f.depot AS depot, sum(r.fuel_consumption) AS total_fuel `+
+               `FROM %s t JOIN %s f ON f.fleet_id = t.fleet_id JOIN %s r ON r.name = t.truck_id `+
+               `WHERE r.k_timestamp > '%s' AND r.k_timestamp <= '%s' `+
+               `GROUP BY f.depot ORDER BY total_fuel DESC LIMIT 5`,
+           trucks, fleets, readings, s, e)
+   }
+
+   label, desc := armLabel("KWDB multi-mode: top depots by fuel (2 hops)", twoStep)
+   m.fillInQuery(qi, label, fmt.Sprintf("%s: %s ~ %s", desc, s, e), multimode.ReadingsTableName, sql)
+}
+
+// Overload:峰值载重超过额定载重的车辆清单。
+// 跨模形态 —— 关系侧列直接参与 HAVING,实现"阈值来自台账、判定来自时序"。
+func (m *MultiMode) Overload(qi query.Query, twoStep bool) {
+   ti := m.RandomWindow(multimode.OverloadDuration)
+   s, e := win(ti.StartUnixMillis(), ti.EndUnixMillis())
+   trucks := m.relTable(multimode.TrucksTableName)
+   diag := m.tsTable(multimode.DiagnosticsTableName)
+
+   var sql string
+   if twoStep {
+       sql = fmt.Sprintf(
+           `SELECT truck_id, model, load_capacity FROM %s;`+
+               `SELECT name, max(current_load) AS peak_load FROM %s `+
+               `WHERE k_timestamp > '%s' AND k_timestamp <= '%s' GROUP BY name`,
+           trucks, diag, s, e)
+   } else {
+       sql = fmt.Sprintf(
+           `SELECT t.truck_id, t.model, max(r.current_load) AS peak_load, t.load_capacity `+
+               `FROM %s t JOIN %s r ON r.name = t.truck_id `+
+               `WHERE r.k_timestamp > '%s' AND r.k_timestamp <= '%s' `+
+               `GROUP BY t.truck_id, t.model, t.load_capacity `+
+               `HAVING max(r.current_load) > t.load_capacity `+
+               `ORDER BY peak_load DESC LIMIT 10`,
+           trucks, diag, s, e)
+   }
+
+   label, desc := armLabel("KWDB multi-mode: trucks over rated load", twoStep)
+   m.fillInQuery(qi, label, fmt.Sprintf("%s: %s ~ %s", desc, s, e), multimode.DiagnosticsTableName, sql)
+}
+
+// InstallWindow:每车"投运后首个窗口"内的行驶情况。
+// 跨模形态最难的一种:窗口右界由关系表 installed_on 逐行决定,是非等值时间联结。
+// 拆分臂无法等价表达 —— 只能把并集窗口的原始明细整表拉回,再由客户端逐车裁剪。
+func (m *MultiMode) InstallWindow(qi query.Query, twoStep bool) {
+   trucks := m.relTable(multimode.TrucksTableName)
+   readings := m.tsTable(multimode.ReadingsTableName)
+
+   var sql, windowDesc string
+   if twoStep {
+       // 并集窗口 = [数据起点, 数据起点 + 台账投运偏移上限 + 单行窗口长度]
+       ws := time.UnixMilli(m.WholeInterval().StartUnixMillis()).UTC()
+       we := ws.Add(multimode.InstallWindowSpread + multimode.InstallWindowDuration)
+       s, e := parseTime(ws), parseTime(we)
+       windowDesc = fmt.Sprintf("并集窗口 %s ~ %s", s, e)
+       sql = fmt.Sprintf(
+           `SELECT truck_id, installed_on FROM %s;`+
+               `SELECT name, k_timestamp, velocity FROM %s `+
+               `WHERE k_timestamp >= '%s' AND k_timestamp < '%s'`,
+           trucks, readings, s, e)
+   } else {
+       windowDesc = fmt.Sprintf("逐车窗口 = installed_on ~ installed_on + %s", multimode.InstallWindowDuration)
+       sql = fmt.Sprintf(
+           `SELECT t.truck_id AS truck_id, t.installed_on AS installed_on, `+
+               `count(*) AS pts, avg(r.velocity) AS avg_v `+
+               `FROM %s t JOIN %s r `+
+               `  ON r.name = t.truck_id `+
+               ` AND r.k_timestamp >= t.installed_on `+
+               ` AND r.k_timestamp <  t.installed_on + INTERVAL '%d minutes' `+
+               `GROUP BY t.truck_id, t.installed_on ORDER BY truck_id`,
+           trucks, readings, int(multimode.InstallWindowDuration.Minutes()))
+   }
+
+   label, desc := armLabel("KWDB multi-mode: first window after installation", twoStep)
+   m.fillInQuery(qi, label, fmt.Sprintf("%s: %s", desc, windowDesc), multimode.ReadingsTableName, sql)
+}
diff --git a/cmd/tsbs_generate_queries/main.go b/cmd/tsbs_generate_queries/main.go
index b5970f4..1e82b1a 100644
--- a/cmd/tsbs_generate_queries/main.go
+++ b/cmd/tsbs_generate_queries/main.go
@@ -12,6 +12,7 @@ import (
    "github.com/spf13/pflag"
    "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/devops"
    "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/iot"
+   "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/multimode"
    "github.com/timescale/tsbs/cmd/tsbs_generate_queries/utils"
    "github.com/timescale/tsbs/internal/inputs"
    internalUtils "github.com/timescale/tsbs/internal/utils"
@@ -51,6 +52,21 @@ var useCaseMatrix = map[string]map[string]utils.QueryFillerMaker{
        iot.LabelDailyActivity:                 iot.NewDailyTruckActivity,
        iot.LabelBreakdownFrequency:            iot.NewTruckBreakdownFrequency,
    },
+   // multi-mode(跨模):本项目为 kwdb-tsbs 新增的用例。
+   // 每个模板注册两个 query type —— 跨模臂 与 拆分臂(-2step),
+   // 两臂共用同一段生成代码,构成受控对照。
+   "multi-mode": {
+       multimode.LabelFleetDaily:                              multimode.NewFleetDaily(false),
+       multimode.LabelFleetDaily + multimode.TwoStepSuffix:    multimode.NewFleetDaily(true),
+       multimode.LabelDriverWindow:                            multimode.NewDriverWindow(false),
+       multimode.LabelDriverWindow + multimode.TwoStepSuffix:  multimode.NewDriverWindow(true),
+       multimode.LabelDepotTopN:                               multimode.NewDepotTopN(false),
+       multimode.LabelDepotTopN + multimode.TwoStepSuffix:     multimode.NewDepotTopN(true),
+       multimode.LabelOverload:                                multimode.NewOverload(false),
+       multimode.LabelOverload + multimode.TwoStepSuffix:      multimode.NewOverload(true),
+       multimode.LabelInstallWindow:                           multimode.NewInstallWindow(false),
+       multimode.LabelInstallWindow + multimode.TwoStepSuffix: multimode.NewInstallWindow(true),
+   },
 }

 var conf = &config.QueryGeneratorConfig{}
diff --git a/cmd/tsbs_generate_queries/uses/multimode/common.go b/cmd/tsbs_generate_queries/uses/multimode/common.go
new file mode 100644
index 0000000..8cf1a11
--- /dev/null
+++ b/cmd/tsbs_generate_queries/uses/multimode/common.go
@@ -0,0 +1,120 @@
+package multimode
+
+import (
+   "time"
+
+   "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/common"
+   internalutils "github.com/timescale/tsbs/internal/utils"
+   "github.com/timescale/tsbs/pkg/query"
+)
+
+// =============================================================================
+//  multi-mode(跨模)用例:给 TSBS 的时间序列基准补上「关系表 × 时序表」一个维度
+//
+//  为什么需要它
+//    kwdb-tsbs 现有的两个用例(cpu-only / iot)共 29 个查询模板,全部是
+//    「单表时序聚合」——SQL 里一个 JOIN 都没有。iot 用例更把 fleet / driver /
+//    model / load_capacity 这些业务维度整体压进时序表的 tag 里
+//    (见 pkg/data/usecases/iot/truck.go),于是"多模数据库"最有辨识度的能力
+//    —— 一条 SQL 里把业务维度与时间线关联起来 —— 在基准里根本没有被测到。
+//
+//  本用例做什么
+//    把那些被压进 tag 的业务维度"还原"成关系库里的台账表(fleets / trucks),
+//    时序库只留测量值,然后提出 5 个必须同时用到两边才能回答的问题。
+//    每个问题给出两种写法,形成受控对照:
+//      · 跨模臂(默认)      :一条 SQL 同时引用关系表与时序表
+//      · 拆分臂(-2step)    :两次单模查询 + 应用层拼接
+//    两臂由同一套模板生成、在同一把尺子下测量,差异只来自"跨不跨模"。
+// =============================================================================
+
+const (
+   // 时序侧表名:沿用 kwdb-tsbs iot 用例的物理表,保证数据可以复用同一条导入链路
+   ReadingsTableName    = "readings"
+   DiagnosticsTableName = "diagnostics"
+
+   // 关系侧表名:从时序 tag 还原出来的业务台账
+   TrucksTableName = "trucks"
+   FleetsTableName = "fleets"
+
+   // RelDBSuffix 关系库命名约定:时序库名为 --db-name,关系库名为 <--db-name>_rel。
+   // KWDB 中一个库只能有一个引擎,所以关系表与时序表必须分居两库,跨模查询即跨库查询。
+   RelDBSuffix = "_rel"
+
+   // TwoStepSuffix 拆分臂的 query type 后缀
+   TwoStepSuffix = "-2step"
+
+   // query type 标签(会出现在 tsbs_generate_queries 的 use case matrix 里)
+   LabelFleetDaily    = "mm-fleet-daily"
+   LabelDriverWindow  = "mm-driver-window"
+   LabelDepotTopN     = "mm-depot-topn"
+   LabelOverload      = "mm-overload"
+   LabelInstallWindow = "mm-install-window"
+
+   // 各模板使用的时间窗
+   // 注:窗口不宜过大,否则拆分臂要把海量明细拉回客户端,
+   //     单次跑测会从"测延迟"退化成"测网络吞吐"。窗口取值与数据规模配套。
+   FleetDailyDuration    = 1 * time.Hour
+   DriverWindowDuration  = 1 * time.Hour
+   DepotTopNDuration     = 1 * time.Hour
+   OverloadDuration      = 1 * time.Hour
+   InstallWindowDuration = 30 * time.Minute
+
+   // InstallWindowSpread 台账里 installed_on 相对数据起点的最大偏移。
+   // 由装配脚本 tsbs_mm_dataset.sql 按 (车号 % 12) * 5 分钟 生成,最大 55 分钟。
+   // 拆分臂需要它来推算"并集窗口"的右界,故必须与装配脚本保持一致。
+   InstallWindowSpread = 55 * time.Minute
+)
+
+// Core 是所有 multi-mode 模板共享的公共部分
+type Core struct {
+   *common.Core
+}
+
+// NewCore 为给定的时间范围与规模创建一个 Core
+func NewCore(start, end time.Time, scale int) (*Core, error) {
+   c, err := common.NewCore(start, end, scale)
+   return &Core{Core: c}, err
+}
+
+// RandomWindow 在整体时间范围内随机取一段长度为 d 的窗口。
+// 与 devops / iot 的取窗方式一致,配合固定 seed 可复现。
+func (c *Core) RandomWindow(d time.Duration) *internalutils.TimeInterval {
+   return c.Interval.MustRandWindow(d)
+}
+
+// WholeInterval 返回整体时间范围,供需要"并集窗口"的拆分臂使用
+func (c *Core) WholeInterval() *internalutils.TimeInterval {
+   return c.Interval
+}
+
+// ---------------------------------------------------------------------------
+//  以下是「用例侧 → 数据库侧」的填充接口。
+//  每个接口对应一个模板;databases/kwdb 包实现它们,把模板翻译成 KWDB 的 SQL。
+//  twoStep == false 表示跨模臂,true 表示拆分臂。
+// ---------------------------------------------------------------------------
+
+// FleetDailyFiller 按车队所属区域汇总时间窗内的油耗
+type FleetDailyFiller interface {
+   FleetDaily(query.Query, bool)
+}
+
+// DriverWindowFiller 按司机汇总时间窗内超过额定载重的点位数
+type DriverWindowFiller interface {
+   DriverWindow(query.Query, bool)
+}
+
+// DepotTopNFiller 按车场(二级关系表)汇总油耗并取 TOP-N
+type DepotTopNFiller interface {
+   DepotTopN(query.Query, bool)
+}
+
+// OverloadFiller 找出时间窗内峰值载重超过额定载重的车辆
+type OverloadFiller interface {
+   Overload(query.Query, bool)
+}
+
+// InstallWindowFiller 统计每车"投运后首个窗口"内的行驶情况。
+// 窗口由关系表的 installed_on 逐行决定,是跨模查询里最难被拆分臂等价表达的一类。
+type InstallWindowFiller interface {
+   InstallWindow(query.Query, bool)
+}
diff --git a/cmd/tsbs_generate_queries/uses/multimode/queries.go b/cmd/tsbs_generate_queries/uses/multimode/queries.go
new file mode 100644
index 0000000..5f88323
--- /dev/null
+++ b/cmd/tsbs_generate_queries/uses/multimode/queries.go
@@ -0,0 +1,135 @@
+package multimode
+
+import (
+   "github.com/timescale/tsbs/cmd/tsbs_generate_queries/uses/common"
+   "github.com/timescale/tsbs/cmd/tsbs_generate_queries/utils"
+   "github.com/timescale/tsbs/pkg/query"
+)
+
+// =============================================================================
+//  模板填充器(QueryFiller)
+//
+//  写法沿用 tsbs 既有约定:每个模板是一个 QueryFillerMaker,
+//  NewXxx(twoStep) 返回 maker,供 useCaseMatrix 注册;Fill 时把
+//  控制权交给数据库侧实现(databases/kwdb)。
+//
+//  同一个模板注册两次,就得到两个 query type:
+//      mm-fleet-daily           跨模臂
+//      mm-fleet-daily-2step     拆分臂
+//  两臂共用同一段代码路径,只有 twoStep 一个布尔量不同 —— 这是"受控对照"的前提。
+// =============================================================================
+
+// FleetDaily 按车队所属区域汇总油耗
+type FleetDaily struct {
+   core    utils.QueryGenerator
+   twoStep bool
+}
+
+// NewFleetDaily 创建 FleetDaily 填充器
+func NewFleetDaily(twoStep bool) utils.QueryFillerMaker {
+   return func(core utils.QueryGenerator) utils.QueryFiller {
+       return &FleetDaily{core: core, twoStep: twoStep}
+   }
+}
+
+// Fill 填充查询
+func (f *FleetDaily) Fill(q query.Query) query.Query {
+   fc, ok := f.core.(FleetDailyFiller)
+   if !ok {
+       common.PanicUnimplementedQuery(f.core)
+   }
+   fc.FleetDaily(q, f.twoStep)
+   return q
+}
+
+// DriverWindow 按司机汇总高载点位数
+type DriverWindow struct {
+   core    utils.QueryGenerator
+   twoStep bool
+}
+
+// NewDriverWindow 创建 DriverWindow 填充器
+func NewDriverWindow(twoStep bool) utils.QueryFillerMaker {
+   return func(core utils.QueryGenerator) utils.QueryFiller {
+       return &DriverWindow{core: core, twoStep: twoStep}
+   }
+}
+
+// Fill 填充查询
+func (f *DriverWindow) Fill(q query.Query) query.Query {
+   fc, ok := f.core.(DriverWindowFiller)
+   if !ok {
+       common.PanicUnimplementedQuery(f.core)
+   }
+   fc.DriverWindow(q, f.twoStep)
+   return q
+}
+
+// DepotTopN 按车场汇总油耗并取 TOP-N
+type DepotTopN struct {
+   core    utils.QueryGenerator
+   twoStep bool
+}
+
+// NewDepotTopN 创建 DepotTopN 填充器
+func NewDepotTopN(twoStep bool) utils.QueryFillerMaker {
+   return func(core utils.QueryGenerator) utils.QueryFiller {
+       return &DepotTopN{core: core, twoStep: twoStep}
+   }
+}
+
+// Fill 填充查询
+func (f *DepotTopN) Fill(q query.Query) query.Query {
+   fc, ok := f.core.(DepotTopNFiller)
+   if !ok {
+       common.PanicUnimplementedQuery(f.core)
+   }
+   fc.DepotTopN(q, f.twoStep)
+   return q
+}
+
+// Overload 找出峰值载重超限车辆
+type Overload struct {
+   core    utils.QueryGenerator
+   twoStep bool
+}
+
+// NewOverload 创建 Overload 填充器
+func NewOverload(twoStep bool) utils.QueryFillerMaker {
+   return func(core utils.QueryGenerator) utils.QueryFiller {
+       return &Overload{core: core, twoStep: twoStep}
+   }
+}
+
+// Fill 填充查询
+func (f *Overload) Fill(q query.Query) query.Query {
+   fc, ok := f.core.(OverloadFiller)
+   if !ok {
+       common.PanicUnimplementedQuery(f.core)
+   }
+   fc.Overload(q, f.twoStep)
+   return q
+}
+
+// InstallWindow 统计投运后首个窗口内的行驶情况
+type InstallWindow struct {
+   core    utils.QueryGenerator
+   twoStep bool
+}
+
+// NewInstallWindow 创建 InstallWindow 填充器
+func NewInstallWindow(twoStep bool) utils.QueryFillerMaker {
+   return func(core utils.QueryGenerator) utils.QueryFiller {
+       return &InstallWindow{core: core, twoStep: twoStep}
+   }
+}
+
+// Fill 填充查询
+func (f *InstallWindow) Fill(q query.Query) query.Query {
+   fc, ok := f.core.(InstallWindowFiller)
+   if !ok {
+       common.PanicUnimplementedQuery(f.core)
+   }
+   fc.InstallWindow(q, f.twoStep)
+   return q
+}
diff --git a/internal/inputs/generator_queries.go b/internal/inputs/generator_queries.go
index 0775761..dd29231 100644
--- a/internal/inputs/generator_queries.go
+++ b/internal/inputs/generator_queries.go
@@ -29,7 +29,7 @@ const (
    errUnknownUseCaseFmt        = "use case '%s' is undefined"
    errCannotParseTimeFmt       = "cannot parse time from string '%s': %v"
    errBadUseFmt                = "invalid use case specified: '%v'"
-   errCannotUsecaseType        = "kwdb cannot support this use-case '%s', currently only supports cpu-only in devops"
+   errCannotUsecaseType        = "kwdb cannot support this use-case '%s', currently only supports cpu-only/iot/multi-mode in devops"
 )

 // DevopsGeneratorMaker creates a query generator for devops use case
@@ -42,6 +42,12 @@ type IoTGeneratorMaker interface {
    NewIoT(start, end time.Time, scale int) (queryUtils.QueryGenerator, error)
 }

+// MultiModeGeneratorMaker creates a query generator for the multi-mode
+// (cross-mode) use case added on top of kwdb-tsbs.
+type MultiModeGeneratorMaker interface {
+   NewMultiMode(start, end time.Time, scale int) (queryUtils.QueryGenerator, error)
+}
+
 // QueryGenerator is a type of Generator for creating queries to test against a
 // database. The output is specific to the type of database (due to each using
 // different querying techniques, e.g. SQL or REST), but is consumed by TSBS
@@ -110,7 +116,8 @@ func (g *QueryGenerator) init(conf common.GeneratorConfig) error {
        return err
    }

-   if g.conf.Format == "kwdb" && g.conf.Use != common.UseCaseCPUOnly && g.conf.Use != common.UseCaseIoT {
+   if g.conf.Format == "kwdb" && g.conf.Use != common.UseCaseCPUOnly &&
+       g.conf.Use != common.UseCaseIoT && g.conf.Use != common.UseCaseMultiMode {
        return fmt.Errorf(errCannotUsecaseType, g.conf.Use)
    }
    if err := g.initFactories(); err != nil {
@@ -163,7 +170,7 @@ func (g *QueryGenerator) addFactory(database string, factory interface{}) error
    validFactory := false

    switch factory.(type) {
-   case DevopsGeneratorMaker, IoTGeneratorMaker:
+   case DevopsGeneratorMaker, IoTGeneratorMaker, MultiModeGeneratorMaker:
        validFactory = true
    }

@@ -194,6 +201,14 @@ func (g *QueryGenerator) getUseCaseGenerator(c *config.QueryGeneratorConfig) (qu
        }

        return iotFactory.NewIoT(g.tsStart, g.tsEnd, scale)
+   case common.UseCaseMultiMode:
+       mmFactory, ok := factory.(MultiModeGeneratorMaker)
+
+       if !ok {
+           return nil, fmt.Errorf(errUseCaseNotImplementedFmt, c.Use, c.Format)
+       }
+
+       return mmFactory.NewMultiMode(g.tsStart, g.tsEnd, scale)
    case common.UseCaseDevops, common.UseCaseCPUOnly, common.UseCaseCPUSingle:
        devopsFactory, ok := factory.(DevopsGeneratorMaker)
        if !ok {
diff --git a/pkg/data/usecases/common/common.go b/pkg/data/usecases/common/common.go
index d231888..ed0b5d3 100644
--- a/pkg/data/usecases/common/common.go
+++ b/pkg/data/usecases/common/common.go
@@ -24,6 +24,9 @@ const (
    UseCaseDevops        = "devops"
    UseCaseIoT           = "iot"
    UseCaseDevopsGeneric = "devops-generic"
+   // UseCaseMultiMode 是 kwdb-tsbs 上新增的跨模用例:
+   // 时序表只存测量值,业务维度放进关系表,查询必须同时引用两边。
+   UseCaseMultiMode = "multi-mode"
 )

 var UseCaseChoices = []string{
@@ -32,4 +35,5 @@ var UseCaseChoices = []string{
    UseCaseDevops,
    UseCaseIoT,
    UseCaseDevopsGeneric,
+   UseCaseMultiMode,
 }
diff --git a/pkg/query/factories/init_factories.go b/pkg/query/factories/init_factories.go
index a6a0c02..4425dad 100644
--- a/pkg/query/factories/init_factories.go
+++ b/pkg/query/factories/init_factories.go
@@ -52,6 +52,14 @@ func InitQueryFactories(config *config.QueryGeneratorConfig) map[string]interfac
                ReadingDBName:     config.DbName,
                DiagnosticsDBName: config.DbName,
            }
+       } else if config.Use == "multi-mode" {
+           // 跨模用例要同时指到时序库和关系库。命名约定见
+           // cmd/tsbs_generate_queries/uses/multimode/common.go 的 RelDBSuffix。
+           factories[constants.FormatKwdb] = &KWDB.BaseGenerator{
+               ReadingDBName: config.DbName,
+               TSDBName:      config.DbName,
+               RelDBName:     config.DbName + "_rel",
+           }
        }
    }
    return factories
评论(0)