
设备、车辆、产线和能源系统持续产生的时序数据入库之后,如何快速做成趋势图、监控面板和分析看板,往往还要经历数据源适配、查询语法调整和可视化配置等环节。对于已经使用 Grafana 的团队来说,最自然的期待,是界面和看板不用换,KaiwuDB 里的时序数据能直接查。
现在,KaiwuDB 将这条链路打通了——KaiwuDB Grafana 数据源插件正式发布,适用于KaiwuDB 企业版与开源版本 KWDB。用户可以通过 Grafana 连接 KaiwuDB 数据源,使用面向时序场景的查询能力,构建实时趋势、运行监控和数据分析看板。
目前,插件已提交 Grafana 官方插件生态审核,用户可以优先从开源仓库获取,安装方式以仓库说明为准。
开源仓库:GitHub - KWDB/kwdb-grafana-plugin: Official KWDB datasource plugin for Grafana
镜像仓库:https://gitee.com/kwdb/kwdb-grafana-plugin
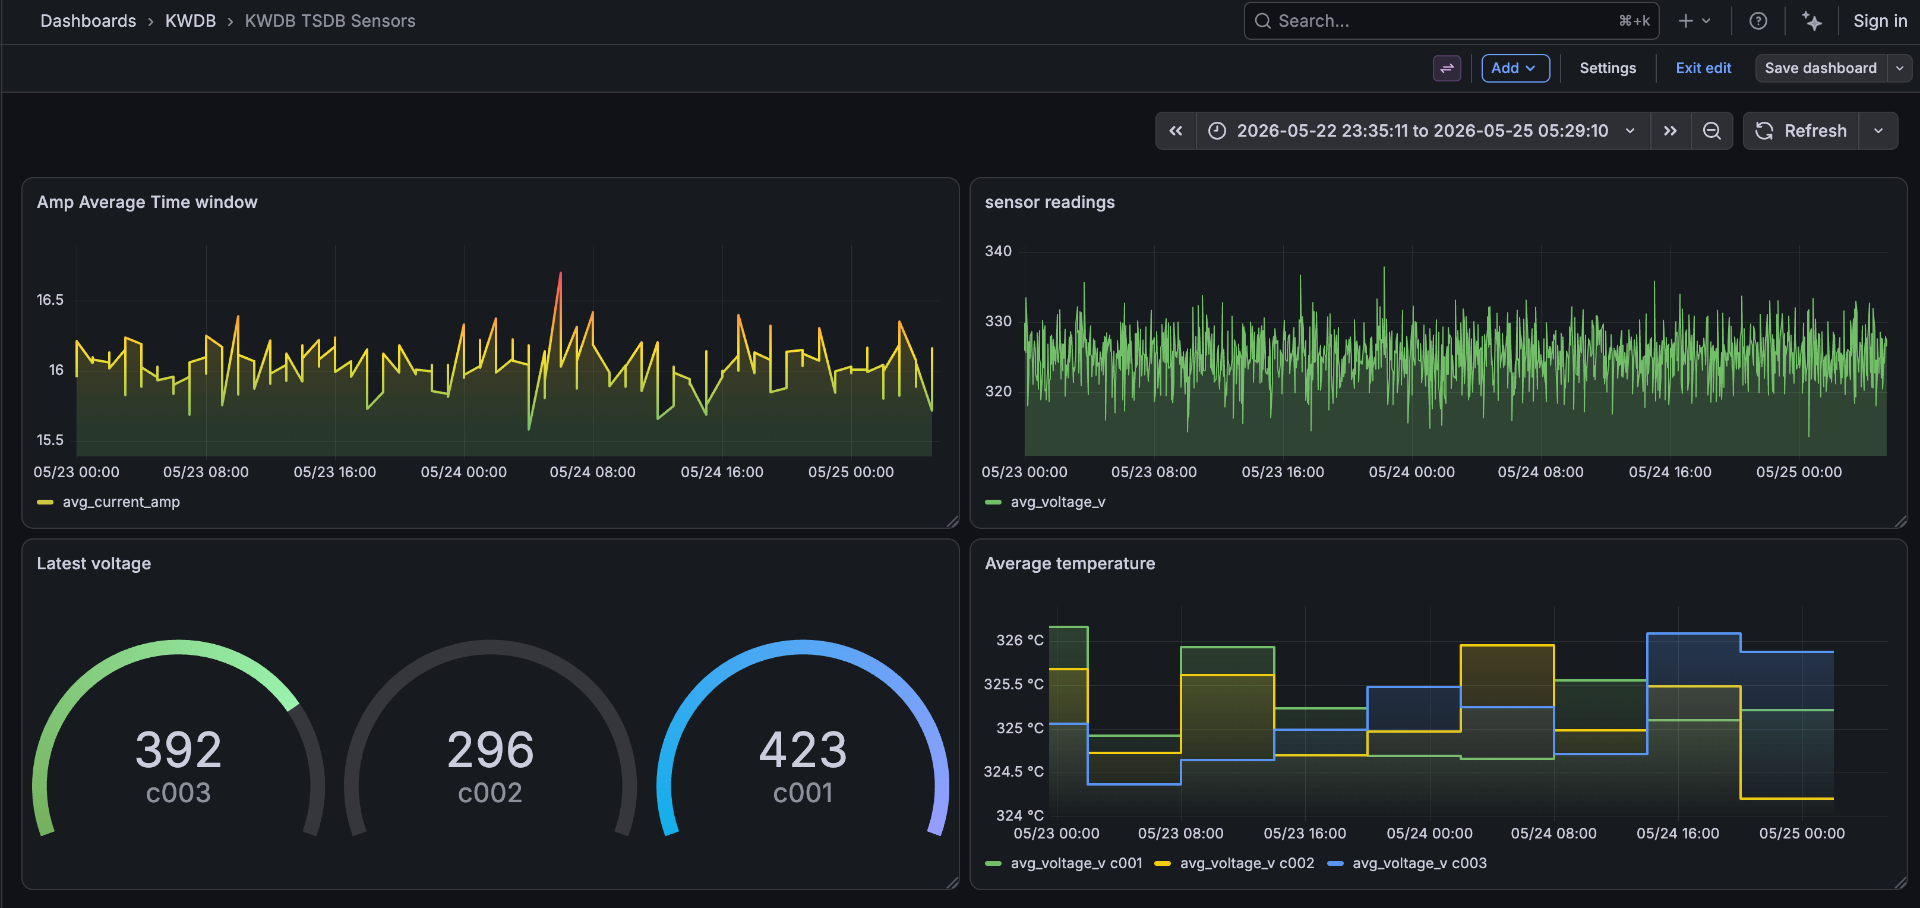
01|让 KaiwuDB 中的数据进入 Grafana 查询流程
Grafana 擅长把数据组织成可对比、可追踪的图表和看板。KaiwuDB Grafana 数据源插件负责打通数据库与看板之间的连接:Grafana 通过 PostgreSQL 兼容协议、以只读 SQL 访问 KaiwuDB的时序引擎,查询结果以时间序列或表格数据的形式返回面板。
这样一来,用户可以在 Grafana 中统一管理数据源、时间范围、看板变量、刷新频率和面板布局,不必为了查看 KaiwuDB 中的时序数据另建一套可视化入口。插件还能列出库里的表和列,并区分时序表与普通表,查询时可以直接选对象。
02|Quick Start:在 Grafana 中连接 KaiwuDB 查数据
说到底,它就是一个 Grafana 数据源插件。装上之后,KaiwuDB 在 Grafana 眼里和原生支持的数据源没有区别——数据源列表里多出一个「KWDB TSDB」(插件在 Grafana 中的显示名)选项,我们支持写 SQL,更值得关注的是——为用户提供了友好的可视化方式来配置常用的时序查询,无需掌握 SQL 语法(如 time_bucket 等)也能轻松上手。结果可以直接画成折线图、表格、柱状图和统计面板。整条接入过程不长,大致分三步。
第一步 · 安装插件,把 KaiwuDB 加进数据源列表
从开源仓库获取插件并完成安装。需要留意:当前版本要求 Grafana 13.1 及以上,KaiwuDB 企业版与开源版本 KWDB 均可使用。安装完成后,Grafana 的数据源页面就会出现「KWDB TSDB」这一选项。
第二步 · 配置连接,把地址和认证填对
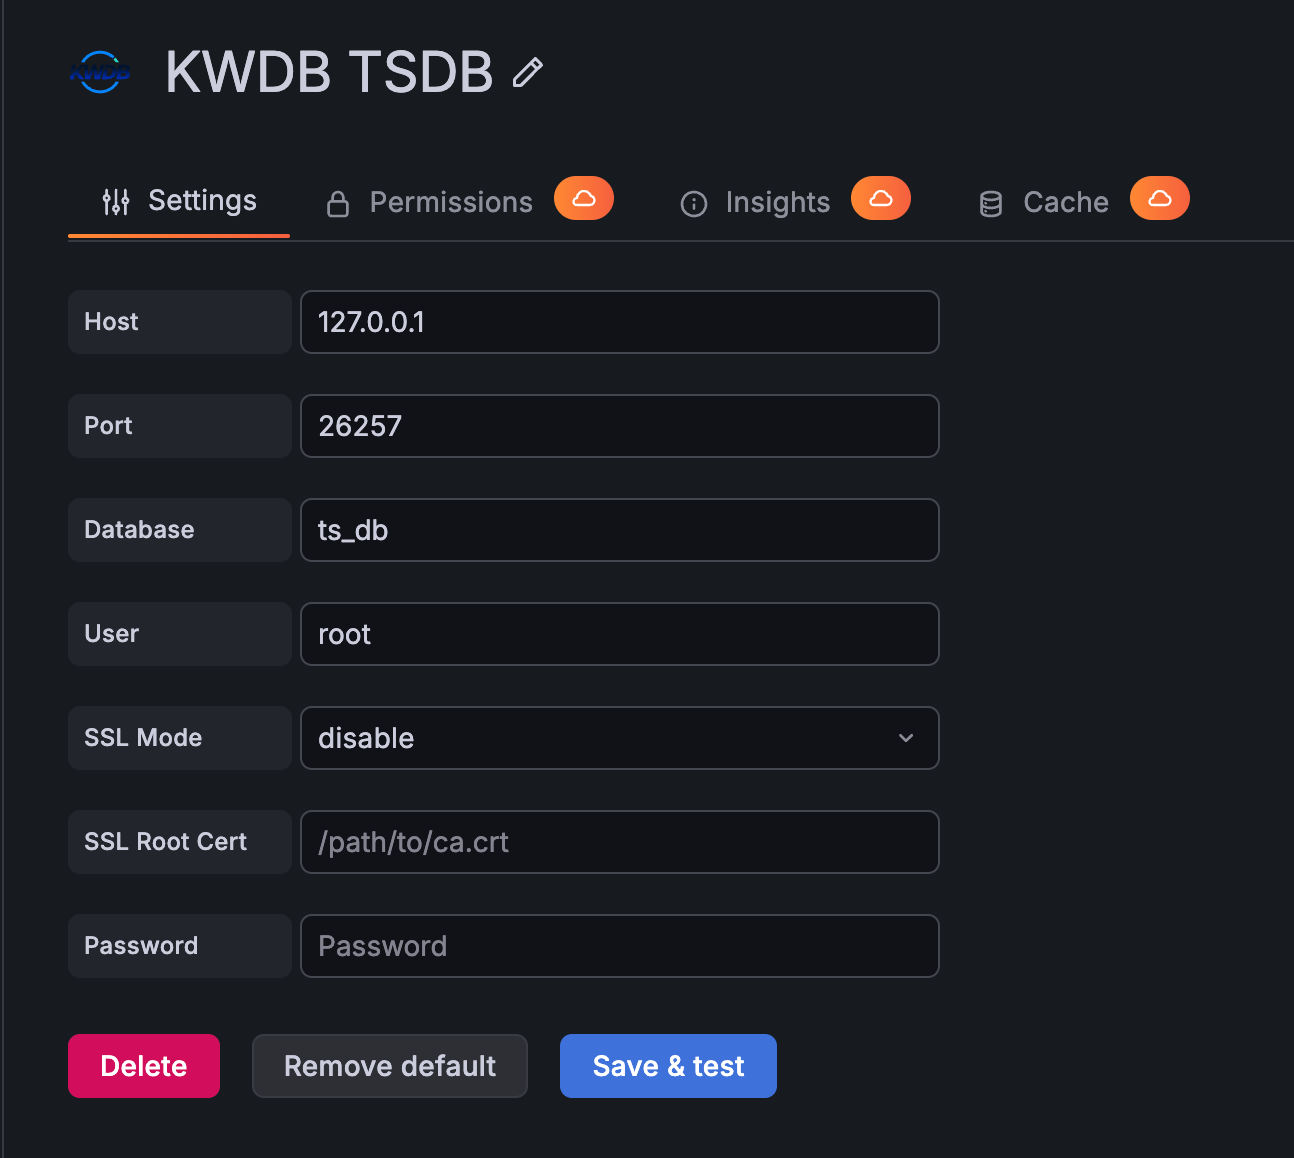
在 Grafana 数据源配置中选择「KWDB TSDB」,填写目标服务的地址、端口、数据库名和账号密码;生产环境还支持按部署方式配置 TLS 。点击 Save & test,连接通过后,这个数据源就可以被任意面板引用。
第三步 · 写查询,用 SQL 拿到你要的那段时间
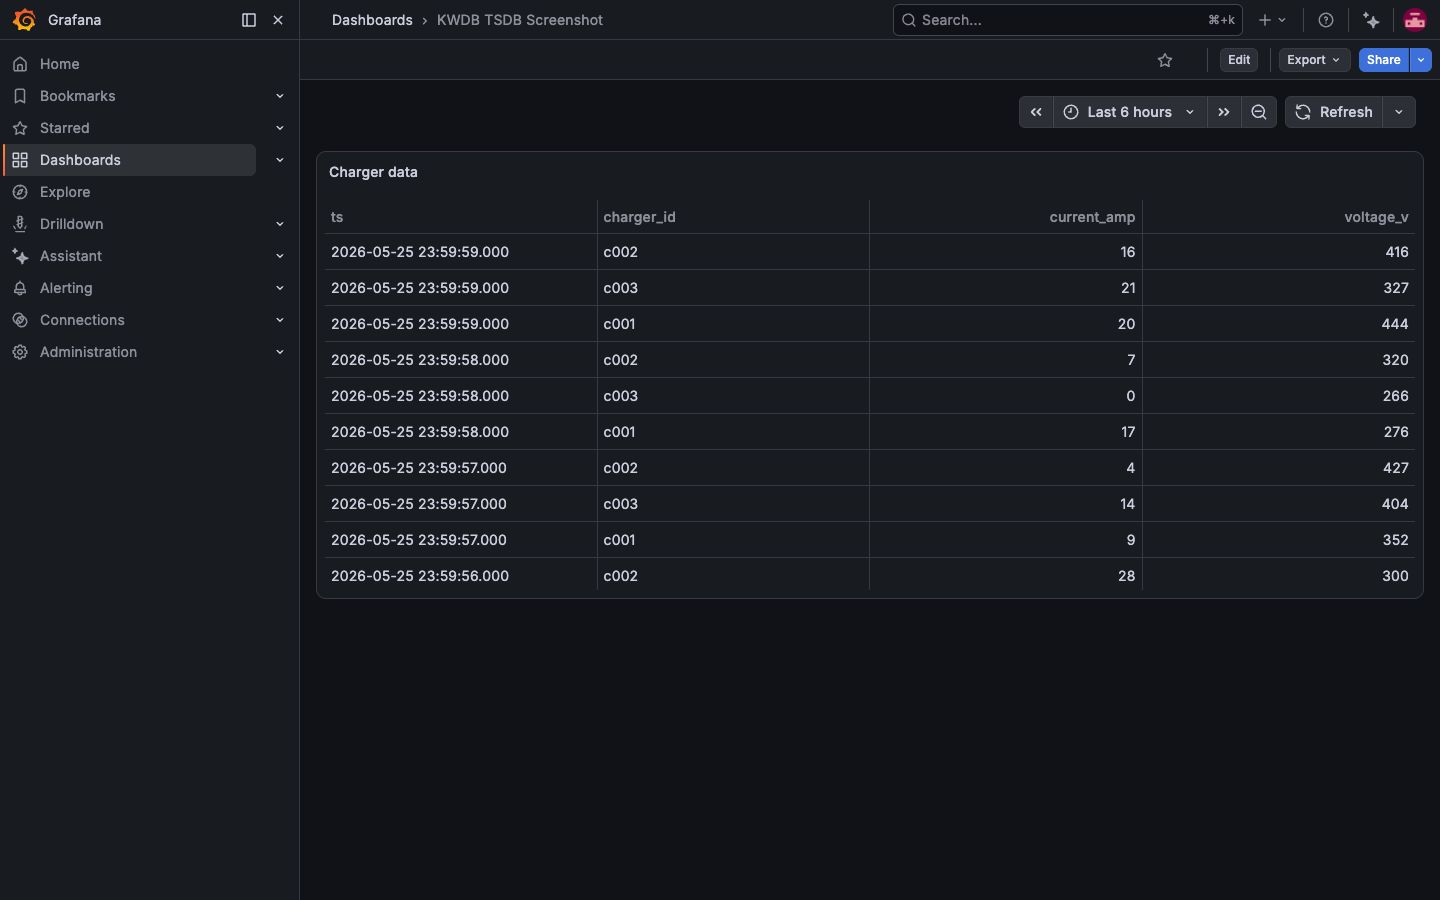
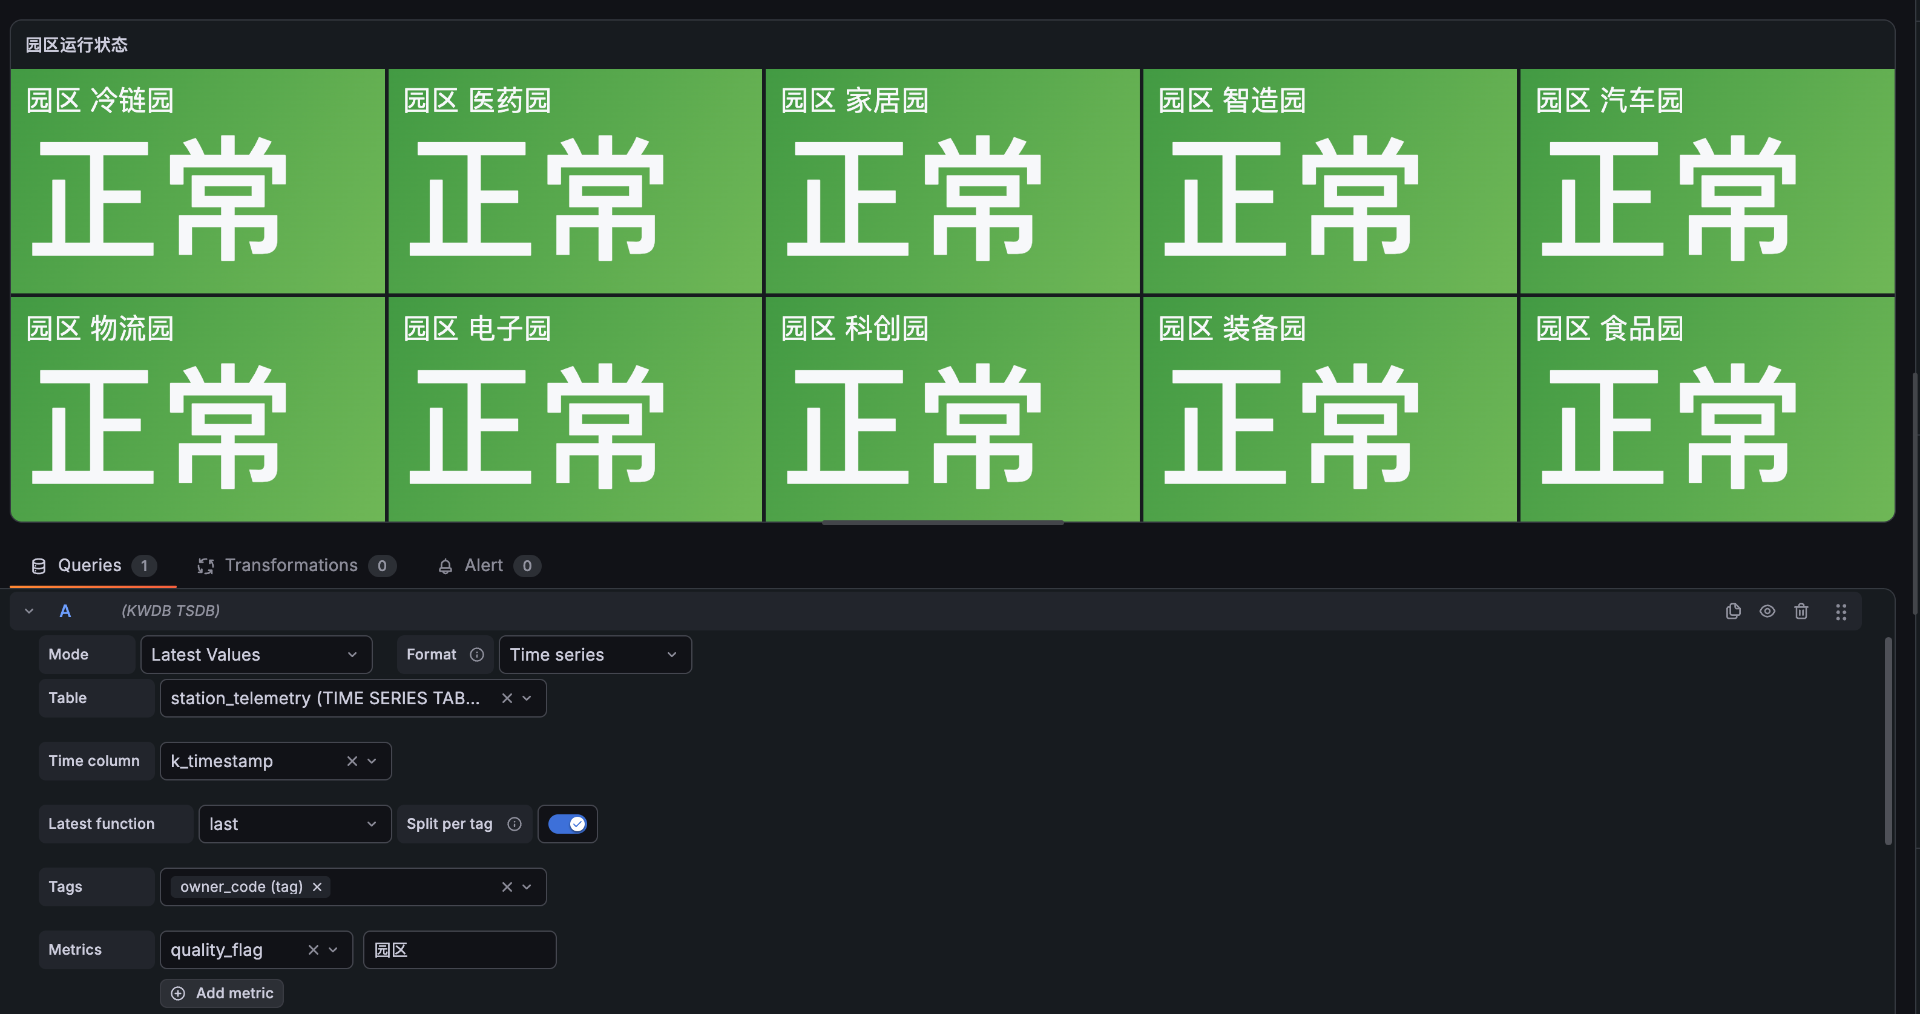
打开面板,选择刚创建的「KWDB TSDB」数据源,在查询编辑器里写 SQL,也可以用降采样、补值、最新值、窗口/事件四种可视化模式——选好表和字段,插件会自动生成 SQL,并在编辑器中给出只读的 SQL 预览。插件只接受只读语句,写语句和多语句查询会被拒绝;连接走只读事务,并支持单条查询超时和结果行数上限(默认 10 万行,触顶即取消)。
03|能查还不够:三组函数,接住三类现场问题
时序数据的查询,很少只是把原始记录画成一条曲线。要看趋势,得按分钟、小时或天聚合;要判断数据质量,得知道哪些时段其实没采到;要定位设备状态,又得取窗口两端的值。KaiwuDB Grafana 插件把这些场景做成了现成的查询模式,下面三组函数分别对应最常遇到的三类问题。
time_bucket:把密集的采样压成看得懂的趋势
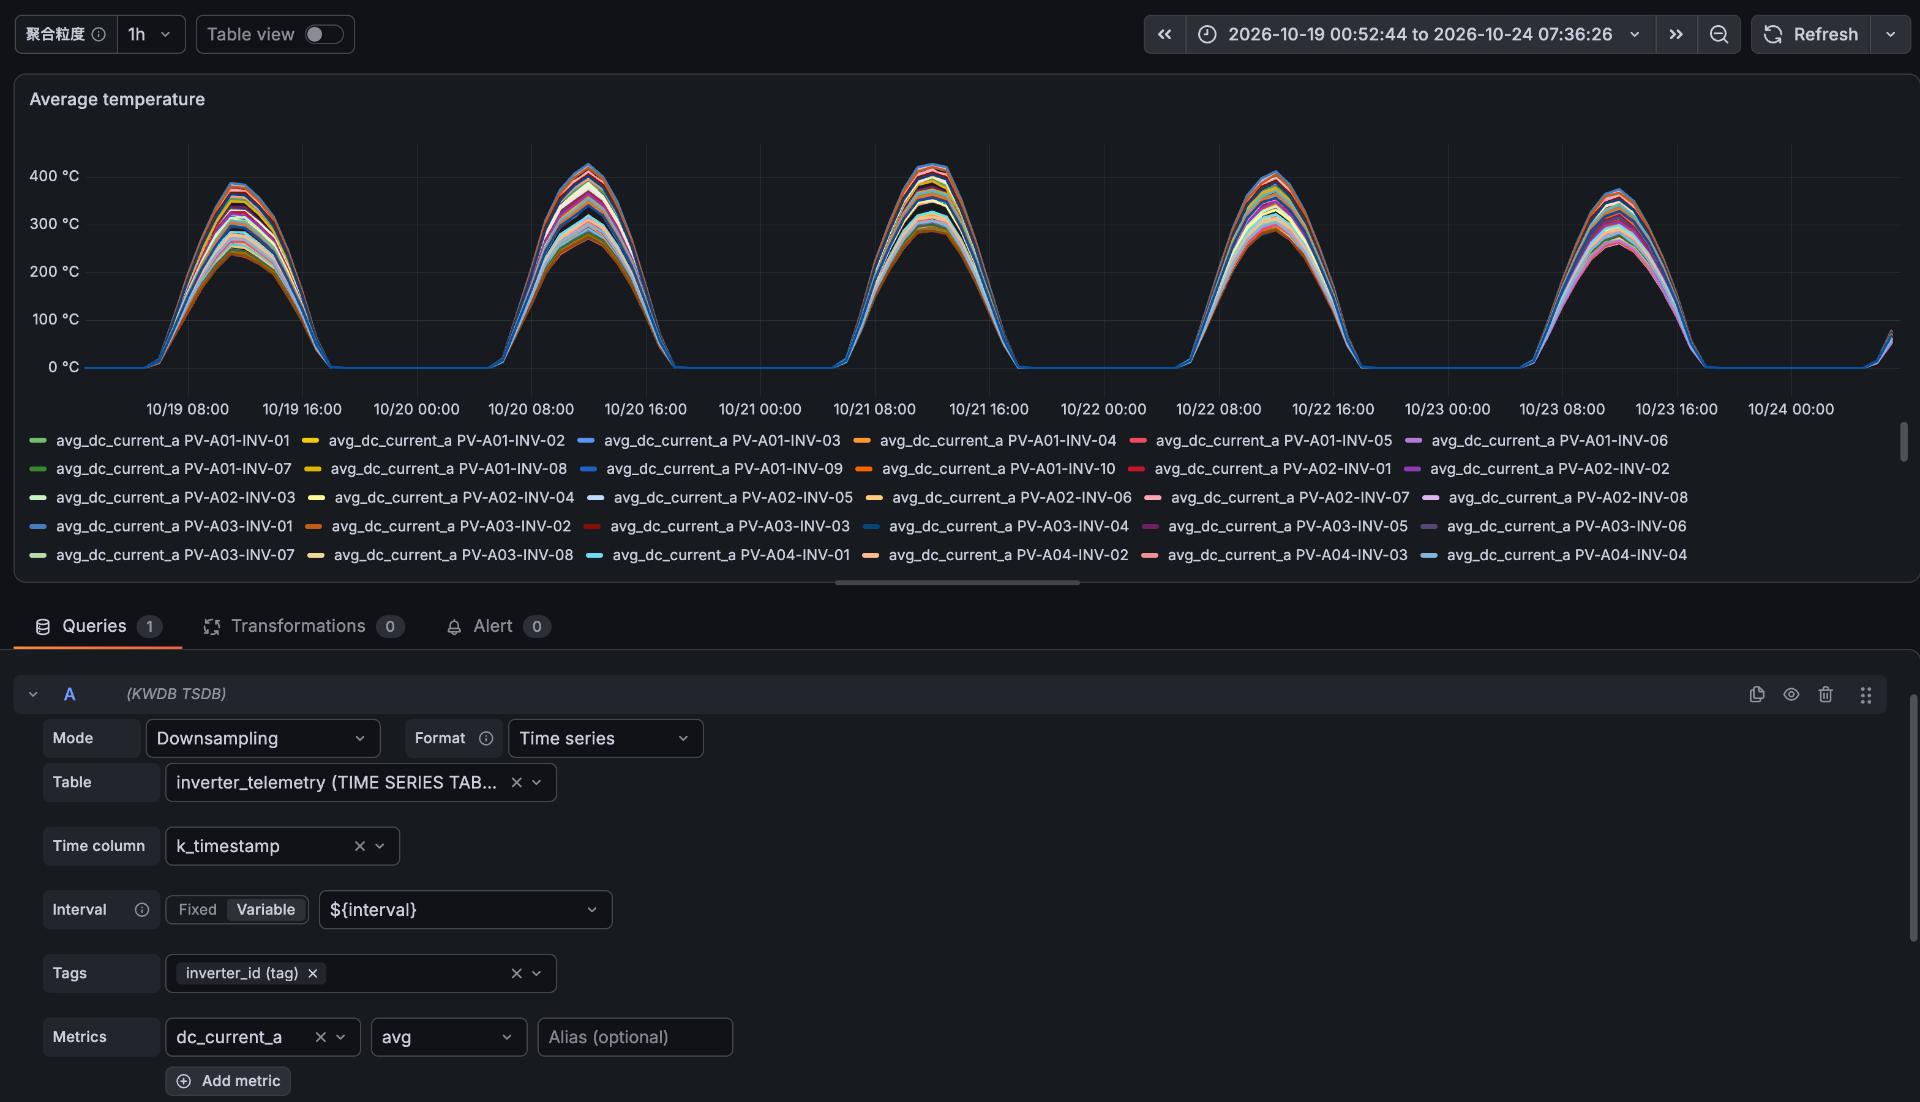
高频采样的原始记录直接画出来,往往密到看不出走势。我们可以把查询时间范围按 5 分钟切桶,再对每个桶取平均、最大值或最小值,曲线就变得可读;桶宽固定之后,不同设备、不同时间段的曲线可以放在一起对齐比较。这一步在插件里不必手写 SQL:降采样模式选好表、时间列、间隔和聚合方式(avg、sum、count、min、max 等)即可,间隔支持固定值、自适应值和看板变量,多个面板能保持同一聚合粒度。示意查询如下:
time_bucket_gapfill:让“没采到”和“没变化”分开
设备离线、网络抖动或采集链路短暂中断,都会造成某些时间段没有记录。如果只按已有数据绘图,曲线会直接跳过缺口,看上去像指标一直平稳——而真实情况可能是这一段时间根本没有数据。排查时最怕的,就是这种“看起来没问题”。
用 time_bucket_gapfill 按固定间隔生成连续的时间桶(该函数需与 GROUP BY 配合使用),再配合聚合或插值处理缺失区间,缺口就会在时间轴上占住位置。插值方式有 linear、prev、next、null 和 constant 五种,在补值模式里选即可。是否插值、采用什么策略补,要按业务口径决定。
last / first:取出窗口两端那个值
值班和复盘时,很多问题只需要两个数:这段时间的最新值是多少,开始时又是多少。插件的最新值模式直接支持 last、last_row、first、first_row,选好表和指标就能出结果;结果会按标签拆成多条序列,Stat、Gauge 面板里每台设备正好一个值,不必为每个面板另写子查询或补一层面板配置。举个例子,判断一台逆变器是仍在限发还是已经恢复,看窗口末值即可;判断它是否从某一刻开始恶化,则对比首末两个值。
04|一条完整链路:从原始采样到一块能值班的看板
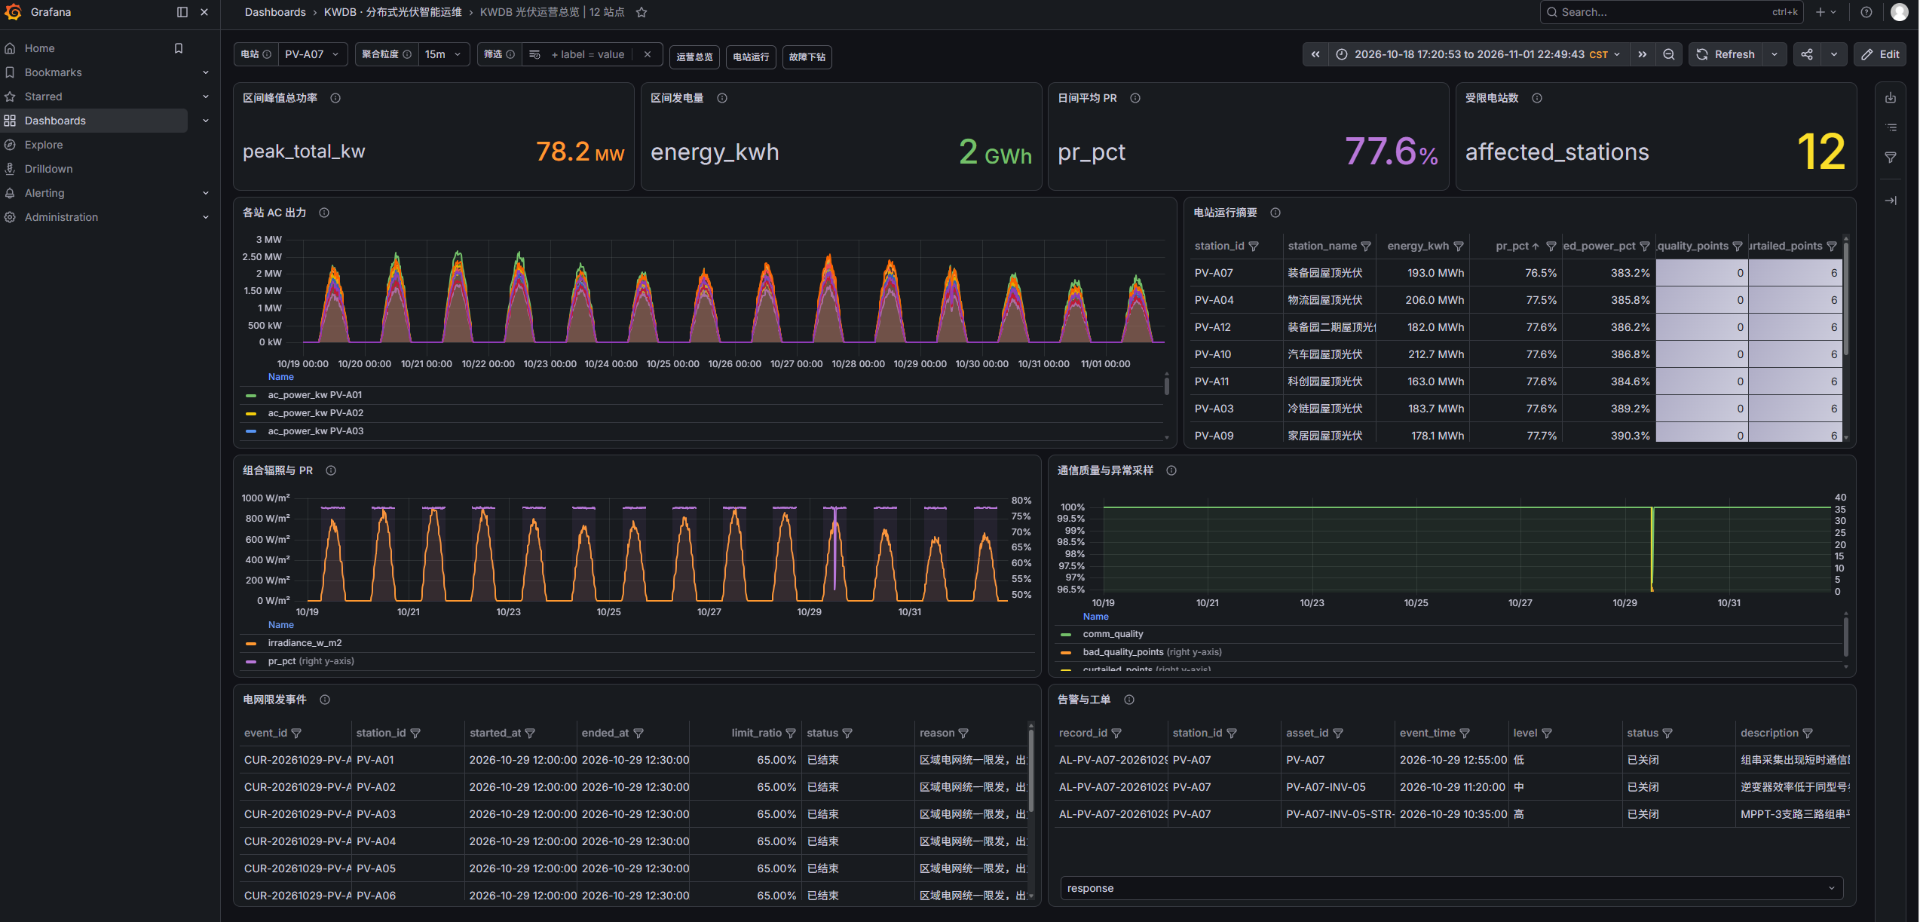
把上面的能力连起来,就是一块真正能值班的看板。就以光伏场站为例:先按时间窗口聚合看 AC 出力、发电量和 PR(性能比)的走势,再叠加辐照度判断出力变化是否符合资源条件,最后用通信质量与异常采样面板确认数据本身是否可信——三步下来,“设备出力下降”就能被拆成资源变差、限发或数据缺失几种不同原因。
在 Grafana 里,查询结果可以这样组织:
-
折线图:把 AC 出力、发电量、PR 多条曲线放在同一时间轴,观察趋势并相互印证;
-
表格:核对具体时间点的原始值,确认异常到底发生在哪一分钟;
-
统计面板:展示窗口内的最新值、平均值、最大值,作为看板顶部的摘要;
-
多面板看板:把设备状态、告警指标和业务指标放进同一视图,按场站、组串、设备逐层下钻。
如此一来分工很清晰:KaiwuDB 负责时序数据的存储查询以及不同业务数据间的跨模查询,Grafana 负责看板组织与呈现。对团队来说,省下的是三类成本——不必为新库重建一套可视化工具,不必为每个面板单独写适配 SQL,也不必在数据库、脚本和展示工具之间来回搬运数据。
时序数据的价值,不止于被存储,更在于能被看见、读懂并用于判断。KaiwuDB Grafana 数据源插件把 KaiwuDB 的时序查询能力接入团队熟悉的看板工作流:既保留 SQL 分析的灵活,也让降采样、缺失补值、窗口取值等常见操作更直观。数据无需绕经额外工具,就能从数据库走向趋势观察与运行监控,让变化更清晰、异常更容易追踪,也让时序数据真正进入日常业务视野。
欢迎前往官方仓库试用:
开源仓库:GitHub - KWDB/kwdb-grafana-plugin: Official KWDB datasource plugin for Grafana
评论(0)