上周,kwcli 开源首发:kwcli:开源一个 KaiwuDB 社区版的 CLI 工具
已收获 1 颗 Star (感谢葛爷,欢迎大家关注他的 DBCheck 项目)和 2 次 Fork。
KWCLI 是 KWDB 生态系统的 CLI 工具,可实现对 KWDB 组件(如 Playground 和单节点 KWDB)的一键安装、部署和生命周期管理。
这次 kwcli v0.1.1 更新,主要升级了三块内容:go 语言依赖升级版本;完善 SampleDB,新增了跨模查询场景、窗口函数示例;把 kwdb-tsbs 基准测cs试套件整个集成进了命令行,让性能压测也能一条命令启动。
这篇文章,我就从实测视角,带大家完整走一遍 kwcli v0.1.1 的新功能。
01. 一张表看更新
SampleDB 演示场景从 11 个扩充到 17 个,新增了一套完整的时序数据库基准测cs试工作流。
| 功能模块 | v0.1.0 | v0.1.1 | 变化 |
|---|---|---|---|
| 安装方式 | Makefile / 手动构建 | 新增 install.sh 一键安装 |
新增 |
| SampleDB 基础场景 | 6 个 | 6 个 | 保持 |
| SampleDB 跨模场景 | 0 个 | 4 个 | 新增 |
| SampleDB 窗口函数场景 | 5 个 | 7 个 | 新增 2 个 |
| SampleDB 分类筛选 | 无 | 支持 --category |
新增 |
| TSBS 基准测cs试 | 无 | init / load / run / list / clean | 新增 |
| TSBS 内置二进制 | 需额外安装 | 安装包已内置 | 优化 |
| Shell 自动补全 | 无 | bash / zsh / fish / powershell | 新增 |
| 单元测cs试覆盖 | 基础测cs试 | 新增 12 个用例 | 增强 |
关于作者:严少安, Oracle ACE, PostgreSQL ACE, KWDB MVP, 持有 KWCE, KWCP, KWCA 等认证。
公众号「少安事务所」,由 严少安 主笔,专注于数据 & AI 领域技术传播。
02. SampleDB 增加跨模查询场景
SampleDB 是 kwcli 里我个人最喜欢的一个组件。它不只是给你一张空表,而是直接搭好了一个智能电表的业务场景,从建库、造数到跑查询,一条龙服务。kwcli v0.1.1 在这个基础上,重点补了两块场景:跨模查询和窗口函数。
2.1 新增 4 个跨模查询场景
跨模查询是 KWDB 的核心卖点,但之前的 SampleDB 里居然没有相关示例。kwcli v0.1.1 这次加了 4 个场景:
| 场景名称 | 功能描述 |
|---|---|
| cross-mode-join | 关联时序数据与关系数据,分析电表与用户关联的用电行为 |
| cross-mode-user-power | 统计用户总用电量并排名,结合用户信息和区域信息 |
| cross-mode-alarm-analysis | 分析告警触发的时序数据,结合电表信息和用户信息 |
| cross-mode-region-comparison | 对比不同区域的用电情况,结合区域管理员信息 |
跨模查询的本质,就是在单条 SQL 里同时访问时序库(TSDB)和关系库(RDB)。KWDB 的多模架构允许你在同一个实例里同时跑 CREATE TS DATABASE 和 CREATE DATABASE,然后直接写 JOIN。这在传统架构里,你可能需要 ETL 把时序数据抽到关系库,或者应用层做两次查询再拼装,复杂度完全不是一个量级。
贴一段 cross-mode-user-power 场景背后的典型 SQL,感受一下:
SELECT
  mi.meter_id,
  u.user_name,
  a.area_name,
  COUNT(md.ts) AS reading_count,
  AVG(md.power) AS avg_power,
  SUM(md.energy) AS total_energy
FROM tsdb.meter_data md
JOIN rdb.meter_info mi ON md.meter_id = mi.meter_id
JOIN rdb.user_info u ON mi.user_id = u.user_id
JOIN rdb.area_info a ON mi.area_id = a.area_id
WHERE md.ts > NOW() - INTERVAL '1 day'
GROUP BY mi.meter_id, u.user_name, a.area_name, a.region
ORDER BY total_energy DESC
LIMIT 20;
这条 SQL 同时触及了三个库:tsdb.meter_data 存的是传感器时序读数,rdb.meter_info 存电表元数据,rdb.user_info 和 rdb.area_info 存用户和区域信息。在 KWDB 里,这就是一条普通 SQL,不需要额外的数据管道,也不需要应用层做拼装。对于物联网平台开发来说,这种能力能省掉不少中间件代码 🌻。
2.2 窗口函数场景扩充到 7 个
窗口函数是时序分析的利器。v0.1.1 在原有 5 个场景的基础上,新增了 2 个,总计达到 7 个:
| 场景名称 | 功能描述 |
|---|---|
| time-bucket-stats | 按 1 小时粒度统计重点电表的功率指标 |
| session-analysis | 以 30 分钟空闲间隔划分会话窗口 |
| voltage-state | 按是否高压切分连续区间,观察状态持续时间 |
| abnormal-current | 识别电流升高到 6A 及以上并回落到 5.3A 及以下的异常事件 |
| sliding-window | 每 12 条采样做窗口,以 6 条为滑动步长观察功率变化 |
| time-window-advanced | 使用时间窗口函数进行滑动统计 |
| count-window-example | 使用计数窗口进行滑动统计,每 50 条数据计算一次 |
这里 KWDB 支持的窗口函数类型非常丰富,不只是传统的时间窗口(time_bucket),还有会话窗口(session_window)、状态窗口(state_window)、事件窗口(event_window)、计数窗口(count_window)。对于设备告警、异常检测这类场景,状态窗口和事件窗口特别实用,能帮你把"连续异常"和"离散跳变"这两种模式都捕捉到。
2.3 分类筛选:告别大海捞针
场景多了,查找就成了问题。kwcli v0.1.1 给 sampledb list 加了 --category 参数,这是一个很贴心的体验优化:
# 查看所有基础查询场景
kwcli sampledb list --category basic

# 查看所有跨模查询场景
kwcli sampledb list --category cross-mode

# 查看所有窗口函数场景
kwcli sampledb list --category window
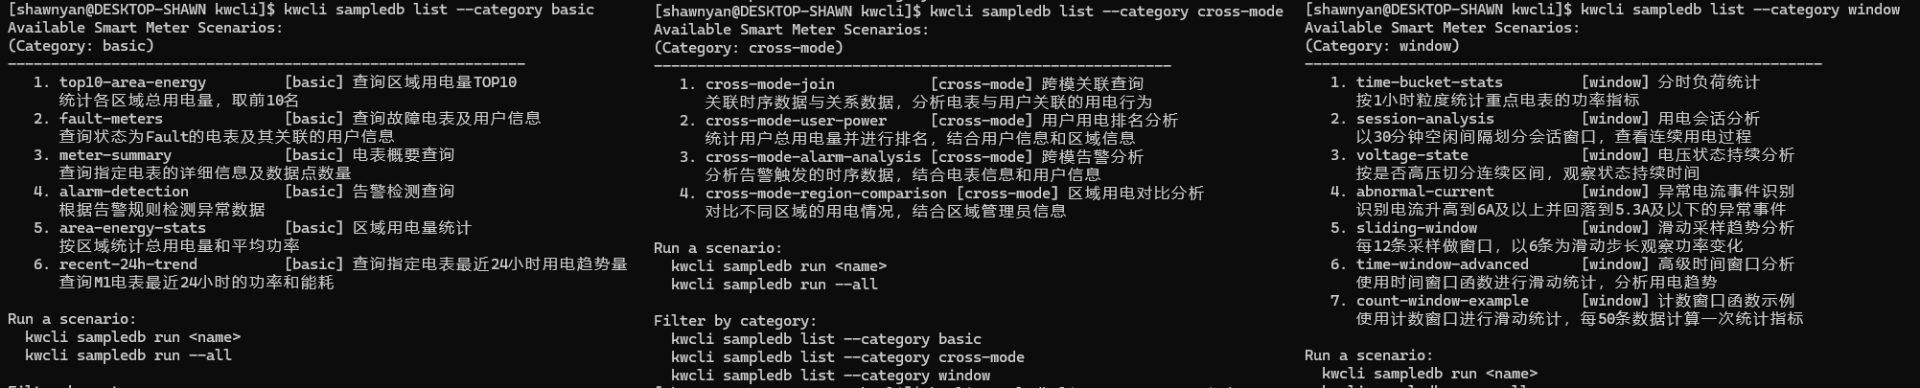
17 个场景现在被规整为三大类:
- basic(6 个):区域用电排名、故障电表查询、告警检测等基础分析
- cross-mode(4 个):时序库与关系库关联查询
- window(7 个):各类窗口函数高级分析
运行场景“窗口函数示例”。
[shawnyan@rl9 ~]# kwcli sampledb run count-window-example
=== 计数窗口函数示例 ===
-- 使用计数窗口进行滑动统计,每50条数据计算一次统计指标

  Executing: SELECT
Emulate Docker CLI using podman. Create /etc/containers/nodocker to quiet msg.
meter_id        window_start    window_end      sample_count    avg_voltage     avg_current     avg_power
M1      2026-02-27 18:58:44.665+00:00   2026-04-02 19:38:44.665+00:00   50      220     5.5     1000
M1      2026-03-17 03:38:44.665+00:00   2026-04-20 04:18:44.665+00:00   50      220     5.49    1000
M1      2026-04-03 12:18:44.665+00:00   2026-05-07 12:58:44.665+00:00   50      220     5.51    1000
M1      2026-04-20 20:58:44.665+00:00   2026-05-07 12:58:44.665+00:00   25      220     5.52    1000
[shawnyan@rl9 ~]#
笔者实测,在一台已经装好 KWDB 的测cs试机上,从 sampledb init 到跑完所有 17 个场景,全程不到 10 分钟。对于要给领导做 Demo 或者快速验证 KWDB 能力的场景,这个效率非常可以 👉。
03. TSBS 集成:基准测cs试也能一条命令搞定
如果说 SampleDB 解决的是"快速体验"的问题,那这次新增的 TSBS 组件解决的就是"性能验证"的问题。
3.1 什么是 TSBS?
TSBS(Time-Series Benchmark Suite)原本是 TimescaleDB 推出的时序数据库基准测cs试框架,后来被各大时序数据库厂商广泛采用。kwdb-tsbs 是 KWDB 团队基于 TSBS 改编的专用版本,针对 KWDB 的 SQL 方言和协议做了适配。
kwcli v0.1.1 把 kwdb-tsbs 整个打包进来了,而且安装包已经内置了 TSBS 二进制,不需要额外安装。提供五个子命令:
| 命令 | 功能描述 |
|---|---|
kwcli tsbs init |
初始化基准测cs试,生成数据集和查询集 |
kwcli tsbs load |
将生成的数据加载到 KWDB |
kwcli tsbs run |
运行查询基准测cs试 |
kwcli tsbs list |
列出所有支持的查询类型 |
kwcli tsbs clean |
清理测cs试文件及数据库 |
3.2 支持三种使用案例
TSBS 内置了三种使用案例(Use Case),覆盖了最常见的时序场景:
cpu-only:模拟服务器 CPU 监控场景,包含 16 种查询类型:
| 查询类型 | 说明 |
|---|---|
| single-groupby-1-1-12 | 单分组聚合,1 个主机,1 个指标,12 小时 |
| single-groupby-5-1-12 | 单分组聚合,5 个主机,1 个指标,12 小时 |
| double-groupby-5 | 双分组聚合,5 个指标 |
| high-cpu-1 | 高 CPU 查询,1 个主机 |
| single-groupby-1-1-1 | 单分组聚合,1 个主机,1 个指标,1 小时 |
| cpu-max-all-1 | CPU 最大值的最大值,1 个主机 |
| double-groupby-all | 双分组聚合,全部指标 |
| single-groupby-5-8-1 | 单分组聚合,5 个主机,8 个指标,1 小时 |
| cpu-max-all-32-24 | CPU 最大值,32 个主机,24 小时 |
| double-groupby-1 | 双分组聚合,1 个指标 |
| lastpoint | 最后一点查询 |
| single-groupby-1-8-1 | 单分组聚合,1 个主机,8 个指标,1 小时 |
| single-groupby-5-1-1 | 单分组聚合,5 个主机,1 个指标,1 小时 |
| cpu-max-all-8 | CPU 最大值的最大值,8 个主机 |
| groupby-orderby-limit | 分组排序限制查询 |
| high-cpu-all | 高 CPU 查询,全部主机 |
devops:运维监控综合场景,同样包含 16 种查询类型,覆盖主机、指标、时间窗口的多维度组合。
iot:物联网传感器场景,包含 13 种查询类型,更贴近车联网、设备追踪等业务:
| 查询类型 | 说明 |
|---|---|
| last-loc | 最后位置查询 |
| high-load | 高负载查询 |
| long-daily-sessions | 长时间日常会话 |
| avg-daily-driving-duration | 平均每日驾驶时长 |
| daily-activity | 日常活动 |
| breakdown-frequency | 故障频率 |
| single-last-loc | 单设备最后位置 |
| low-fuel | 低燃料查询 |
| stationary-trucks | 静止卡车 |
| long-driving-sessions | 长时间驾驶会话 |
| avg-vs-projected-fuel-consumption | 平均 vs 预计燃油消耗 |
| avg-daily-driving-session | 平均每日驾驶会话 |
| avg-load | 平均负载 |
3.3 完整压测流程实操
下面是一段从数据生成到查询测cs试的完整流程,可以直接复制粘贴运行:
# 1. 初始化基准测cs试
#    use-case=cpu-only:CPU 监控场景
#    scale=10:10 个设备
#    queries=1000:生成 1000 条查询语句
kwcli tsbs init --use-case=cpu-only --scale=10 --queries=1000

# 2. 查看可用查询类型(可选,了解这次生成了哪些查询)
kwcli tsbs list

# 3. 加载数据到 KWDB
#    默认连接参数:host=127.0.0.1, port=26257, user=root, password=root
kwcli tsbs load --file=/tmp/tsbs_data --host=127.0.0.1 --port=26257 --user=root --password=root

# 4. 运行查询基准测cs试
kwcli tsbs run --file=/tmp/tsbs_queries --host=127.0.0.1 --port=26257

# 5. 清理测cs试文件及数据库(可选)
kwcli tsbs clean --drop-db
输出结果:
[shawnyan@DESKTOP-SHAWN kwcli]$ kwcli tsbs init --use-case=cpu-only --scale=10 --queries=1000
=== Step 1/2: Generating benchmark data ===
Executing: /home/shawnyan/.kwcli/bin/tsbs_generate_data --use-case cpu-only --format kwdb --scale 10 --timestamp-start 2024-01-01T00:00:00Z --timestamp-end 2024-01-02T00:00:00Z --log-interval 10s --file /tmp/tsbs_data

✓ Data generation completed!
  Data file: /tmp/tsbs_data

=== Step 2/2: Generating query files ===
Executing: /home/shawnyan/.kwcli/bin/tsbs_generate_queries --use-case cpu-only --format kwdb --scale 10 --timestamp-start 2024-01-01T00:00:00Z --timestamp-end 2024-01-02T00:00:00Z --queries 1000 --query-type double-groupby-5 --file /tmp/tsbs_queries
KWDB mean of 5 metrics, all hosts, random 12h0m0s by 1h: 1000 points

✓ Query generation completed!
  Query file: /tmp/tsbs_queries
  Meta file:  /tmp/tsbs_queries.meta

=== Initialization Complete ===
Use Case:     cpu-only
Scale:        10 devices
Time Range:   2024-01-01T00:00:00Z to 2024-01-02T00:00:00Z
Queries:      1000

Next steps:
  1. Load data:      kwcli tsbs load --file=/tmp/tsbs_data
  2. Run queries:   kwcli tsbs run --file=/tmp/tsbs_queries
[shawnyan@DESKTOP-SHAWN kwcli]$ kwcli tsbs list
Available TSBS Query Types:
------------------------------------------------------------
  cpu-max-all                    Maximum CPU usage across all devices
  cpu-max-by-host                Maximum CPU usage per host
  double-groupby                 Group by two fields
  groupby-time                   Group by time interval
  high-cpu-all                   Find all high CPU readings
  high-cpu-by-host               Find high CPU per host
  lastpoint                      Get last reading per device
  multi-measure-query-all        Query multiple measures
  multi-measure-where            Query with WHERE clause
  single-groupby-agg             Single group with aggregation
  single-groupby-agg-five        Five groupings with aggregation
  single-groupby-agg-max         Max aggregation per group
  single-groupby-agg-min         Min aggregation per group
  single-groupby-raw             Raw data per group
  time-range                     Query time range
  time-series-all                All time series data

Examples:
  kwcli tsbs generate-queries --use-case=cpu --query-type=double-groupby
  kwcli tsbs generate-queries --use-case=iot --query-type=threshold
[shawnyan@DESKTOP-SHAWN kwcli]$ kwcli tsbs load --file=/tmp/tsbs_data --host=127.0.0.1 --port=26257 --user=root --password=root
Executing: /home/shawnyan/.kwcli/bin/tsbs_load_kwdb --host 127.0.0.1 --port 26257 --user root --pass root --db-name benchmark --file /tmp/tsbs_data --batch-size 10000 --workers 4 --partition false --insert-type insert
time,per. metric/s,metric total,overall metric/s,per. row/s,row total,overall row/s

Summary:
loaded 950400 metrics in 0.163sec with 4 workers (mean rate 5821293.53 metrics/sec)
loaded 86400 rows in 0.163sec with 4 workers (mean rate 529208.50 rows/sec)

Data loading completed!
[shawnyan@DESKTOP-SHAWN kwcli]$ kwcli tsbs run --file=/tmp/tsbs_queries --host=127.0.0.1 --port=26257
Auto-detected query type: double-groupby-5
Executing: /home/shawnyan/.kwcli/bin/tsbs_run_queries_kwdb --host 127.0.0.1 --port 26257 --user root --pass root --db-name benchmark --file /tmp/tsbs_queries --query-type double-groupby-5 --workers 4
SELECT time_bucket(k_timestamp, '3600s') as k_timestamp, hostname, avg(usage_user), avg(usage_system), avg(usage_idle), avg(usage_nice), avg(usage_iowait) FROM benchmark.cpu WHERE k_timestamp >= '2024-01-01 04:37:47.862' AND k_timestamp < '2024-01-01 16:37:47.862' GROUP BY hostname, time_bucket(k_timestamp, '3600s') ORDER BY hostname, time_bucket(k_timestamp, '3600s')
...
After 1000 queries with 4 workers:
Interval query rate: 461.73 queries/sec Overall query rate: 420.81 queries/sec
KWDB mean of 5 metrics, all hosts, random 12h0m0s by 1h:
min:     5.18ms, med:     9.01ms, mean:     9.43ms, max:   44.25ms, stddev:     2.78ms, sum:   9.4sec, count: 1000
all queries                                            :
min:     5.18ms, med:     9.01ms, mean:     9.43ms, max:   44.25ms, stddev:     2.78ms, sum:   9.4sec, count: 1000

Run complete after 1000 queries with 4 workers (Overall query rate 420.20 queries/sec):
KWDB mean of 5 metrics, all hosts, random 12h0m0s by 1h:
min:     5.18ms, med:     9.01ms, mean:     9.43ms, max:   44.25ms, stddev:     2.78ms, sum:   9.4sec, count: 1000
all queries                                            :
min:     5.18ms, med:     9.01ms, mean:     9.43ms, max:   44.25ms, stddev:     2.78ms, sum:   9.4sec, count: 1000
wall clock time: 2.385152sec

Query benchmark completed!
[shawnyan@DESKTOP-SHAWN kwcli]$ kwcli tsbs clean --drop-db
Deleted: /tmp/tsbs_data
Deleted: /tmp/tsbs_queries
Dropping database 'benchmark' on 127.0.0.1:26257...
Database 'benchmark' dropped.
TSBS clean completed.
[shawnyan@DESKTOP-SHAWN kwcli]$
注意几个细节:
--use-case现在支持cpu-only、devops、iot三种- KWDB 默认端口是 26257
- 新增了
kwcli tsbs clean --drop-db,压测完可以一键清场,不用手动删库 kwcli tsbs load新增了--partitionflag,默认关闭,适用于单节点。当你需要在多节点集群运行测cs试时,可以开启表分区--partition选项。
# 默认不启用分区(单节点环境安全)
kwcli tsbs load --file=/tmp/tsbs_data

# 可手动开启
kwcli tsbs load --file=/tmp/tsbs_data --partition
笔者建议,生产环境压测时把 scale 拉到更大(比如 1000 甚至 10000),同时调整 --workers 参数来控制并发度。硬件方面,压测节点建议至少 16 核 CPU、32GB 内存、SSD 存储,这样才能把 KWDB 的吞吐能力压出来,而不是让测cs试机本身成为瓶颈。
04. 未完待续
本次更新 kwcli 还增加了命令补全功能。敲 kwcli sa<TAB> 就能自动补全出 sampledb,再敲 kwcli sampledb i<TAB> 就能补全出 init。对于子命令和参数比较多的 CLI 来说,这个体验提升是实实在在的。
kwcli 比较容易上手,help 信息也尽量补全了,希望后面有时间继续更新维护。欢迎大家转发、留言反馈。
最近建了一个 DB+AI 的唠嗑群,大家扫码入就好。
如果需要让 AI 更懂 kwdb,现阶段 kwdb skills 应该是绕不开的,下期聊聊。
相关资料
kwcli 源码仓库:
https://github.com/shawn0915/kwcli
国内镜像,AtomGit | GitCode:
https://gitcode.com/mydb/kwcli
国内镜像,Gitee:
https://gitee.com/shawnyan/kwcli
一键安装:
curl -sL https://raw.githubusercontent.com/shawn0915/kwcli/main/install.sh | bash
SampleDB 依赖于 KWDB 开源项目:
https://github.com/KWDB/SampleDB
相关介绍:KaiwuDB社区版KWDB SampleDB上新:新增窗口函数示例
TSBS 依赖于 KWDB 开源项目:
https://github.com/KWDB/kwdb-tsbs
Have a nice day ~ ☕
🌻 往期内容 ▼
- 转载:数据库一体机简史 7
- 金仓数据库KingbaseES V9 Oracle兼容版全解析(2026版)
- Oracle Skills开源:AI工程正在进入"技能时代"
- IvorySQL-Skills:开源一套自用IvorySQL数据库Skills
- HOW2026复盘分享:晨章数据EloqData的NVMe+协程实践
- HOW2026大会:PostgreSQL与AI在泉城济南的硬核碰撞
- AWS What's Next峰会全复盘;开启AI操作系统时代,OpenAI正式“入驻”AWS生态
- MySQL 8.0结束生命周期,8.4.9 LTS、9.7.0发版上线:一个时代的交接与新生
- 虚谷数据库发布了一个Skills剧透了新版本特性
- 金仓社区2周年了
- DBClaw与TRAE穿搭指南:数据库诊断工具的正确打开方式
- TiDB Radio | 平凯宇宙新鲜事儿 (2026.03.31)
- 告别古法部署,用 OpenClaw 安装 KaiwuDB 3.1.0 并体验新特性
- 官宣|星珩联盟,正式启航!
- 苦等三年!Oracle AI Database 26ai本地服务器版终于来了
👉 这里有得聊
如果对国产基础软件(操作系统、数据库、中间件)、AI、Vibe Coding、OpenClaw 、Hermes Agent 等感兴趣,可以加群一起聊聊。关注微信公众号:(少安事务所),后台回复[群],即可看到入口。如果这篇文章为你带来了灵感或启发,请帮忙『点赞、推荐、转发』吧,感谢!ღ( ´・ᴗ・` )~
评论(0)