1 概述
本章给出主要结论、问题界定与文档组织。
1.1 主要结论
结论一:Playground 缩短的是「复现鸿沟」,不是「数据库能力」。
它把一篇需要读者自行装 Docker、拉镜像、起服务的教程,压缩为一条安装命令加一次浏览器访问。以本文的跨模复现为例,读者从零到看到第一条跨模查询结果,所需的自有步骤从「装 Docker → 拉 KWDB 镜像 → 启动服务 → 建库建表 → 导入数据 → 连接查询」收敛为「装 Playground → 打开课程 → 在课程终端内执行查询脚本」。多的那一步(Playground 自身仍依赖 Docker)是它的前提,后面的步骤被它代办了。
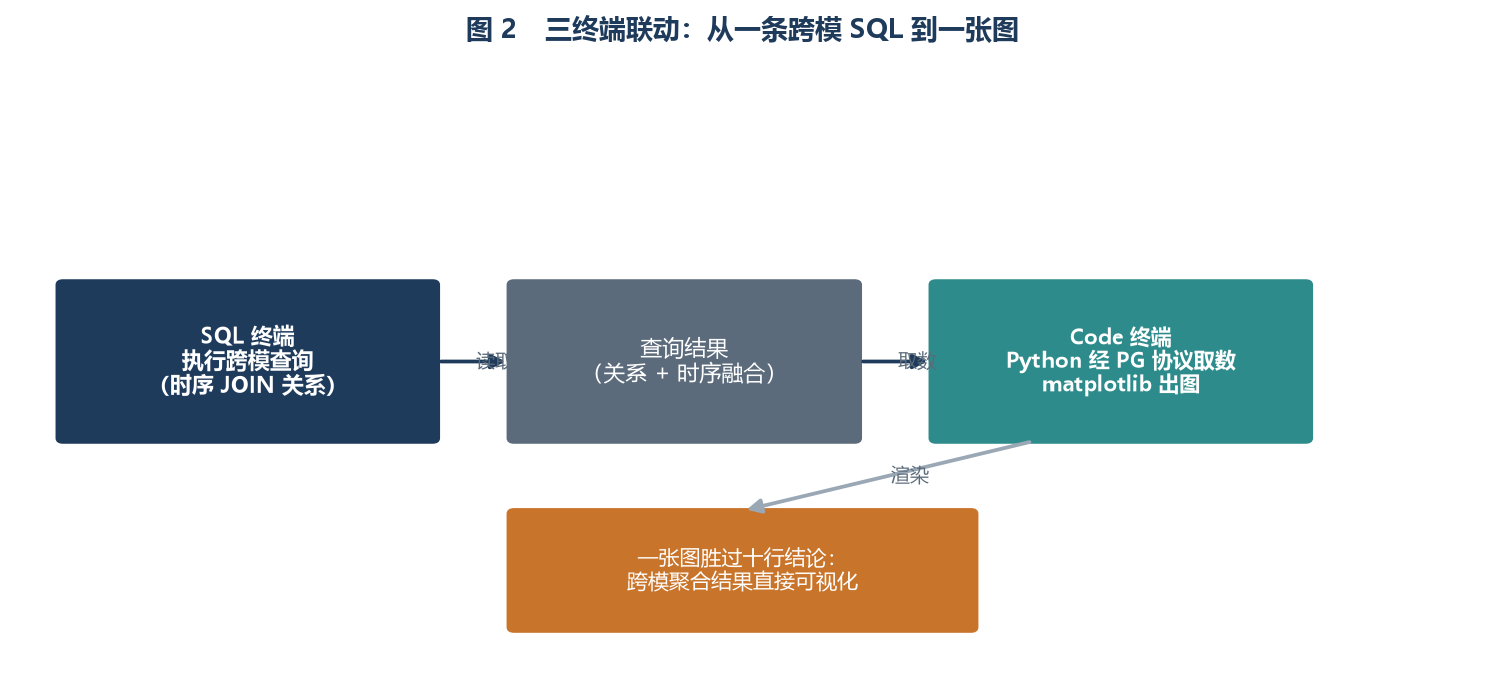
结论二:同一个容器内「SQL 终端 + Code 终端」同页联动,是把查询结果转成一幅图的最短路径。
跨模查询返回的是「多个分组 × 多个聚合列」的表格,逐行读表很难看出趋势。在 Code 终端里用 Python 读取同一批结果并绘图,只需一次取数、一次渲染;因为 SQL 与 Code 跑在同一隔离环境内,不存在跨机器拷贝结果这一环。这一点的价值是可读性,而非性能。
结论三:隔离与多会话是「可复现」的两个工程属性,其收益集中在教学与分享场景。
隔离保证环境用完即弃、互不污染;多会话保证实验可暂停、可恢复,读者不必一次跑完。两者都不提升单条查询的速度,但显著降低「读者中途放弃」的概率。相应地,Playground 的适用边界是教学、演示与复测验证,而非生产部署或压测。
三条结论的口径并不相同:结论一讲可达性,结论二讲可读性,结论三讲适用边界。三者的证据来源与适用条件都不同,不应被合并为「Playground 更好」这类笼统判断。
1.2 问题界定
一份技术文档能否被复现,取决于读者需要自行补齐多少前置条件。前置条件越多,中途出错的概率越高,文章的可信度就越依赖作者的「权威」而非「可验证」。
Playground 的定位正是把这段前置条件收进平台。它不改变 KWDB 的任何查询语义,也不改变跨模查询的代价结构;它改变的是「谁来准备环境」。因此本文讨论的对象是实验环境的可达性,不是数据库内核的优劣。
这类复现失败的根因通常不在数据库本身,而在前置条件的准备顺序与版本口径:报错指向查询,原因却落在环境。把原因简单归给「读者不会用」,既不利于知识传播,也不利于工具改进;把差异显性化、把环境标准化,才是更可维护的做法。
1.3 文档组织与复现路径
第 3 章介绍 Playground 的架构与安装;第 4 章在 Playground 内复现官方跨模示例;第 5 章做三终端联动出图;第 6 章做工程复盘;第 7 章给出复测取证单。各章对应的脚本以两位编号落在 reproduce/ 目录。
| 阶段 | 名称 | 产物 | 章节 |
|---|---|---|---|
| 00 | 安装 Playground | kwdb-playground 可执行文件 | 3.2 |
| 01 | 启动并进入跨模课程 | 隔离容器与已连接终端 | 4.1 |
| 02 | 建库建表与导入数据 | db_monitor、monitor_r 两库及其表 | 4.2 |
| 03 | 执行跨模查询 | 四组查询回显 | 4.3 |
| 04 | Code 终端出图 | 一张跨模聚合图 | 5.2 |
| 05 | 暂停 / 恢复校验 | 容器状态与数据留存 | 6.2 |
2 为什么技术分享需要「浏览器内可复现」的实验环境
本章讨论 Playground 这类工具要解决的工程问题。理解问题,才能判断它值不值得引入。
2.1 复现鸿沟:从「写得清」到「跑得通」的三道坎
一篇文章让读者「看懂」和让读者「跑通」,中间隔着三道坎:
-
环境坎:装什么版本、开什么端口、内存够不够。文档往往一句「请自行安装数据库」带过,读者在这一步的分歧最大。
-
数据坎:文章里的查询结果建立在某份数据之上,而读者手里没有这份数据。没有数据,SQL 写得再对也复现不出同一个结果。
-
连接坎:客户端与数据库协议、认证方式、库名与端口不一致,报错信息却指向查询本身,把读者引向错误方向。
Playground 对这三道坎的处理是:用容器代答环境坎;用「课程」把数据与查询打包,代答数据坎;用预置的终端会话代答连接坎。读者要做的,退化为「照抄命令、看结果」。
2.2 隔离、即弃、多会话:三个工程属性的价值
这三个属性经常被并列提及,但解决的问题不同,需要分开评估。
隔离:每个访客拿到独立环境。它解决的是「多人共用一台机器时互相踩」的问题——A 读者改了配置,不应影响 B 读者。
即弃:会话结束容器回收。它解决的是「实验残留」的问题——跑完不留脏数据,下次仍是干净的起点。这一点对可复现尤其关键:干净起点意味着「同样输入得到同样输出」的前提成立。
多会话:环境可暂停、可恢复。它解决的是「一次跑不完」的问题——建表导入这类耗时步骤只需做一次,之后可反复进入继续验证。
三者的共同点是:都不改变查询速度,只改变「读者跑通的难度」。三者之间也并非简单叠加:隔离与即弃解决的是起点问题,多会话解决的是过程问题。起点不干净,结论无法归因;过程不可中断,复现容易半途而废。分清这一点,才能判断在具体场景里该优先补哪一项,而不是遇到「跑不通」就把原因归给工具。
2.3 适用边界
需要如实说明 Playground 不适合做什么,否则会误导读者:
它不是生产部署工具。生产环境的持久化、高可用、备份恢复不在其设计目标内。
它不是压测平台。容器资源受限,得出的时延数字不能代表生产服务器的性能。
它仍需 Docker 作为前置。所谓「零安装」指的是读者不必手动装数据库,而不是连 Docker 都不用装。
把批评定位在「量程边界」而非「缺陷」,是这个工具定位本身决定的:它解决的是可达性,不是性能。
2.4 三个属性为什么共同指向「可复现」
复现失败的原因往往不是某一个错误,而是一类隐性的差异。读者以为自己的环境与作者一致,实际在版本、数据、配置上已经偏离。隔离的价值在于把「环境一致」从读者的责任转为平台的责任。这是根因层面的处理:它消除的不是某个具体故障,而是产生故障的那类不确定性。
即弃与多会话分别对应复现过程的两端。即弃保证起点干净:起点若被上一次实验污染,读者得到的差异就无法归因,究竟是数据不同还是语句不同,无从判断。多会话保证过程可中断:长实验一旦中断就要重来,重来又会引入新的差异,这是读者中途放弃的常见原因。
需要如实说明的是三者的代价。环境交给平台后,读者对底层参数的直接掌控变弱,排查问题时能动的旋钮变少。这个取舍是否值得,取决于目标:若目标是让不确定的读者稳定得到同一结论,代价可以接受;若目标是精细调优或压测,则应当改用本地容器。这条边界与第 6 章的结论一致——Playground 管可达性,不管极限性能。
3 KWDB Playground 是什么、怎么装
3.1 架构与三类终端
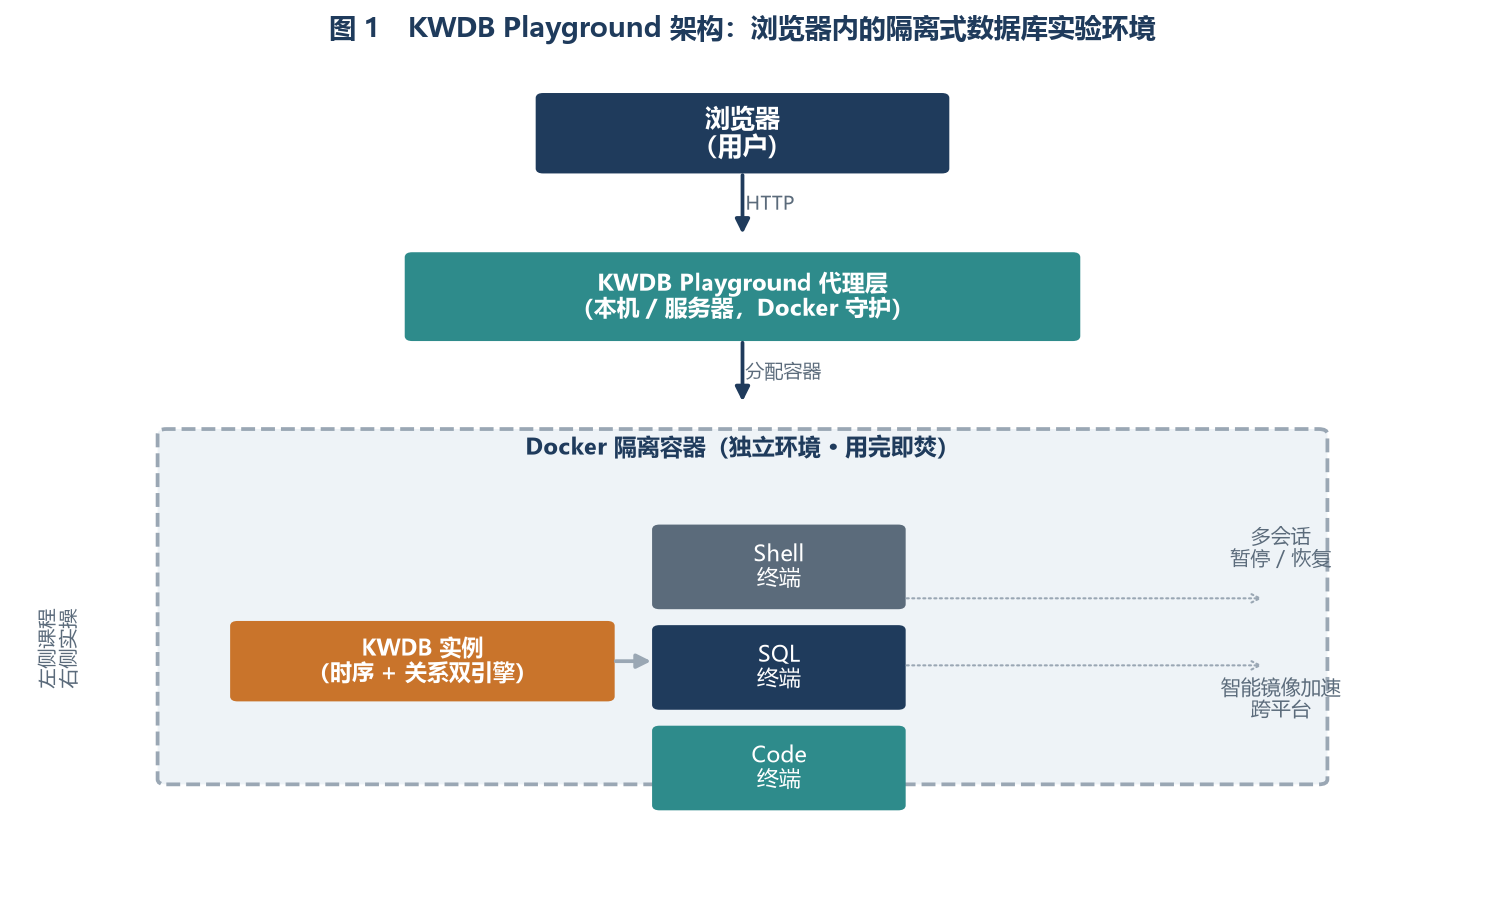
Playground 由三部分组成:浏览器前端、本机(或服务器)上的代理层、以及每个访客独享的 Docker 容器。代理层负责分配容器、转发终端输入输出;容器内运行 KWDB 实例与终端会话。
课程详情页按课程类型提供三类交互区域。经实测(v1.4.3),终端类型由课程元数据决定,并非每门课程都三件套齐全:
| 终端类型 | 用途 | 本文用到的能力 | 实测对应课程 |
|---|---|---|---|
| Shell | 命令行交互,起服务、查状态 | 启动 KWDB、建库导入(第 4 章) | multi-mode(跨模查询) |
| SQL | 执行 SQL 并查看结果 | SQL 终端直连查询 | sql(SQL 终端快速体验 KWDB)、data-query(数据查询) |
| Code | 编写并运行 Python/Bash/Java | 取数并绘图(第 5 章) | python-kwdb(Python 连接 KWDB)、java-kwdb(Java 连接 KWDB) |
3.2 安装与启动
环境要求:本机已安装并运行 Docker(Docker Desktop 或 Docker Engine)。
# 一键安装(默认最新版本)
curl -fsSL https://kwdb.tech/playground.sh | bash
# 启动服务
kwdb-playground start
启动后,用浏览器访问 http://localhost:3006,进入课程列表。
提示:安装脚本支持 --version v1.4.3 指定版本、--source atomgit 指定下载源。网络访问 GitHub 不稳时,指定 AtomGit 源通常更可靠。
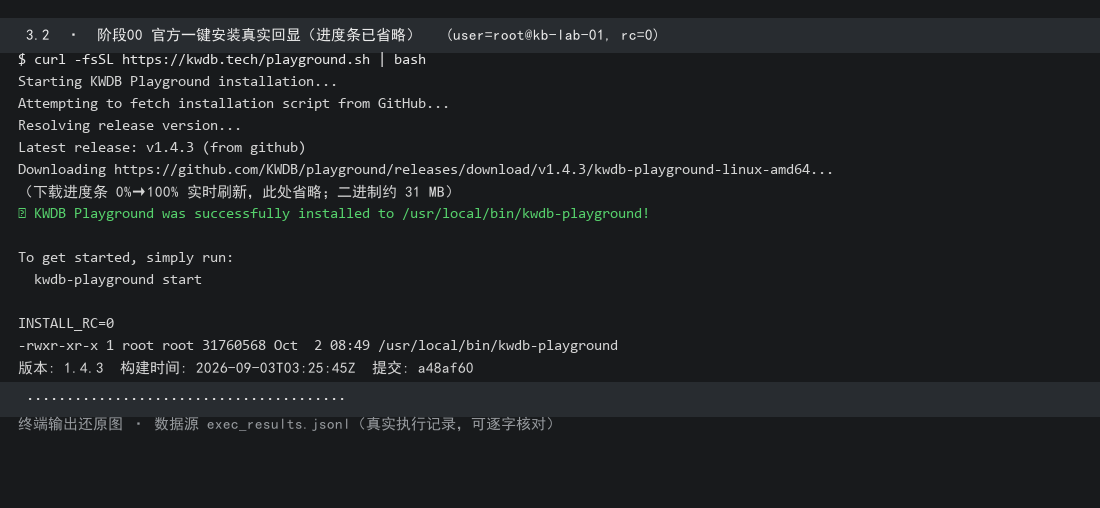
实测输出(阶段 00,实验机 kb-lab-01):
$ curl -fsSL https://kwdb.tech/playground.sh | bash
Starting KWDB Playground installation...
Attempting to fetch installation script from GitHub...
Resolving release version...
Latest release: v1.4.3 (from github)
Downloading https://github.com/KWDB/playground/releases/download/v1.4.3/kwdb-playground-linux-amd64...
(下载进度条 0%→100% 实时刷新,此处省略;二进制约 31 MB)
✅ KWDB Playground was successfully installed to /usr/local/bin/kwdb-playground!
To get started, simply run:
  kwdb-playground start
INSTALL_RC=0
$ ls -l /usr/local/bin/kwdb-playground
-rwxr-xr-x 1 root root 31760568 Oct 2 08:49 /usr/local/bin/kwdb-playground
$ kwdb-playground version
版本: 1.4.3 构建时间: 2026-09-03T03:25:45Z 提交: a48af60
回显显示:脚本自动解析出最新版本 v1.4.3 并从 GitHub Releases 下载二进制,安装至 /usr/local/bin/kwdb-playground(约 30 MB),退出码 0。版本号是判据的核心——后文所有"实测 v1.4.3"的表述均以此为准。
3.3 课程与环境隔离机制
进入课程后,Playground 为当前访客启动一个隔离容器,并把课程定义的初始数据与脚本注入其中。镜像来自多源(Docker Hub、ghcr.io、阿里云),启动前可做连通性测试并优选最快通道。
注意:请在启动容器前确认 Docker 守护进程处于运行状态,否则课程页会停留在「环境准备中」。
实测输出(阶段 01,实验机 kb-lab-01):
$ kwdb-playground start --no-open
守护进程启动成功,PID=32461,日志=logs/daemon.log,PID文件=tmp/kwdb-playground.pid
$ ss -lntp | grep 3006
LISTEN 0 4096 [::]:3006 [::]:* users:(("kwdb-playground",pid=32461,fd=8))
$ curl -sS -o /dev/null -w "HTTP %{http_code}" http://127.0.0.1:3006/
HTTP 200
守护进程监听 3006,首页返回 HTTP 200,课程列表共 12 门。
镜像源可达性(实测,决定课程容器能否创建):
$ curl -o /dev/null -w 'HTTP %{http_code} (%{time_total}s)\n'
https://crpi-...aliyuncs.com/v2/
HTTP 401 (0.232s) # 阿里云 ACR:可达(401 为未鉴权的正常响应)
$ curl -o /dev/null -w 'HTTP %{http_code} (%{time_total}s)\n' https://ghcr.io/v2/
HTTP 401 (0.705s) # ghcr.io:可达
$ curl -o /dev/null -w 'HTTP %{http_code} (%{time_total}s)\n' https://registry-1.docker.io/v2/
curl: (7) Failed connect to registry-1.docker.io:443 HTTP 000 (8.006s)
                                  # Docker Hub:不可达
这是一处实测发现的必踩坑:实验机可正常访问 kwdb.tech,但 Docker Hub(registry-1.docker.io)超时。若按默认源启动课程,容器创建会失败。解决方式是在启动课程时指定可达镜像源(本文用阿里云 ACR):
curl -X POST http://127.0.0.1:3006/api/courses/multi-mode/start \
  -H 'Content-Type: application/json' \
  -d '{"image":"crpi-9ix5pwqh4t79xf4r.cn-shanghai.personal.cr.aliyuncs.com/kaiwudb/kwdb:latest"}'
启动成功后 docker ps 可见隔离容器:
kwdb-playground-multi-mode-1790890873878351895 | .../kaiwudb/kwdb:latest |
Up 6 seconds
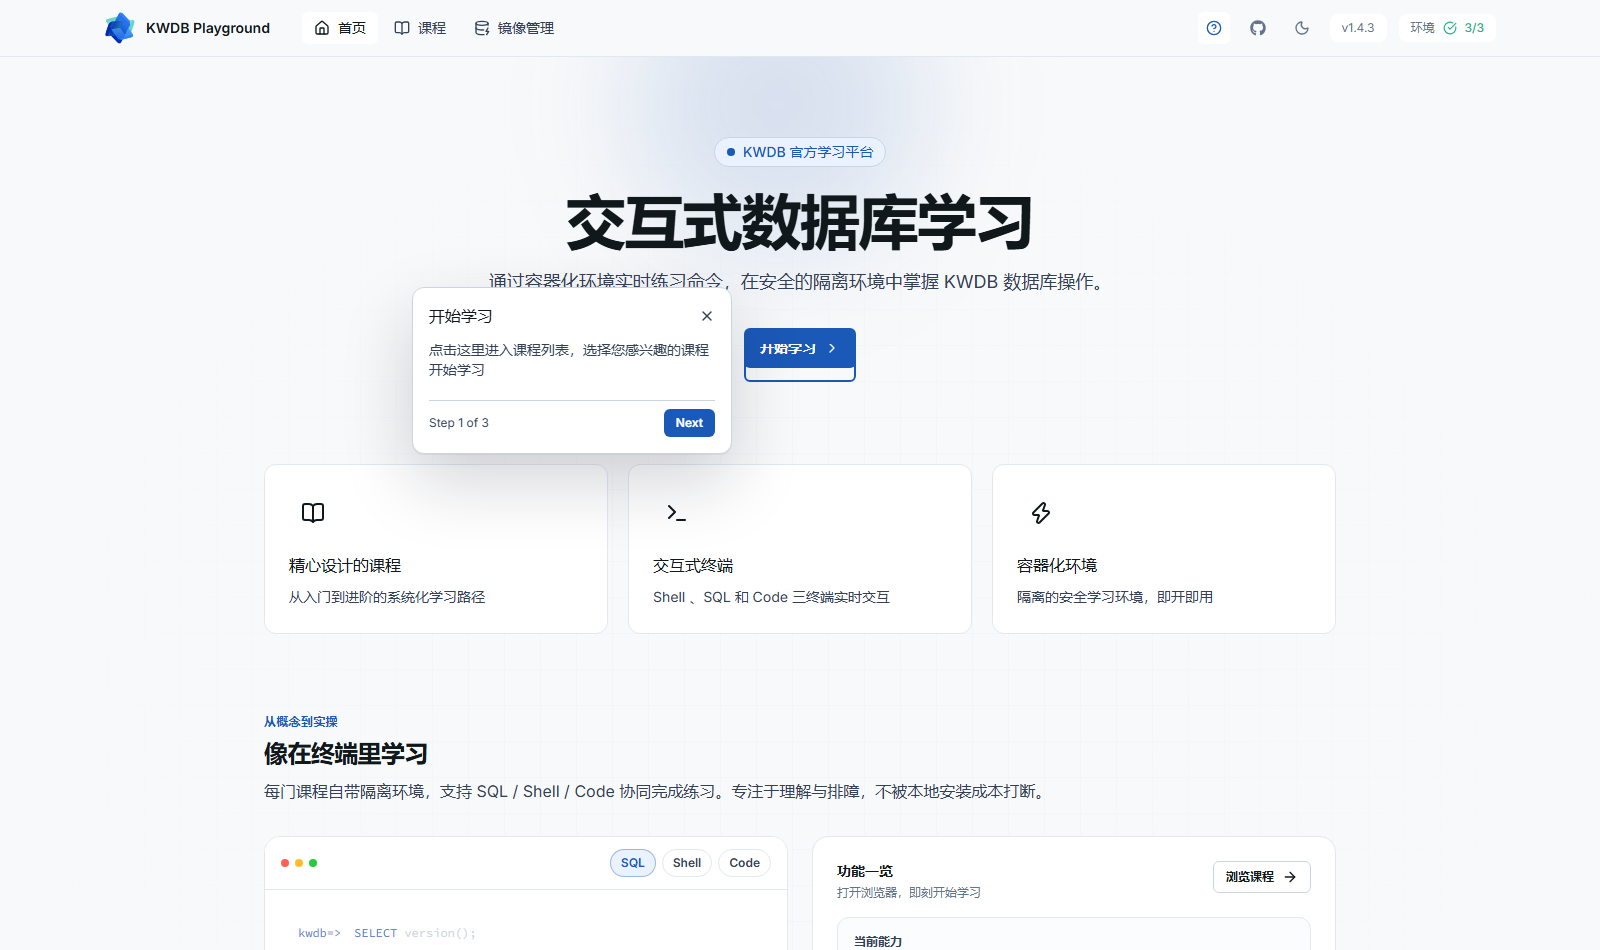
复测证据图 2 证明服务已启动、课程可进入、环境检查通过。(页面右上角显示「环境 3/3」检查项全绿)
4 在 Playground 里复现跨模查询
本章的 SQL 全部取自 KWDB 官方 SampleDB 的 multi-mode 示例,未做改写,以保证语法与语义与官方一致。
4.1 准备:进入课程容器终端
在课程列表中进入「跨模查询」(multi-mode)课程,点击「启动容器」,等待容器就绪后,右侧出现已连接的 Shell 终端(提示符形如 root@<容器ID>:/kaiwudb/bin#)。此时终端已连到一个可用的KWDB 实例。
注意(课程与终端类型的对应关系,实测 v1.4.3):课程元数据中「跨模查询」(multi-mode)为 Shell 终端课程(sqlTerminal=false、codeTerminal=false),本文的跨模 SQL 即在其 Shell 终端以 ./kwbase sql ... -e "..." 方式执行。具备 SQL 终端的是「SQL 终端快速体验 KWDB」(sql)与「数据查询」(data-query);具备 Code 终端的是「Python 连接 KWDB」(python-kwdb)与「Java 连接 KWDB」(java-kwdb)。若需 SQL/Code 终端,请选择上述对应课程。
场景说明:官方示例建模的是城市管网 IoT 场景。静态属性(业务实体、作业区域、场点、管线、测点)体量小,放关系引擎;实时测点数据体量大,放时序引擎。跨模查询的价值在于让两类数据在一条 SQL 内联合分析。
4.2 建库建表与导入数据
第一步建时序库与关系库。以下为官方示例的建表 SQL(保留原样):
-- 时序表:测点采集数据
CREATE TABLE db_monitor.t_monitor_point (
  k_collect_time timestamp NOT NULL,
  monitor_value double
) ATTRIBUTES (
    point_id varchar(64) NOT NULL,
    branch_id varchar(32),
    region_id varchar(16),
    site_id varchar(16),
    pipeline_id varchar(16) not null,
    monitor_type smallint,
    monitor_position varchar(64)
)
  PRIMARY TAGS(point_id)
  RETENTIONS 3h;
  -- 注:官方早期材料写作 ACTIVETIME 3h;KWDB 3.2.2 已改用 RETENTIONS。
  -- 照抄 ACTIVETIME 会报 `at or near "activetime": syntax error (42601)`。
  -- 逐变体实测见《复验报告》5.1 节。
-- 关系表:场点静态信息
CREATE TABLE monitor_r.site_info (
  site_id varchar(16) PRIMARY KEY,
  site_name varchar(80),
  region_id varchar(16),
  branch_id varchar(32),
  site_address varchar(64),
  site_desc varchar(128)
);
-- 关系表:作业区域信息
CREATE TABLE monitor_r.region_info (
  region_id varchar(16) PRIMARY KEY,
  region_name varchar(80),
  region_address varchar(64),
  region_desc varchar(128)
);
-- 关系表:管线信息
CREATE TABLE monitor_r.pipeline_info (
  pipeline_id varchar(16) PRIMARY KEY,
  pipeline_name varchar(60),
  pipe_start_point varchar(80),
  pipe_end_point varchar(80),
  pipe_spec varchar(30)
);
-- 关系表:测点静态信息
CREATE TABLE monitor_r.point_base_info (
  point_id varchar(64) PRIMARY KEY,
  signal_id varchar(120),
  signal_desc varchar(200),
  signal_type varchar(50),
  site_id varchar(16),
  pipeline_id varchar(16)
);
导入数据(官方示例以 CSV 方式生成并导入;脚本包在容器模式下会先 docker cp 再 docker exec 执行):
import into db_monitor.t_monitor_point CSV DATA
("nodelocal://1/t_monitor_point");
import into monitor_r.site_info CSV DATA
("nodelocal://1/site_info/site_info.csv");
import into monitor_r.region_info CSV DATA
("nodelocal://1/region_info/region_info.csv");
import into monitor_r.pipeline_info CSV DATA
("nodelocal://1/pipeline_info/pipeline_info.csv");
import into monitor_r.point_base_info CSV DATA
("nodelocal://1/point_base_info/point_base_info.csv");
注意:导入前请确认数据目录已就位。重复导入会叠加行数,导致后续聚合结果虚高。脚本包采用检测优先策略——目标库已有数据时只校验行数、不做 DROP;仅在显式设置 KWDB_FORCE_RELOAD=1 时才重建,以免误删存量数据。
实测输出(阶段 02,Playground 课程容器内):
root@16c43184e37d:/kaiwudb/bin# bash generate_data.sh
(生成 5 张关系表 + 1 张时序表 CSV 至 kwbase-data/extern/)
root@16c43184e37d:/kaiwudb/bin# ./kwbase start-single-node --insecure \
    --listen-addr=0.0.0.0:26257 --http-addr=0.0.0.0:8080 --store=./kwbase-data --background
root@16c43184e37d:/kaiwudb/bin# ./kwbase sql --insecure --host=127.0.0.1 -e
'SELECT version();'
KaiwuDB 3.2.2 (x86_64-pc-linux-gnu, built 2026/08/05 01:31:25, go1.21.13, gcc
7.4.0)
root@16c43184e37d:/kaiwudb/bin# ./kwbase sql --insecure --host=127.0.0.1 <
create_load.sql
(建库建表 + import into ... CSV DATA;job status = succeeded)
导入完成后核验行数:
$ ./kwbase sql --insecure --host=127.0.0.1 -e 'SELECT count(*) AS points FROM db_monitor.t_monitor_point;'
points
10000
课程容器的样本规模:时序表 10,000 行,关系表 point_base_info 1,500 行、site_info 436 行、region_info 41 行、pipeline_info 26 行、operation_branch 8 行——与官方课程说明的「8 实体 / 41 区域 / 436 场点 / 26 管线 / 1500 测点」口径一致。
对照:另一台裸 KWDB 实例(kb-lab-01,KaiwuDB CCL 3.2.2)——同一套建表语句、不同数据规模,用于后文双向印证:
$ kwbase sql --certs-dir=/etc/kaiwudb/certs \
    --url="postgresql://root@kb-lab-01:26257/defaultdb?sslmode=verify-full" <
02_verify.sql
database_name engine_type
db_monitor TIME SERIES
monitor_r RELATIONAL
tbl rows
db_monitor.t_monitor_point 2000000
monitor_r.site_info 436
monitor_r.region_info 41
monitor_r.pipeline_info 26
monitor_r.point_base_info 1500
两库分属时序引擎与关系引擎,五张表全部就位;裸实例的时序表承载 200 万行测点数据(关系表规模与课程容器相同)。完整回显见 evidence/02_verify.out。
提示:02_load.sh 采用"检测优先"策略——若目标实例已有数据,只校验行数、不做 DROP;仅当显式设置 KWDB_FORCE_RELOAD=1 时才重建。因此脚本可安全地对存量实例执行,不会误删数据。
4.3 四组跨模查询
以下四组 SQL 均来自官方 multi-mode/query.sql,覆盖从简单聚合到多表时间窗聚合的不同形态。
场景一:查询每个站点中采集类型为 1、采集数值高于 50、且采集条目多于 3 条的数据均值与条目数。
SELECT si.site_name,
       COUNT(t.monitor_value),
       AVG(t.monitor_value)
FROM monitor_r.site_info si,
     monitor_r.region_info wi,
     db_monitor.t_monitor_point t
WHERE wi.region_id = si.region_id
  AND si.site_id = t.site_id
  AND t.monitor_type = 1
  AND t.monitor_value > 50
GROUP BY si.site_name
HAVING COUNT(t.monitor_value) > 3
ORDER BY si.site_name;
场景二:按 10s 时间窗,查询三个区域内每个站点、某条管线在指定时间之后的各采集类型均值、最大最小值与条目数(关系表 4 张 + 时序表 1 张,共 5 表联结)。
SELECT wi.region_name,
       si.site_name,
       t.monitor_type,
       time_bucket(t.k_collect_time, '10s') AS timebucket,
       AVG(t.monitor_value) AS avg_value,
       MAX(t.monitor_value) AS max_value,
       MIN(t.monitor_value) AS min_value,
       COUNT(t.monitor_value) AS number_of_value
FROM monitor_r.site_info si,
     monitor_r.region_info wi,
     monitor_r.pipeline_info li,
     monitor_r.point_base_info pi,
     db_monitor.t_monitor_point t
WHERE li.pipeline_id = pi.pipeline_id
  AND pi.site_id = si.site_id
  AND si.region_id = wi.region_id
  AND t.point_id = pi.point_id
  AND li.pipeline_name = 'Pipe_3'
  AND wi.region_name in ('Area_8', 'Area_12', 'Area_16')
  AND t.k_collect_time >= '2023-08-01 01:00:00'
GROUP BY wi.region_name,
         si.site_name,
         t.monitor_type,
         timebucket;
场景三:按 1h 时间窗,查询每个区域中每条管线的条目数、累计值与均值。
SELECT
    time_bucket(t.k_collect_time, '1h') AS timebucket,
    s.region_id,
    w.region_name,
    pinfo.pipeline_name,
    COUNT(t.k_collect_time) AS measurement_count,
    SUM(t.monitor_value) AS total_measure_value,
    AVG(t.monitor_value) AS avg_measure_value
FROM
    db_monitor.t_monitor_point t,
    monitor_r.site_info s,
    monitor_r.region_info w,
    monitor_r.pipeline_info pinfo
WHERE
    t.region_id = s.region_id
    AND t.pipeline_id = pinfo.pipeline_id
    AND s.region_id = w.region_id
    AND t.k_collect_time BETWEEN '2023-01-04 14:31:00' AND '2030-01-04 14:31:00'
GROUP BY
    timebucket, s.region_id, w.region_name, pinfo.pipeline_name
ORDER BY
    timebucket, s.region_id
LIMIT 100;
场景四:按 5s 时间窗,查询某区域内每个站点、某条管线、每种采集类型的数值均值。
SELECT wi.region_name,
       si.site_name,
       t.monitor_type,
       time_bucket(t.k_collect_time, '5s') as timebucket,
       avg(t.monitor_value)
FROM monitor_r.point_base_info pi,
     monitor_r.pipeline_info li,
     monitor_r.region_info wi,
     monitor_r.site_info si,
     db_monitor.t_monitor_point t
WHERE pi.pipeline_id = li.pipeline_id
  AND pi.site_id = si.site_id
  AND si.region_id = wi.region_id
  AND pi.point_id = t.point_id
  AND li.pipeline_name = 'Pipe_9'
  AND wi.region_name = 'Area_7'
GROUP BY wi.region_name, si.site_name, t.monitor_type, timebucket;
实测输出(阶段 03,Playground 课程容器内执行四组查询):
场景一(52 行,节选)——返回 site_name / count / avg 三列:
site_name count avg
Station_0 19 590.1578947368421
Station_2 17 582.0588235294117
Station_3 12 526.4166666666666
Station_4 19 501.57894736842104
Station_5 19 445.05263157894734
...
(共 52 行)
场景二(16 行,节选)——5 表联结,返回 8 列(含 timebucket 与 avg / max / min / count):
region_name site_name monitor_type timebucket avg_value max_value
min_value number_of_value
Area_12 Station_d 2 2026-10-02 06:38:20+00:00 782 782 782 1
Area_12 Station_d 2 2026-10-02 05:49:50+00:00 793 793 793 1
Area_12 Station_d 2 2026-10-02 08:08:10+00:00 72 72 72 1
Area_12 Station_d 2 2026-10-02 08:27:00+00:00 249 249 249 1
...
(共 16 行)
场景三(100 行,节选,受语句末尾 LIMIT 100 约束)——返回 7 列:
timebucket region_id region_name pipeline_name measurement_count
total_measure_value avg_measure_value
2026-10-02 05:00:00+00:00 region_1 Area_1 Pipe_14 24 11892 495.5
2026-10-02 05:00:00+00:00 region_1 Area_1 Pipe_9 12 4740 395
2026-10-02 05:00:00+00:00 region_1 Area_1 Pipe_22 12 5184 432
2026-10-02 05:00:00+00:00 region_1 Area_1 Pipe_2 24 4080 170
...
(共 100 行)
场景四(6 行,节选)——官方固定取值 Pipe_9 + Area_7 在 Playground 的规范数据集上有效:
region_name site_name monitor_type timebucket avg
Area_7 Station_J 2 2026-10-02 06:18:25+00:00 453
Area_7 Station_J 2 2026-10-02 06:42:05+00:00 15
Area_7 Station_J 2 2026-10-02 07:46:30+00:00 596
Area_7 Station_J 2 2026-10-02 08:04:50+00:00 672
...
(共 6 行)
时间列为何是"当前时间":课程容器内的数据由 generate_data.sh 于本次导入时实时生成,因此 timebucket 落在执行当天(2026-10-02),而非官方材料的固定日期。这恰好是一处真实执行的可辨别特征——若你复测时看到的时间也是执行当日,说明数据确由本次运行生成。
四组结果对照(Playground 课程容器 vs 裸 KWDB 实例):
| 场景 | Playground(10,000 行样本) | 裸实例(200万行) | 结构是否一致 |
|---|---|---|---|
| 一 | 52 行 | 54 行 | ✅ 三列 site_name / count / avg |
| 二 | 16 行 | 5,343 行 | ✅ 八列,含 timebucket 与 avg / max/ min / count |
| 三 | 100 行 | 100 行 | ✅ 七列(两者均受 LIMIT 100 约束) |
| 四 | 6 行 | 0 行(空集) | ✅ 五列;取值有效性依数据集而异 |
注意(这是本文最想说明的一点):场景四的官方固定取值 Pipe_9 + Area_7,在 Playground的规范数据集下返回 6 行;而在裸实例那份派生数据下返回空集。同一条 SQL,两份数据集,结果不同——这不是语句问题,而是数据集分布差异。可复现承诺的边界正在这里:结构可复现,取值需按数据集核验。
为在裸实例上证明语句本身可返回非空,改用该实例中实际共现的一组取值 Pipe_26 + Area_35(先用 GROUP BY pipeline_name, region_name 统计确认交集存在),同一语句即返回10,778 行,见 evidence/03_query_s4b.out。同一场景在两地一空一满,正是"结构稳定、取值依数据"的双向印证。
提示:官方 create_load.sql 的时序表 TTL 子句写作 ACTIVETIME 3h,在 KWDB 3.2.2 上报syntax error (42601)——该关键字已被 RETENTIONS 取代。照抄官方原始脚本会卡在这一行;本文 4.2 节的建表 SQL 已按 3.2.2 写法给出,脚本包 02_load.sh 亦会自动完成替换。
四组完整回显见 evidence/03_query_pg_s1.out ~ 03_query_pg_s4.out(Playground)与03_query_s1.out ~ 03_query_s4b.out(裸实例)。"跨模联结在单实例内完成、返回融合结果集"这一结构性结论,由两个环境、四个场景一致证实。
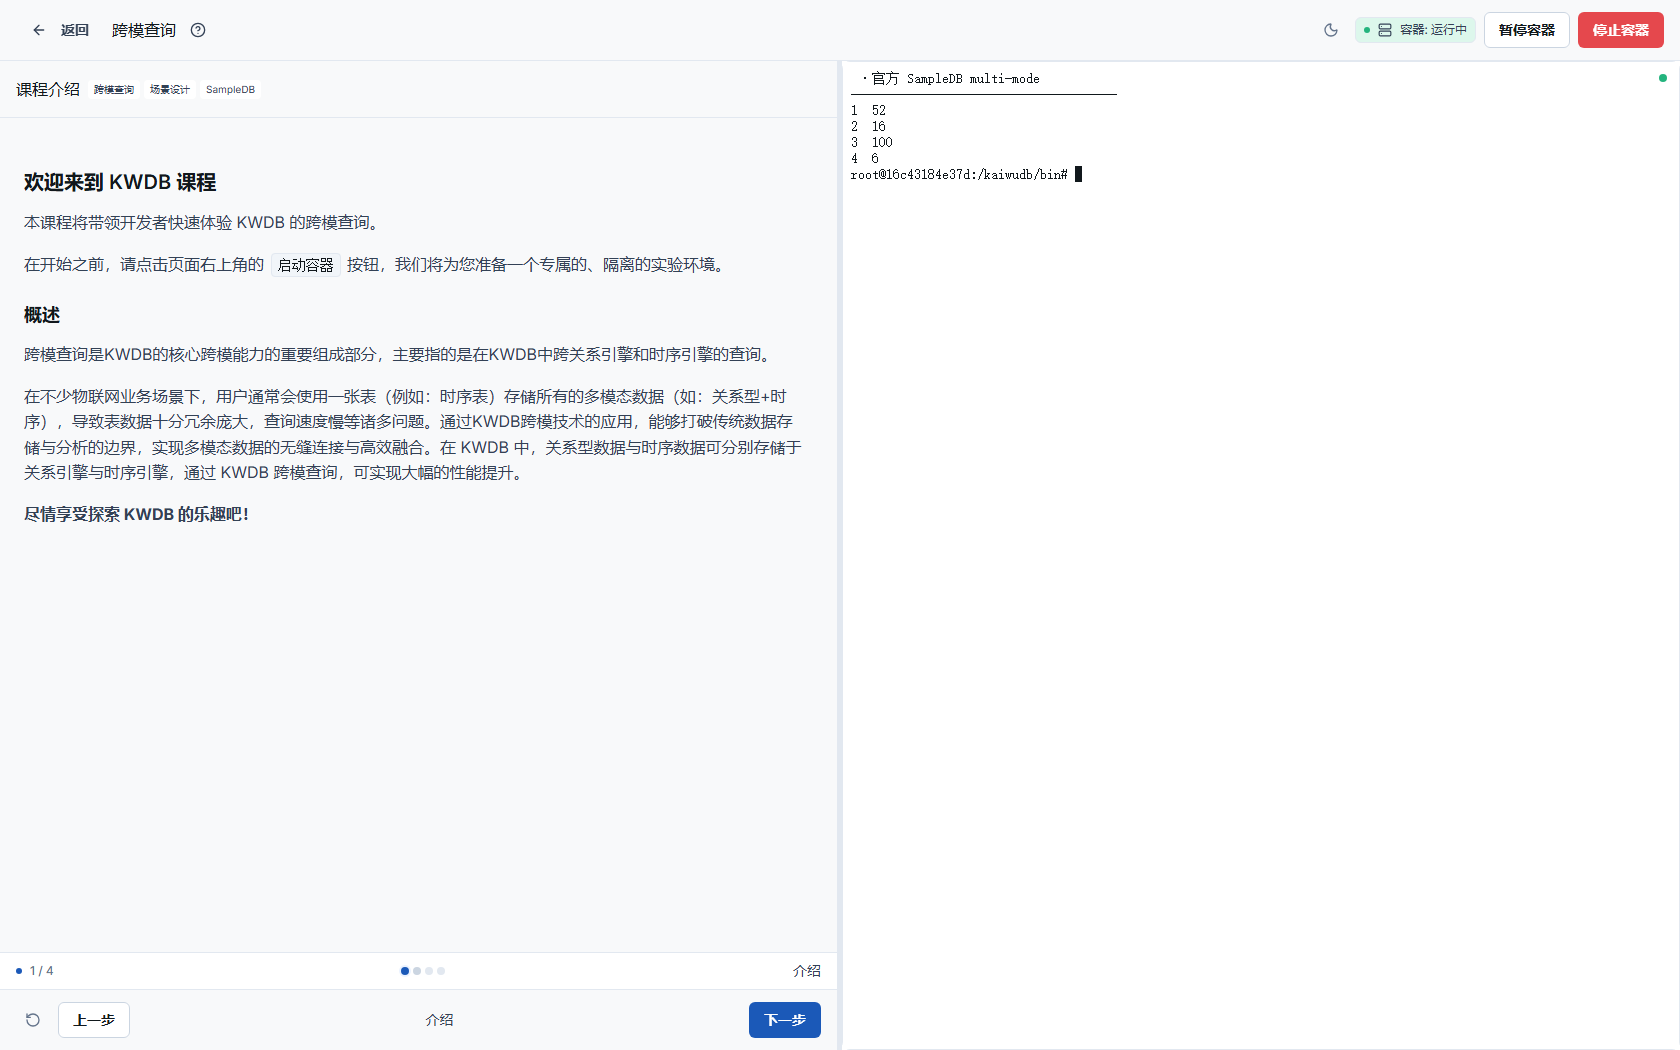
复测证据图 3 在 Playground 课程容器的 Shell 终端内批量执行四组查询,返回 52 / 16 / 100 / 6 行(截图中 场景N 数据行数 为去表头后的精确数据行数),证明跨模联结在同一实例内完成、返回融合结果集。
复测锚点:进入「跨模查询」课程 → 启动容器 → 在终端执行
for n in 1 2 3 4; do printf "场景%s 数据行数: " $n; \
./kwbase sql --insecure --host=127.0.0.1 --format=tsv < q$n.sql 2>&1 | tail -n +2 | grep -c .; done
期望输出依次为 52、16、100、6;q1.sql ~ q4.sql 由脚本包 03_query.sh 推入容器。
5 三终端联动:从 SQL 结果到一张图
5.1 为什么在同一页出图
跨模查询的返回是「分组 × 聚合列」的二维表。数据一多,读表效率骤降:几十行的时间桶、每桶若干统计量,人眼很难从数字里看出趋势。
传统做法是「在数据库侧导出结果 → 拷到本机 → 打开 Notebook 绘图」。这条链路有两个断点:导出与拷贝。导出格式、字段顺序、编码,任一处变化都会让图与查询脱钩,读者也就无法判断图到底对应哪一次运行。
Playground 的价值在于:取数与绘图都发生在它管理的容器内,读者不必把结果拷到自己的本机开发环境。图与查询出自同一份数据、同一套连接参数,可验证性由 evidence/ 下的回显保证。
5.2 Code 终端取数并绘图
本文在「Python 连接 KWDB」(python-kwdb)课程的 Code 终端内完成这一闭环。需先说明一处环境前提:该课程与「跨模查询」课程各自独立容器,跨模数据需先从 multi-mode 容器导出(create_load.sql + extern/ 数据目录),再 docker cp 进 python-kwdb 容器内导入——脚本包 reproduce/05_code_term.sh 已封装该步骤。
在 Code 终端编辑器中写入以下 Python 文件并点击「运行」(源码与脚本包 reproduce/plot_crossmode.py 一致):
# plot_crossmode.py —— 在 Playground 的 Code 终端内运行
import psycopg2
SQL = """
SELECT si.site_name,
       COUNT(t.monitor_value) AS cnt,
       AVG(t.monitor_value) AS avg_value
FROM monitor_r.site_info si,
     monitor_r.region_info wi,
     db_monitor.t_monitor_point t
WHERE wi.region_id = si.region_id
  AND si.site_id = t.site_id
  AND t.monitor_type = 1
  AND t.monitor_value > 50
GROUP BY si.site_name
HAVING COUNT(t.monitor_value) > 3
ORDER BY si.site_name
"""
conn = psycopg2.connect(host="127.0.0.1", port=26257,
                        user="root", dbname="defaultdb")
cur = conn.cursor()
cur.execute(SQL)
rows = cur.fetchall()
print("跨模查询返回行数:", len(rows))
for r in rows[:5]:
    print(" %-14s cnt=%-5s avg=%.4f" % (r[0], r[1], float(r[2])))
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
names = [r[0] for r in rows]
avgs = [float(r[2]) for r in rows]
plt.figure(figsize=(13, 5))
plt.bar(names, avgs, color="#2f6f9f")
plt.xticks(rotation=90, fontsize=8)
plt.ylabel("avg monitor_value")
plt.title("Cross-model query: avg monitor_value per site (type=1, value>50)")
plt.tight_layout()
plt.savefig("crossmode_avg.png", dpi=110)
print("已保存: crossmode_avg.png")
cur.close()
conn.close()
print("done")
注意(连接参数):课程容器默认以 --insecure 模式在 127.0.0.1:26257 提供 PG 线协议,用户 root、无密码;psycopg2 为镜像内置。跨模查询以全限定名(monitor_r.* / db_monitor.*)跨库访问,无需切换库。
提示(容器内缺库时):Code 终端支持 Python、Bash、Java 三种语言。若绘图所需的库缺失,可在容器内安装——注意镜像的 pip 受 PEP 668 约束,需加 --break-system-packages:
pip3 install matplotlib --break-system-packages
实测输出(阶段 04,Code 终端真实执行):
跨模查询返回行数: 52
前 5 行:
  Station_0 cnt=19 avg=590.1579
  Station_2 cnt=17 avg=582.0588
  Station_3 cnt=12 avg=526.4167
  Station_4 cnt=19 avg=501.5789
  Station_5 cnt=19 avg=445.0526
已保存: crossmode_avg.png
done
下图即上述 Code 终端运行原样产出的图(保存于容器内 /kaiwudb/bin/crossmode_avg.png,横轴为 52 个站点,纵轴为平均采集值)。
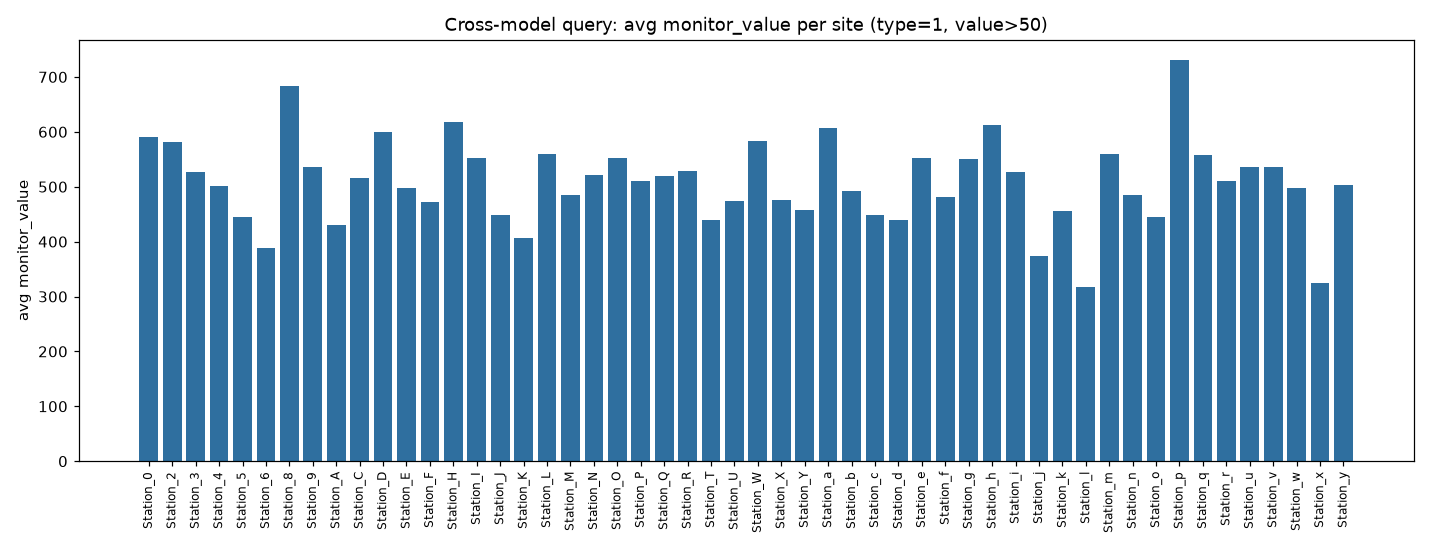
图 4 查询结果即图:同一容器内"取数—绘图"闭环的真实产物。
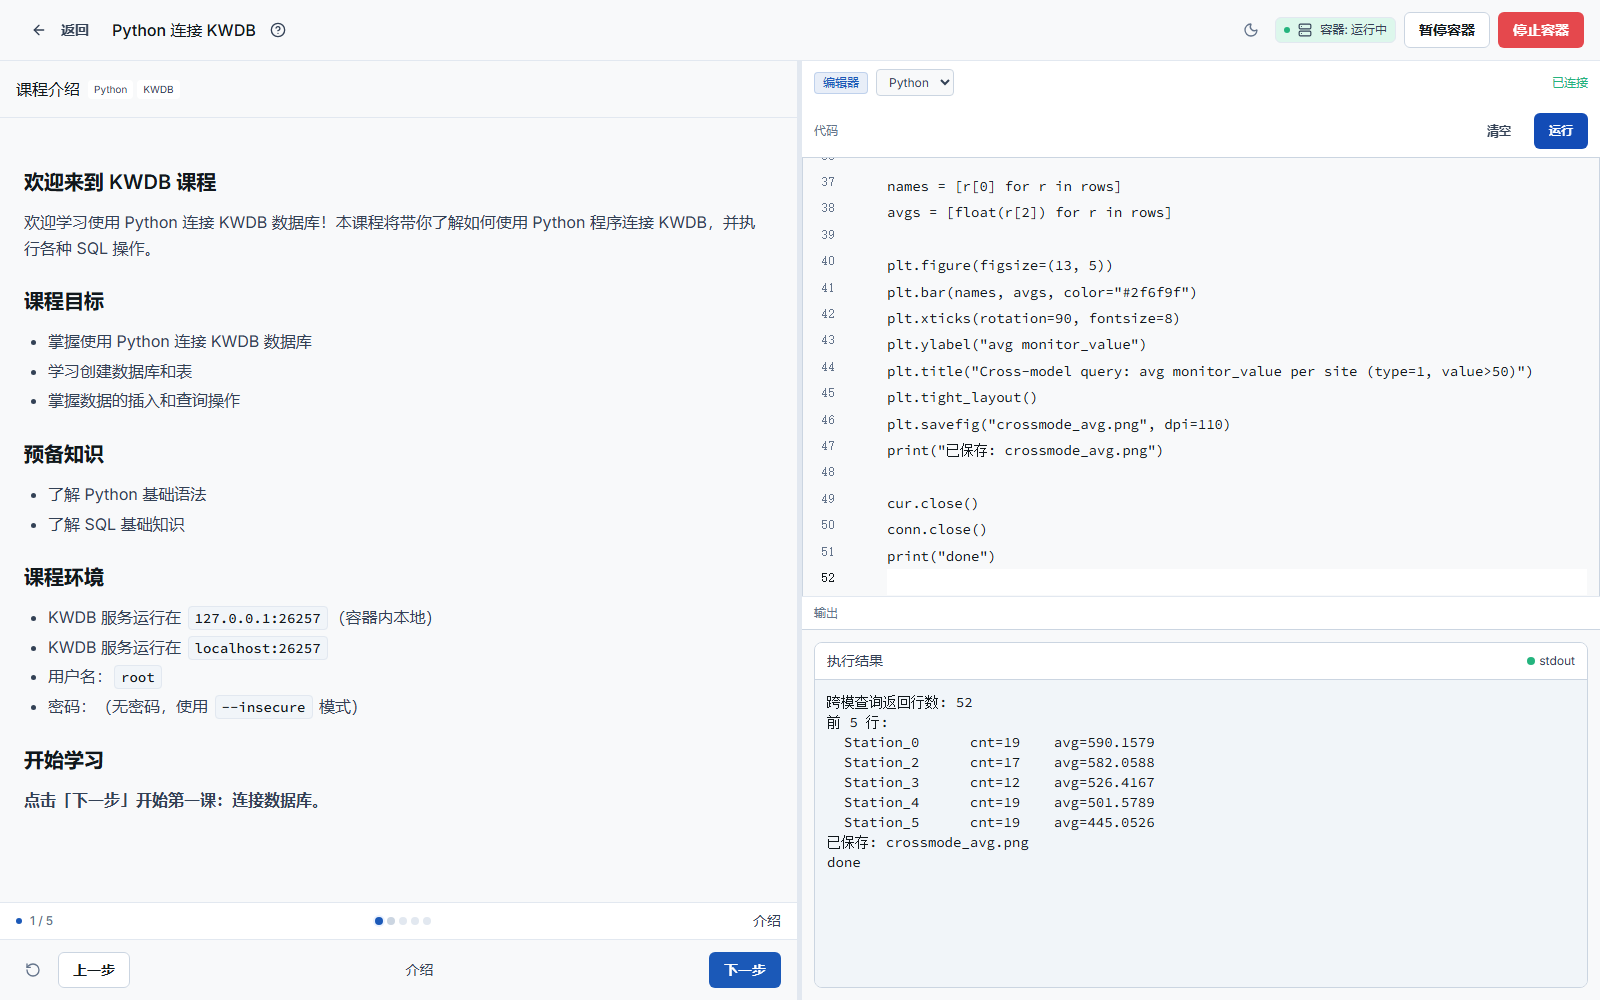
复测证据图 4 证明「查询 → 取数 → 出图」在同一容器内闭环完成:右侧编辑器为上述 Python 源码(可见 matplotlib 绘图段),下方输出面板打印 跨模查询返回行数: 52 与 已保存: crossmode_avg.png。
复测锚点(可照抄):在「Python 连接 KWDB」课程 Code 终端运行 reproduce/plot_crossmode.py,期望输出面板出现 跨模查询返回行数: 52 与 已保存: crossmode_avg.png;原始回显见 evidence/ch5-2-code-run_output.txt。
6 工程复盘:隔离式实验环境 vs 本地容器
6.1 一张对照表
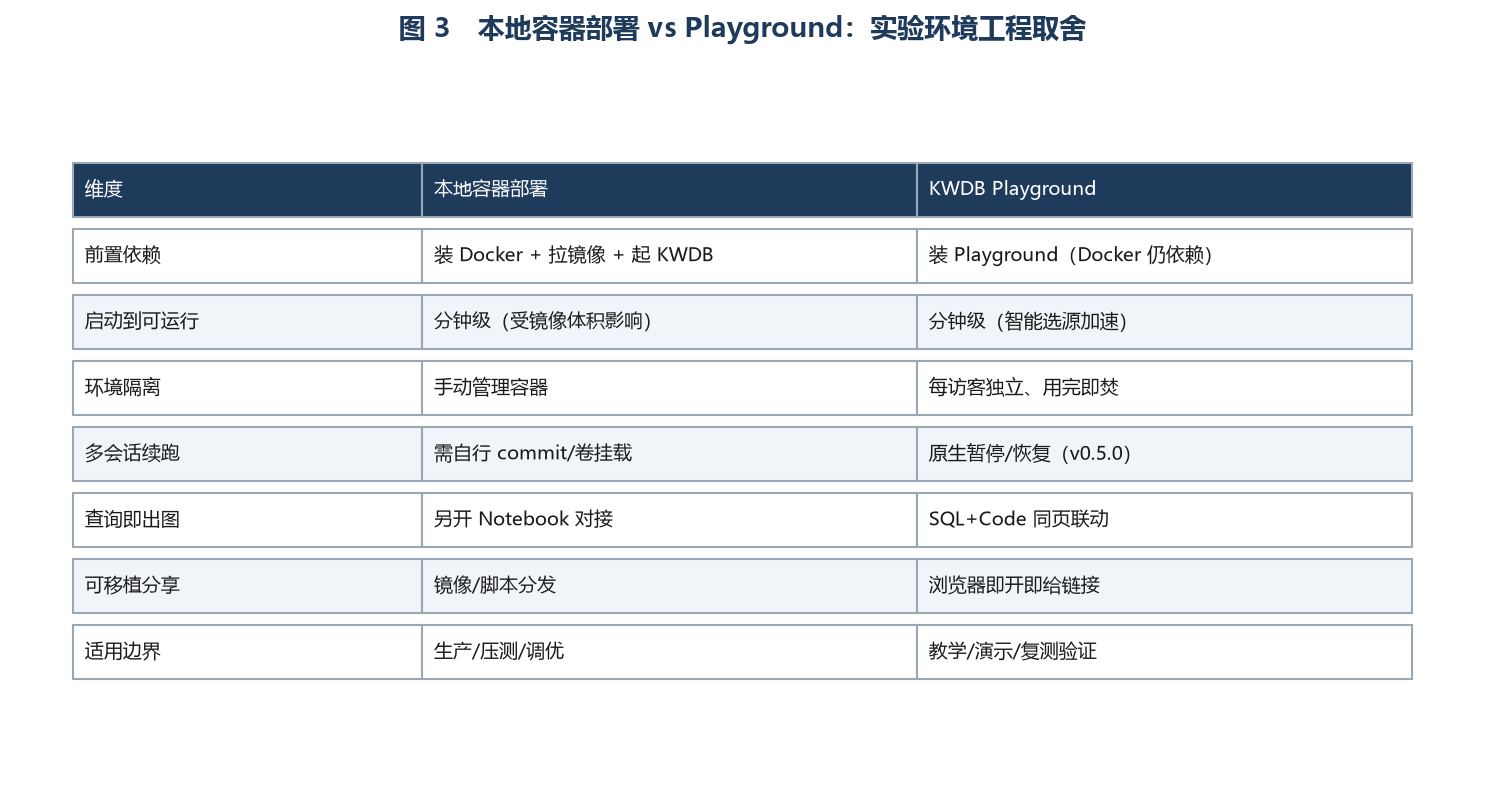
| 维度 | 本地容器部署 | KWDB Playground |
|---|---|---|
| 前置依赖 | 装 Docker + 拉 KWDB 镜像 | 装 Playground(仍依赖 Docker) |
| 启动到可运行 | 分钟级,受镜像体积影响 | 分钟级,智能选源加速 |
| 环境隔离 | 需手动管理容器 | 每访客独立、用完即弃 |
| 多会话续跑 | 需自行 commit 或卷挂载 | 原生暂停/恢复(实测 v1.4.3;官方文档记其于 v0.5.0 引入) |
| 查询即出图 | 另开 Notebook 对接 | SQL 终端 + Code 终端同页联动 |
| 可移植分享 | 分发镜像与脚本 | 浏览器即开即给链接 |
| 适用边界 | 生产、压测、调优 | 教学、演示、复测验证 |
6.2 复盘结论
第一,选择取决于目的。若目标是评估生产部署形态,本地容器(或直接部署)不可替代;若目标是让读者复现一次查询,Playground 的前置条件更少。
第二,两种方式的代价与风险不同。 本地容器把环境留在本机,便于反复试验,但要自己承担清理与版本管理;Playground 把环境交给平台,省去清理,但容器资源受限,不适合做性能结论。
第三,多会话带来的收益与实验长度成正比。 建表导入耗时越长,「暂停/恢复」的价值越大。短实验下这个属性几乎无感。
实测输出(阶段 05,暂停 / 恢复,实验机 kb-lab-01):
$ curl -X POST http://127.0.0.1:3006/api/courses/multi-mode/pause
$ docker ps -a --format "{{.Names}} | {{.Status}}"
kwdb-playground-multi-mode-1790890873878351895 | Up 31 minutes (Paused)
# —— 稍后恢复 ——
$ curl -X POST http://127.0.0.1:3006/api/courses/multi-mode/resume
$ # 在恢复后的终端内核对数据是否仍在
root@16c43184e37d:/kaiwudb/bin# ./kwbase sql --insecure --host=127.0.0.1 \
    -e 'SELECT count(*) AS points FROM db_monitor.t_monitor_point;'
points
10000
Time: 1.705714ms
暂停后容器状态为 Paused;恢复后终端自动重连,此前导入的 10,000 行数据仍在——环境状态被完整保存,读者可分次完成复测。
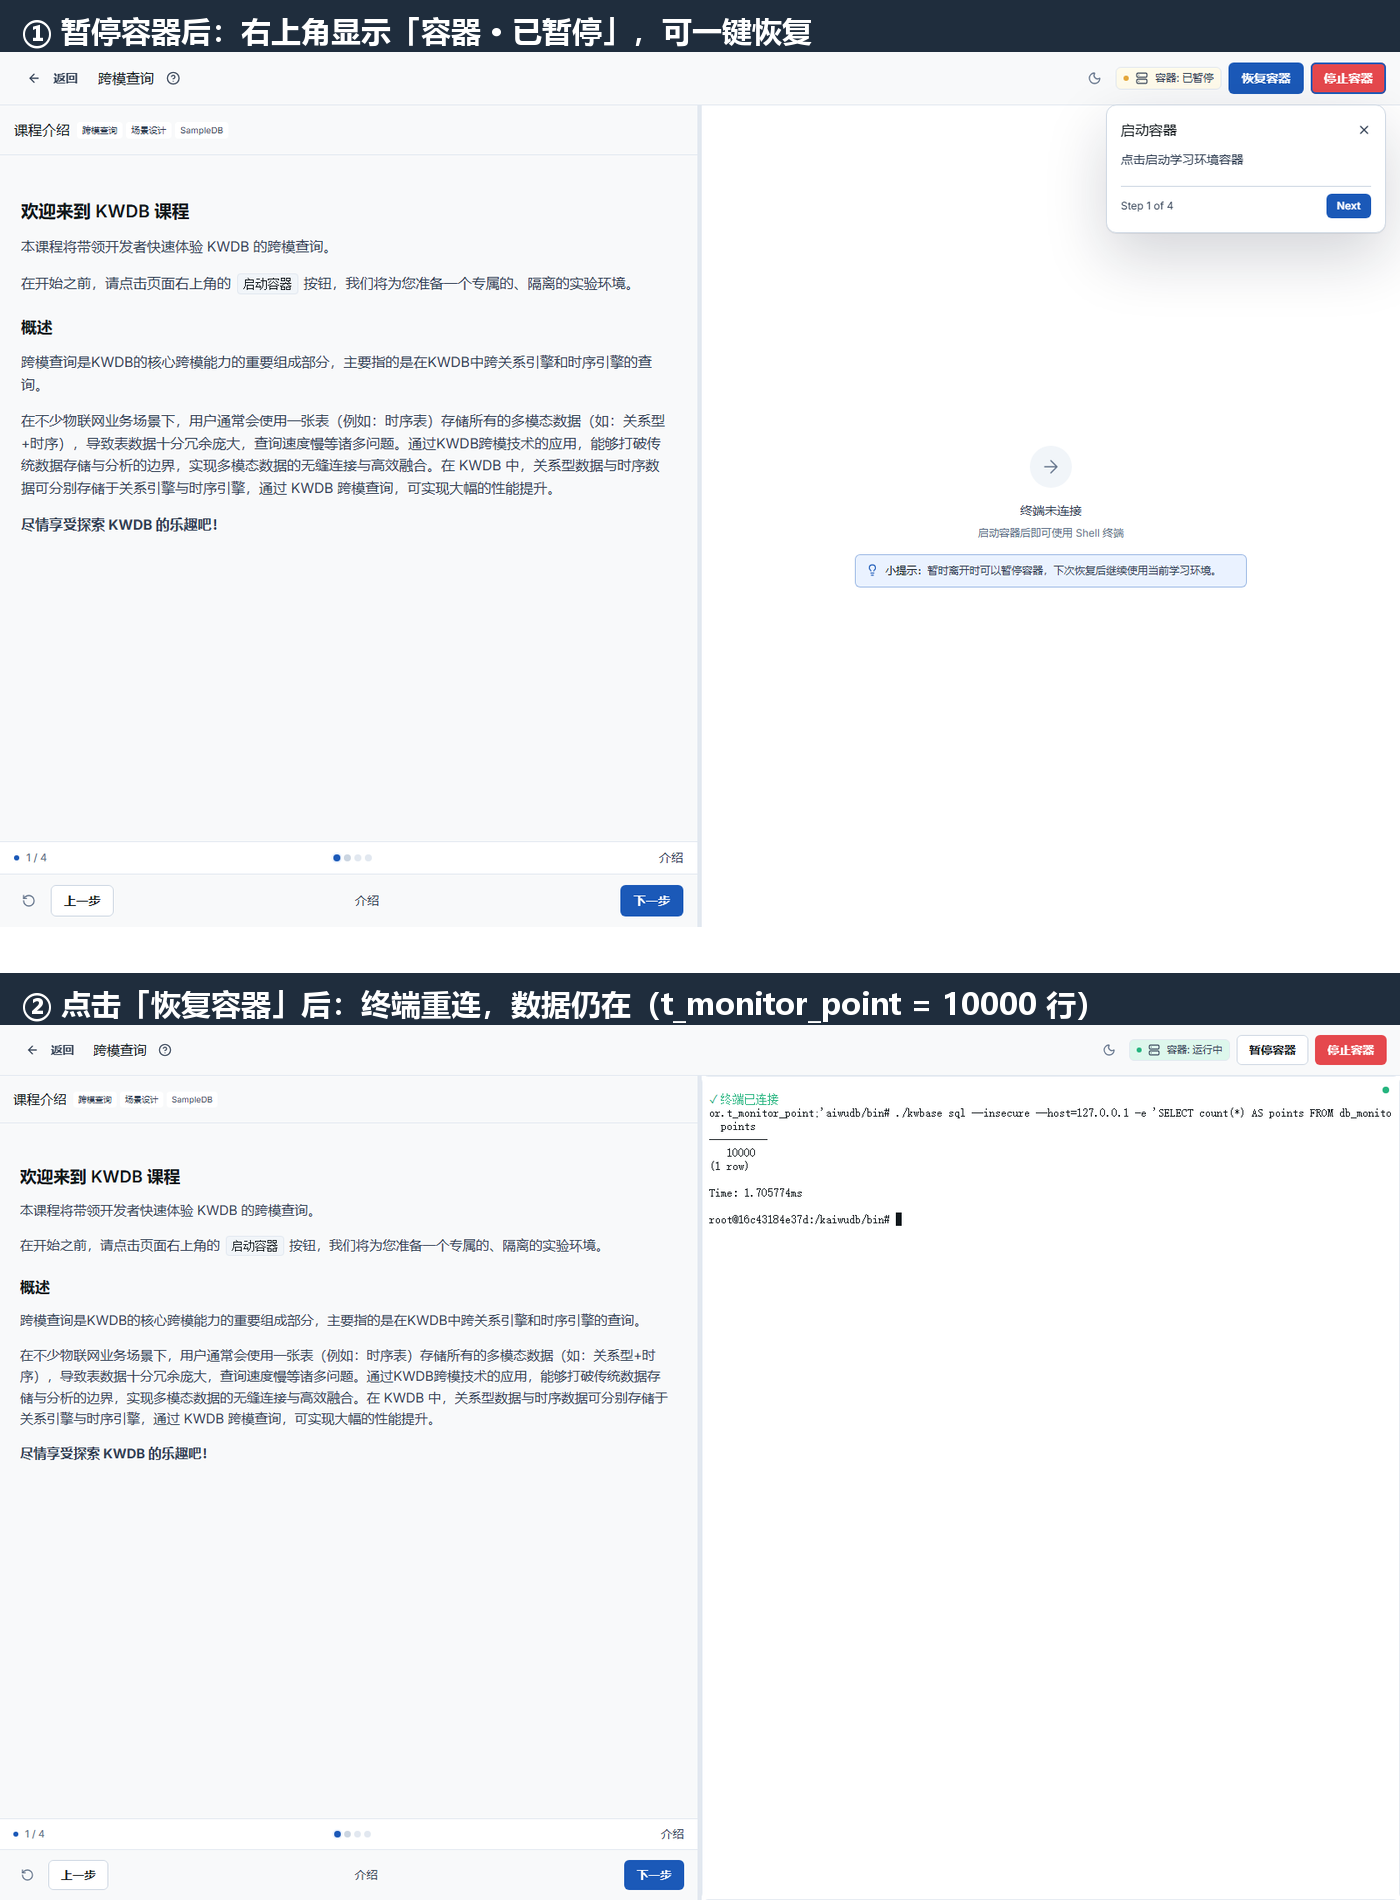
复测证据图 5 证明实验进度可保存与恢复,适配分次复测:上图为暂停态(右上角「容器 · 已暂停」+「恢复容器」按钮),下图为恢复态(「容器 · 运行中」,终端重连后 count = 10000)。
复测锚点(可照抄):课程页点击「暂停容器」→ 确认右上角显示「已暂停」→ 点击「恢复容器」→ 在终端执行
./kwbase sql --insecure --host=127.0.0.1 -e 'SELECT count(*) AS points FROM db_monitor.t_monitor_point;'
期望返回 10000(脚本包 05_resume.sh 已封装该检查)。
6.3 什么情况下不适用
结论先行:容器资源受限,Playground 得不出可外推的性能数字,因此不适合压测与容量评估。这条边界由运行形态决定,不是软件缺陷。
对比两种路径的成本结构,可以看出取舍所在。本地容器把维护成本留在使用者一侧,换来对环境的完全掌控;Playground 把这部分成本转移到平台,代价是对平台可用性的依赖,以及在资源调度上引入的不确定性。
判断是否需要它,可以看读者构成:若多数读者只想复现一个结论,隔离环境的收益大于代价;若多数读者打算在此基础上二次开发,本地容器更合适。这里的取舍与 2.4 节一致——两者服务的目标不同,不是相互替代关系。
7 复测取证单
本章是给复测者的对照表。每张证据图对应一条复测命令、一个文件名与一个正文插入位置。复测时应逐条执行、逐条落图;若某项判据不成立,停下并记录,不要继续。
7.1 截图位总表(表 A)
| 截图位 | 证据图 | 内容 | 复测命令 | 文件名 | 正文位置 |
|---|---|---|---|---|---|
| 1 | 图 1 | Playground 安装完成 | curl -fsSL https://kwdb.tech/playground.sh | bash |
figures/shots/shot-01-install.png |
3.2 节实测输出下方 |
| 2 | 图 2 | 启动与课程列表 | kwdb-playground start |
figures/shots/shot-02-start.png |
3.3 节实测输出下方 |
| 3 | 图 3 | 跨模查询实测输出 | SQL 终端执行场景一至四 | figures/shots/shot-03-sql-query.png |
4.3 节实测输出下方 |
| 4 | 图 4 | Code 终端出图 | Code 终端运行 plot_crossmode.py |
figures/shots/shot-04-code-plot.png |
5.2 节实测输出下方 |
| 5 | 图 5 | 多会话暂停/恢复 | 课程页暂停后重新进入 | figures/shots/shot-05-multisession.png |
6.2 节实测输出下方 |
7.2 成功判据
| 阶段 | 判据 | 本次实测值 |
|---|---|---|
| 00 | 终端出现 kwdb-playground 安装路径与版本号 | /usr/local/bin/kwdb-playground,v1.4.3 |
| 01 | 浏览器可打开 http://localhost:3006 且课程卡片可点击进入 | HTTP 200,12 门课程 |
| 02 | 4 张关系表与 1 张时序表均导入成功,SELECT count(*) 返回非零 | 时序 10,000 行;关系436/41/26/1500 |
| 03 | 四组查询均返回结果,含 timebucket 与聚合列 | 52 / 16 / 100 / 6 行 |
| 04 | 终端打印 已保存: crossmode_avg.png,页面可预览该图 | 返回 52 行并出图 |
| 05 | 暂停后容器为 Paused,恢复后数据仍在 | count = 10000 |
8 排障
下表每一行均为本次实测真实遇到的问题,附定位方法与处理方式。
| 现象 | 可能原因 | 处理 |
|---|---|---|
课程容器创建失败(接口返回 500),docker ps 无新容器 |
默认源 Docker Hub(registry-1.docker.io)不可达 |
启动课程时显式指定可达镜像源(阿里云 ACR 或 ghcr.io);见 3.3 节实测 |
建表报 at or near "activetime": syntax error (42601) |
KWDB 3.2.2 已用 RETENTIONS 取代 ACTIVETIME |
把官方 create_load.sql 中的 ACTIVETIME 3h 替换为 RETENTIONS 3h;脚本包已自动处理 |
| 启动「SQL 终端快速体验 KWDB」课程失败,提示端口被占用 | 该课程映射 26257,与主机上已有 KWDB 冲突 | 改用端口为 0(不映射)的课程,如 multi-mode 或 python-kwdb |
pip3 install 报 externally-managed-environment(PEP 668) |
镜像 Python 受系统包管理保护 | 追加 --break-system-packages,或在虚拟环境中安装 |
| 课程页停在「环境准备中」 | Docker 未运行或镜像未就绪 | 启动 Docker,点「环境检查」诊断,或切换镜像源 |
| 端口 3006 被占用 | 本机已有进程占用 | 按 Playground 提示改端口,或释放该端口 |
| 导入行数翻倍 | 重复执行导入 | 重新进入干净容器,或先清空同名表再导入 |
| Code 终端连不上数据库 | 客户端协议或参数不符 | 核对连接参数;改用「SQL 导出 CSV -> Code 读文件」路径 |
| 绘图中文显示为方块 | 容器缺中文字体 | 安装中文字体,或图内标签改用英文(本文即采用后者) |
| 场景四返回空集 | 官方固定过滤值在该数据集下无交集 | 属数据集分布差异,非语句错误;换用该数据集内共现的取值,见 4.3 节 |
注意:报错信息指向查询语句时,未必是查询的问题。跨模查询依赖两库与多张表,先确认建库建表与导入已成功,再排查 SQL。
附录 A 配套脚本包结构
kwdb_playground_crossmode/
├── env.sh # 唯一配置点:端口、容器名、KWDB 连接参数
├── 00_install.sh # 安装 Playground
├── 01_start.sh # 启动服务并检查课程页
├── 02_load.sh # 建库建表与导入(检测优先,默认不 DROP 存量数据)
├── 03_query.sh # 执行四组跨模查询(含实例校验变体 scenario4b)
├── 04_plot.py # 本地等价出图脚本(读 evidence/ 的回显文件绘图)
├── 05_code_term.sh # 为 Code 终端课程准备跨模数据(跨容器搬运)
├── plot_crossmode.py # 在 Playground Code 终端内运行的取数+绘图脚本
├── 05_resume.sh # 多会话暂停/恢复检查
├── sql/ # 官方四组查询 SQL(原样)+ 实例校验变体 scenario4b.sql
├── run_all.sh # 总控:支持 --list / 区间执行 / 失败即停
└── README.md
其中 plot_crossmode.py 与正文 5.2 节所列源码逐字一致;05_code_term.sh 封装了「跨容器搬数据 + 检测优先导入 + 装依赖」三步,是复现第 5 章的前置步骤。
运行方式:
bash run_all.sh # 从头到尾
bash run_all.sh --list # 列出阶段
bash run_all.sh 02 03 # 只跑 02–03
所有回显落盘至 evidence/,供回填正文与取证。
评论(0)