
自然语言生成 SQL 已经可以完成不少数据库查询,但面对累计指标时,真正困难的往往不是语法,而是指标定义。本文以 KaiwuDB 智能电表数据为例,记录一次从“描述需求”到“验证结果”的实践,并重点观察 AI 生成结果与业务含义之间的差距。
一、先定义要算的“用电量”
在电表监控场景中,数据库持续记录每块电表的采集数据。现在我们想回答一个很具体的问题:每个月所有电表一共消耗了多少电?如果进一步限定区域,还要统计华东大区每个月的总耗电量。
这类问题用自然语言表达很简单,但落到 SQL 时,至少要处理四件事:时间如何分组、累计值如何转成增量、同一块电表的采样记录如何聚合,以及区域档案如何参与筛选。为了把这些问题放在同一个实验里,我选择 KaiwuDB Playground,先让 AI 生成查询,再回到数据库中验证每一步的实际结果。
二、搭建一个可复现的实验现场
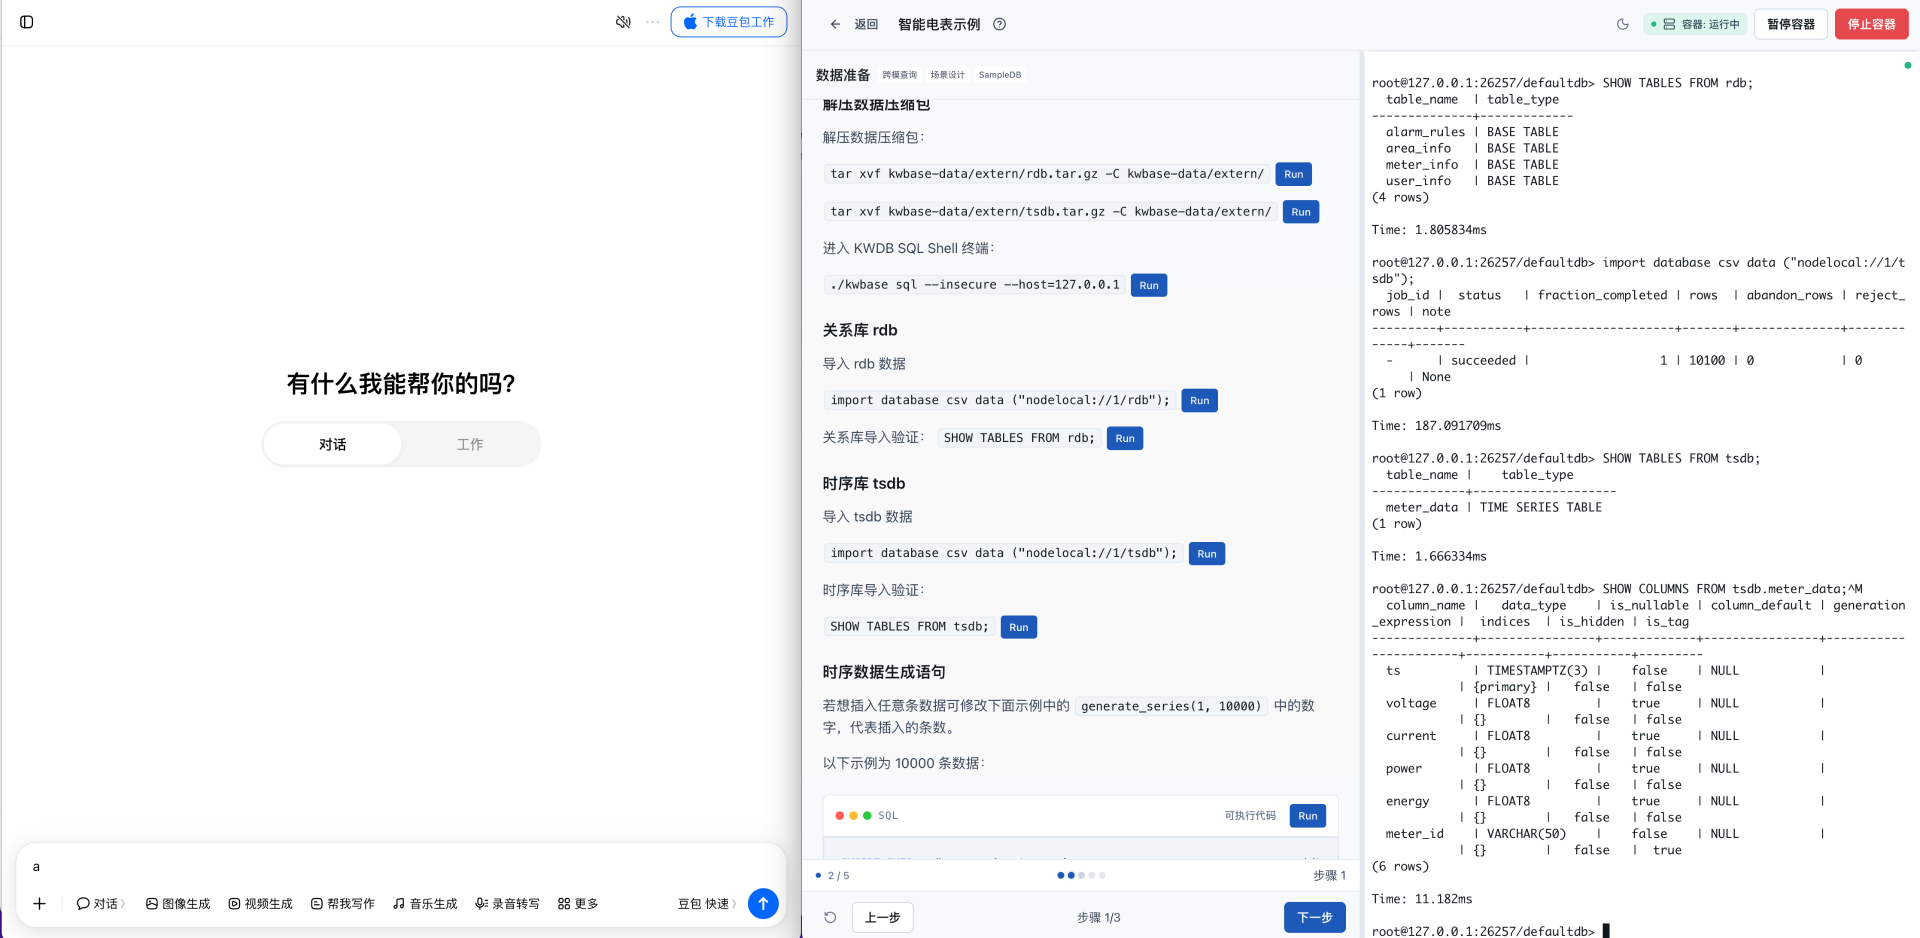
本次实验使用 KaiwuDB Playground。它提供了容器化的 KaiwuDB 环境,并配套智能电表示例。按照示例教程,我先解压数据压缩包,进入 KWDB SQL Shell,分别导入关系数据和时序数据,再通过查询确认数据已经准备完成。
环境准备并不是可有可无的开场步骤。只有关系数据和时序数据都成功导入,后面得到的查询结果才有验证价值;否则,SQL 是否正确和数据是否完整会混在一起,问题很难定位。
三、先让 AI 认识数据模型
我没有直接向 AI 提问“帮我算每月耗电量”,而是先把数据库中的表结构查清楚。对 NL2SQL 来说,模型拿到的上下文决定了它能否正确使用字段,也决定了后续生成的 SQL 是否具有可执行性。
电表的持续采集数据在时序表 tsdb.meter_data 中,字段包括:
ts:采集时间戳;voltage:电压;current:电流;power:瞬时功率;energy:累计电能;meter_id:电表编号,也是区分不同电表的时序标签。
我在容器终端执行:
SHOW COLUMNS FROM tsdb.meter_data;
电表的静态档案在关系表 rdb.meter_info 中,包含安装日期、电压等级、生产厂家、运行状态、区域 ID 和用户 ID:
SHOW COLUMNS FROM rdb.meter_info;
区域档案则在 rdb.area_info 中,包含区域名称、负责人和大区信息:
SHOW COLUMNS FROM rdb.area_info;
最终,我把三张表的字段、数据类型和关联关系整理成一段结构化说明,再交给 AI。这里特别注明 energy 是累计电能、meter_id 是电表标识、area_id 用于连接区域档案。相比只给出一句自然语言需求,这种输入方式更接近一份简化的数据字典。
四、第一个陷阱:累计值不等于当月用量
第一个问题只使用时序表:统计 tsdb.meter_data 中每个月的总耗电量,并按月份升序输出。
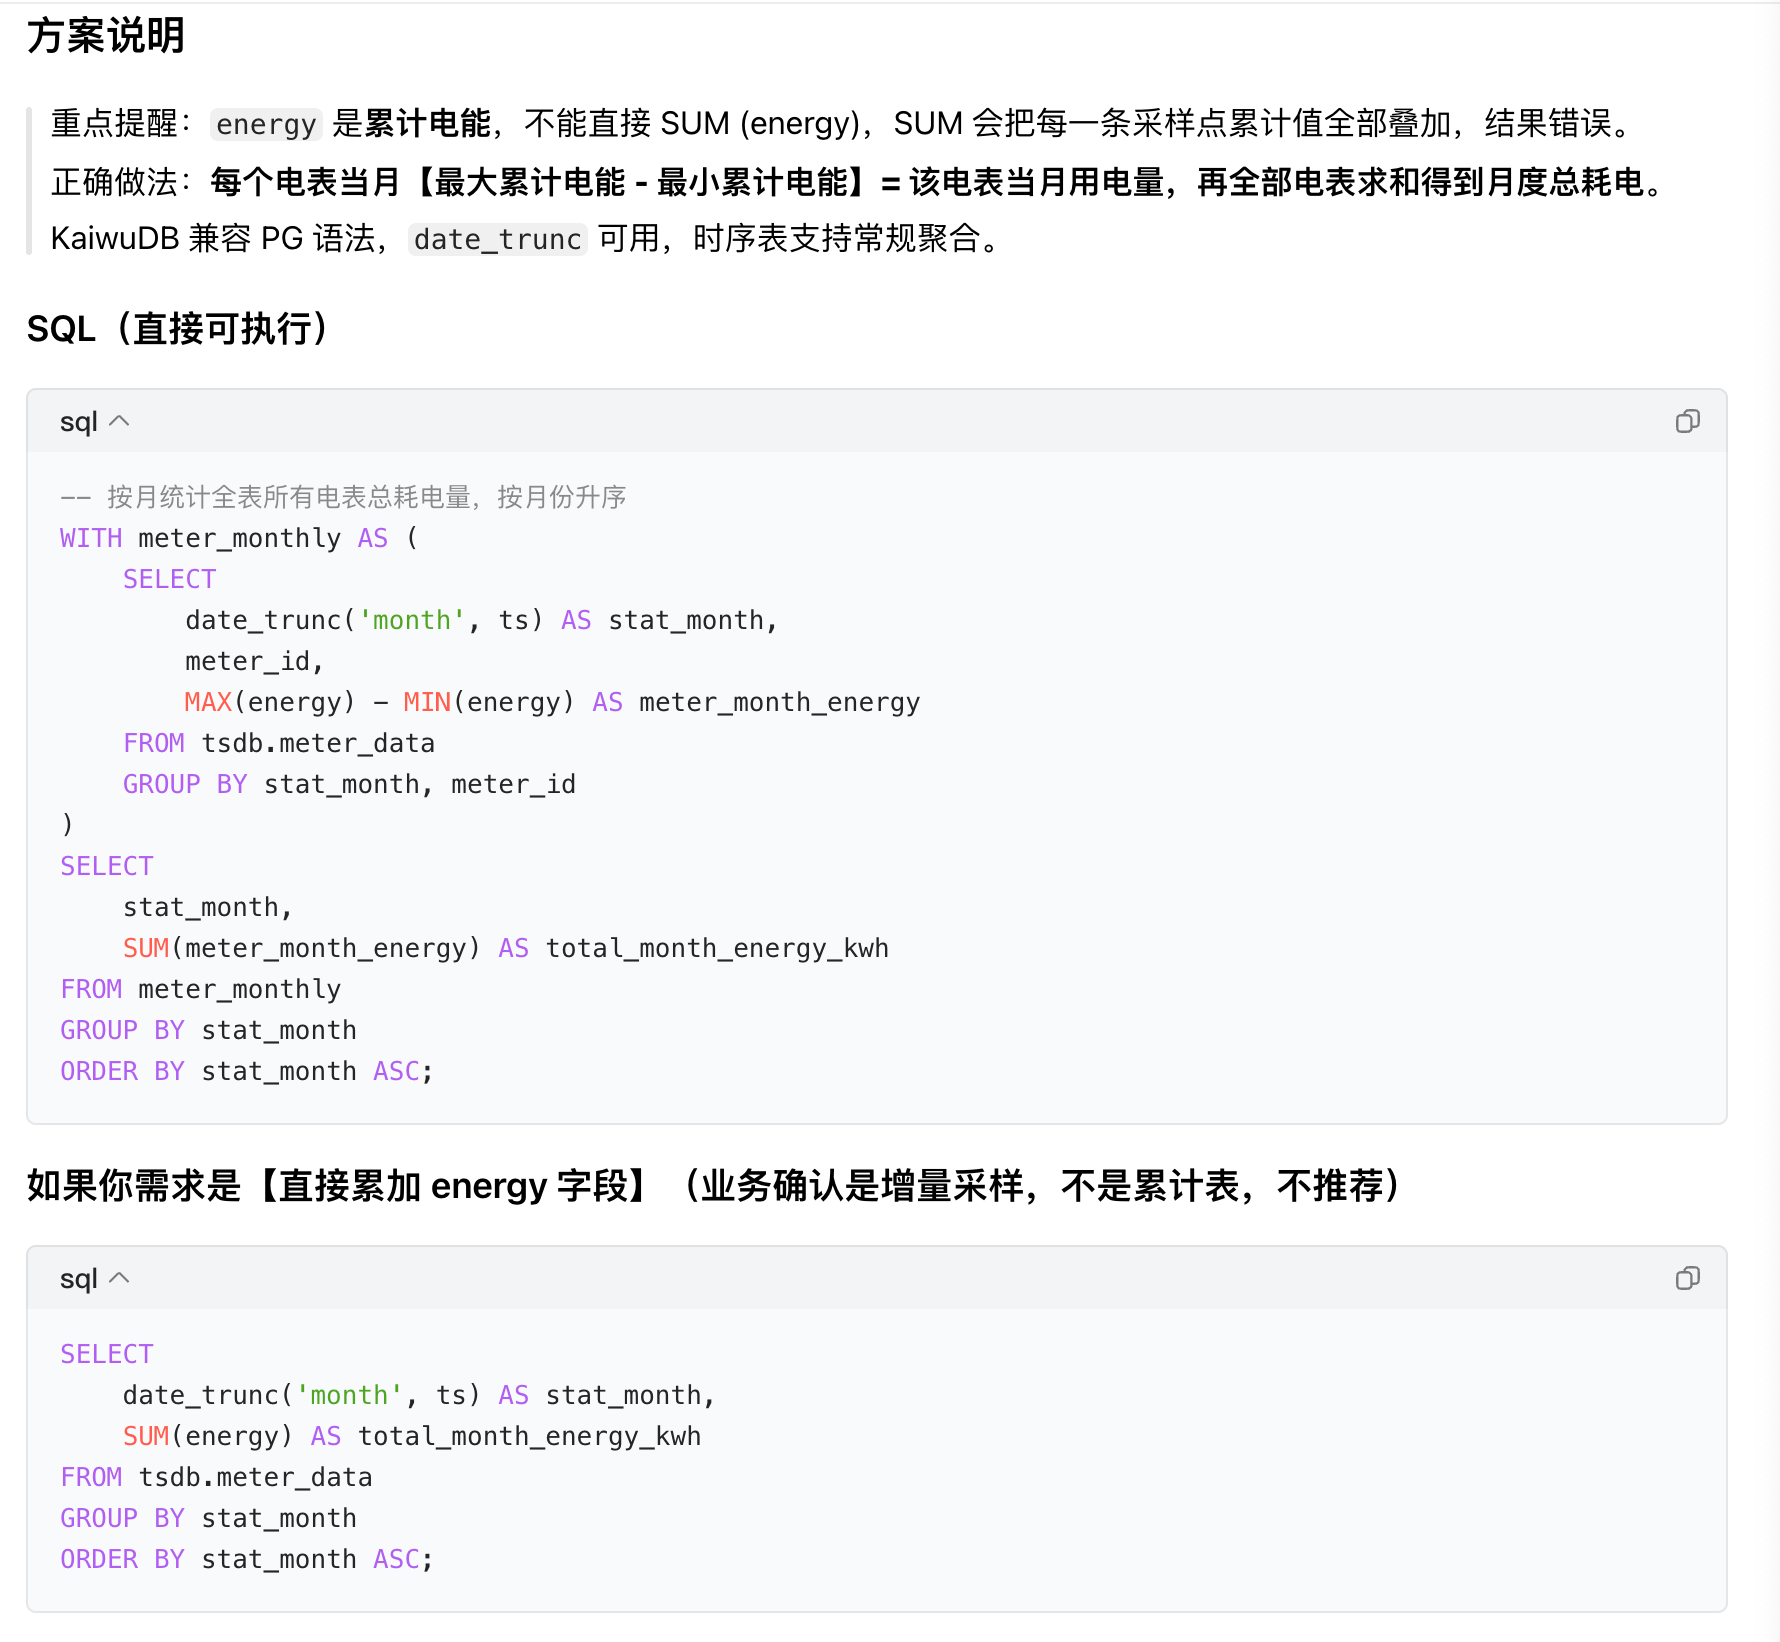
AI 很快生成了一条可以执行的 SQL。最初的方案直接对 energy 字段使用 SUM。从数据库语法角度看,这条语句没有问题,执行也不会报错,但它的业务逻辑是错误的。
原因在于,energy 不是每个采样周期新增的电量,而是电表当前的累计电能。如果一块电表在一个月内上报了很多次数据,直接 SUM(energy) 就会把同一块电表的累计值重复相加,得到一个明显偏大的结果。
正确的思路是:先按“月份 + 电表”计算单块电表当月的耗电量,再把所有电表的结果加总。对于累计电能字段,一块电表当月的耗电量可以用“当月最大累计值 - 当月最小累计值”得到。考虑到电表清零或数据回拨等异常情况,再用 GREATEST(..., 0) 避免出现负数。
WITH meter_monthly AS (
    SELECT
        date_trunc('month', ts) AS stat_month,
        meter_id,
        GREATEST(MAX(energy) - MIN(energy), 0) AS meter_month_energy
    FROM tsdb.meter_data
    GROUP BY stat_month, meter_id
)
SELECT
    stat_month,
    SUM(meter_month_energy) AS total_month_energy_kwh
FROM meter_monthly
GROUP BY stat_month
ORDER BY stat_month ASC;
这条 SQL 的关键不在于语句有多长,而在于计算粒度:CTE 内部先得到每块电表每月的增量,外层再得到全体电表的月度总量。date_trunc('month', ts) 将采集时间截断到月份,GROUP BY 完成按月、按电表聚合。
在 KaiwuDB 容器中运行后,得到 2025 年 1 月至 4 月的结果,分别为 343000、3932000、4364000 和 961000 kWh。整个查询耗时不到 20 毫秒。
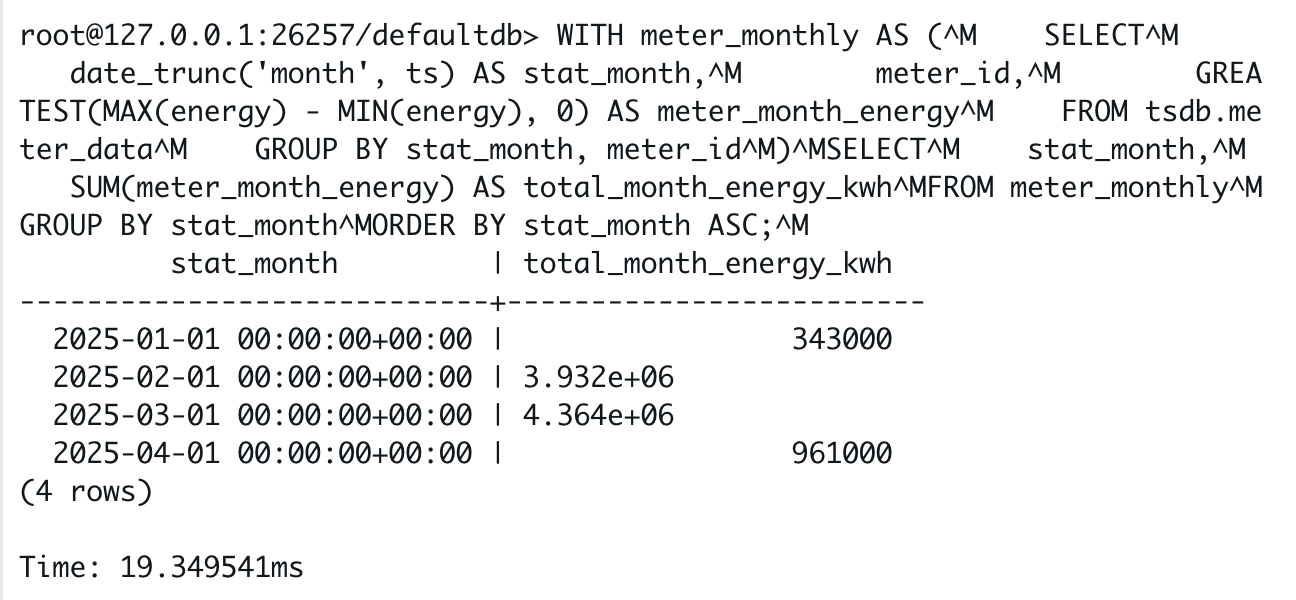
这个结果是整个实验最有价值的部分。AI 可以生成语法正确、执行成功的语句,但数据库不会替我们判断“累计电能应该怎样转成月度用量”。指标口径必须由人定义,再让 AI 帮助完成表达。
五、把区域档案 JOIN 进时序统计
有了正确的单表统计口径后,我把问题扩展为:只统计华东大区每个月的总耗电量。
这次查询需要同时使用三张表。时序表提供采集数据,rdb.meter_info 通过 meter_id 关联电表档案,rdb.area_info 再通过 area_id 找到区域,并用 region = 'East' 筛选华东大区。
WITH meter_monthly AS (
    SELECT
        date_trunc('month', ts) AS stat_month,
        meter_id,
        GREATEST(MAX(energy) - MIN(energy), 0) AS meter_month_energy
    FROM tsdb.meter_data
    GROUP BY stat_month, meter_id
)
SELECT
    mm.stat_month,
    SUM(mm.meter_month_energy) AS total_month_energy_kwh
FROM meter_monthly mm
INNER JOIN rdb.meter_info mi
    ON mm.meter_id = mi.meter_id
INNER JOIN rdb.area_info ai
    ON mi.area_id = ai.area_id
WHERE ai.region = 'East'
GROUP BY mm.stat_month
ORDER BY mm.stat_month ASC;
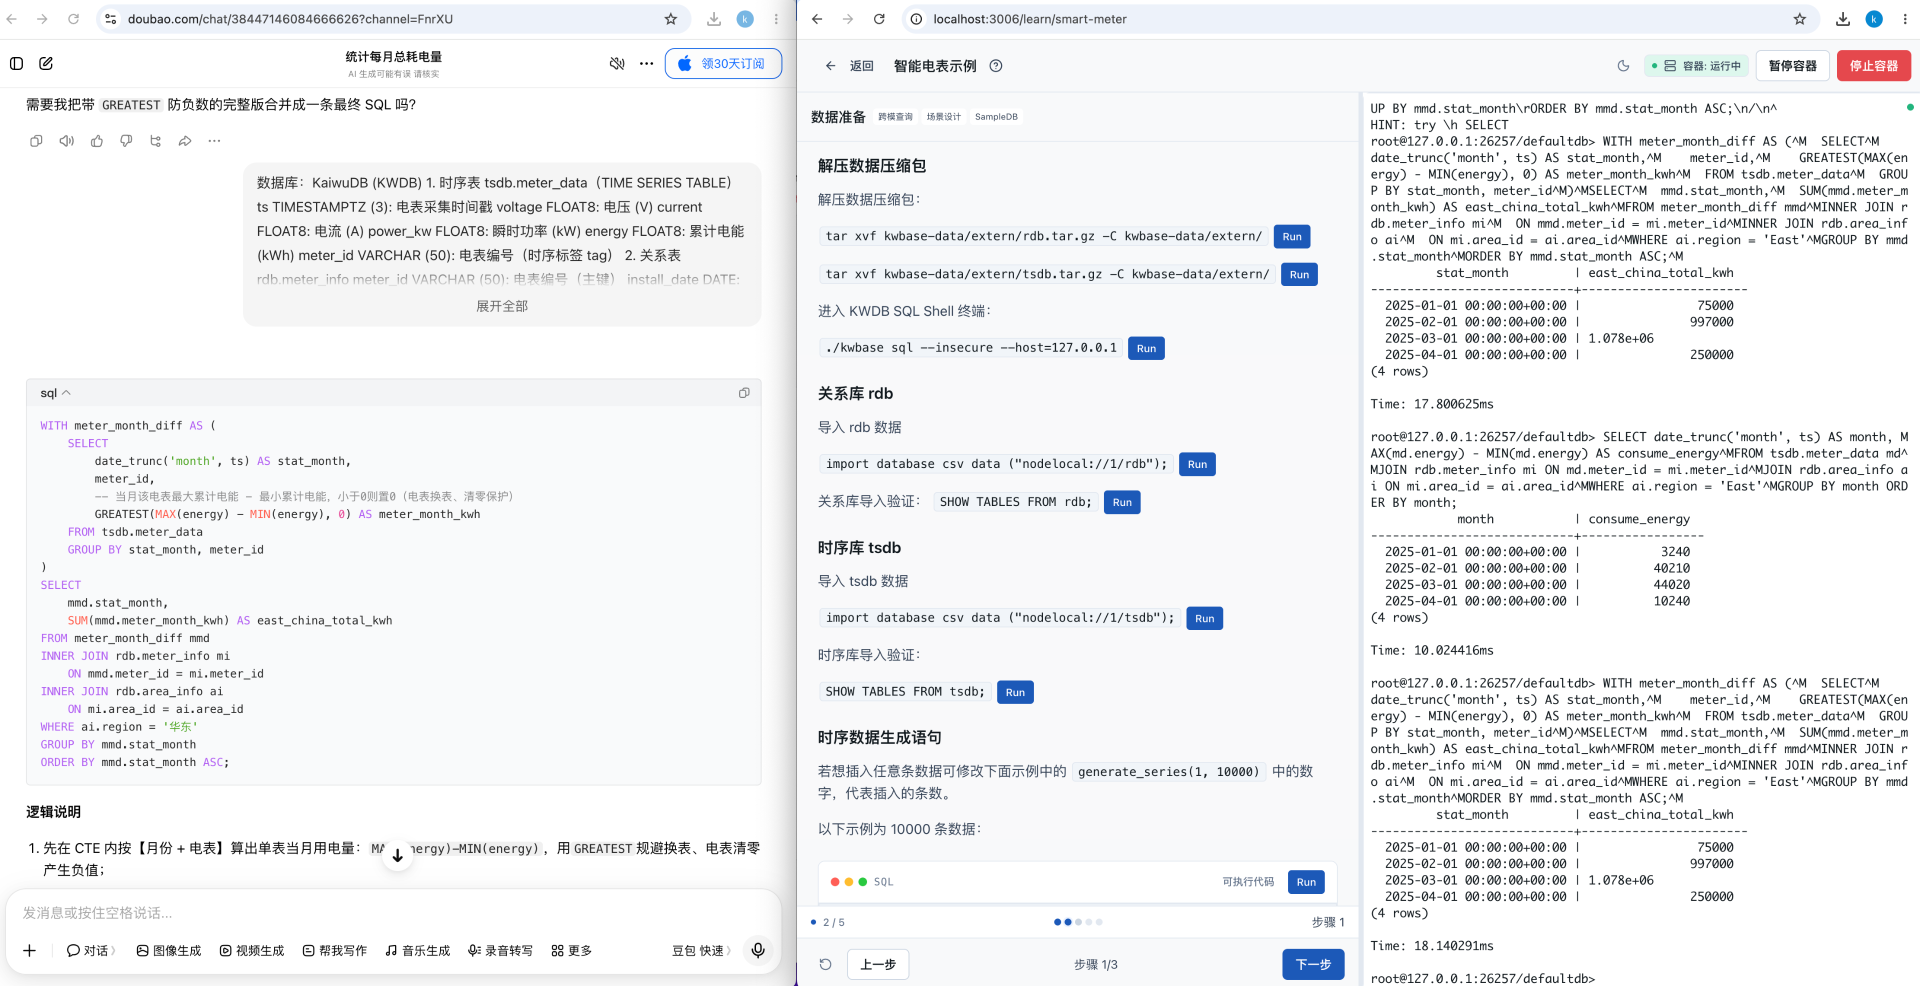
在传统架构中,时序数据库和关系数据库往往需要分别查询,再在应用层合并结果。KaiwuDB 将时序数据和关系数据放在统一的数据底座中,因此可以直接用一条 SQL 完成跨表 JOIN 和月度聚合。
执行结果显示,2025 年 1 月至 4 月华东大区的月度总耗电量分别为 75000、997000、1078000 和 250000 kWh。查询耗时约 18 毫秒。
六、从一次查询回看 AI 的边界
第一,AI 生成 SQL 的准确度高度依赖输入的表结构。如果表名、字段名、数据类型或关联关系写错,生成的 SQL 可能直接执行失败。
第二,即使表结构完全正确,AI 仍然可能误解业务含义。累计值、增量值、快照值和采样值在统计方式上完全不同,模型不能替代业务判断。本文中直接 SUM(energy) 的错误,就是一个典型例子。
第三,AI 生成 SQL 后必须进行最基本的人工检查:确认表名和字段名,确认 JOIN 条件,确认聚合粒度,确认指标的业务含义,并在测试环境执行验证。尤其不能把未经检查的 SQL 直接放到生产环境中运行。
七、结语:让 AI 写代码,让人定义正确
这次实验并不是为了证明 AI 可以完全取代 SQL 开发,而是验证一条更稳妥的工作路径:先定义指标和数据口径,再把完整表结构交给 AI,让它快速生成 SQL,最后由人完成业务校验和结果验证。
KaiwuDB Playground 让这条链路变得很直观:表结构可以在容器中即时查看,AI 生成的 SQL 可以直接复制执行,时序表与关系表也可以在同一条语句中完成联合分析。对于学习数据库、验证查询思路和搭建数据应用原型,这种方式很高效。
但效率的前提是边界清楚。AI 擅长把自然语言转换成代码,却不一定理解指标背后的业务定义。真正可靠的结果,来自 AI 的生成能力、KaiwuDB 的执行能力,以及开发者对数据和业务的人工判断三者结合。
评论(0)